
 Nodaro ドキュメント
動画生成 Pro
プロンプトや脚本から、長い AI 動画を 1 本作ります。動画生成 Pro は、動画をモデルに合った長さのセグメントに分け、順番にレンダリングして、1 本のクリップにつなぎ合わせます。
Nodaro Cloud で利用できます
動画生成 Pro(Generate Video Pro)ノードは、プロンプトや脚本から長い動画を 1 本作ります。モデルを 1 回実行して作れる長さを超える秒数を指定すると、ノードはリクエストをモデルに合った長さのセグメントに分割し、1 つずつ順番にレンダリングして、1 本のクリップにつなぎ合わせます。モデルは自分で選びます。セグメントの長さと解像度は、モデルごとに異なります。
動画生成 Pro は Nodaro Cloud で実行されます。セルフホスティング環境では、ノードに NODARO マークが表示され、Nodaro Cloud との接続を通じて実行されます。料金は、接続したアカウントに請求されます。
使いどころ
- モデルの 1 回の実行より長い、1 本の連続した動画を作ります。たとえば、60 秒のストーリーや、曲をまるごと使ったミュージッククリップです。
- 長い脚本や動画分析(Video Analysis)の結果を、テキストに沿ったショットに分割します。
- 既存のクリップの続きを、さらに長く作ります。クリップを延長元に接続します。
- 動画の料金を払う前に、長い脚本がどう分割されるかを確認します。プランのみをオンにします。
1 回の実行に収まる 1 本のクリップには、動画生成(Generate Video)を使います。つなぎ合わせの手数料がかからないので料金が安く、動画の編集を含むすべてのモードを使えます。
クイックスタート
ノードを追加する
キャンバス上で Tab を押し、動画 › 作成 › 動画生成 Pro を選びます。
プロンプトまたは脚本を書く
設定パネルにプロンプトを入力するか、テキスト(Text)ノードか脚本生成(Generate Script)ノードをプロンプトに接続します。プロンプトは動画全体に使われるので、起こることをすべて順番に書いてください。
人物・場所と冒頭のフレームを接続する
キャラクターアセット(Character Asset)ノードとロケーションアセット(Location Asset)ノードをアセットに接続すると、すべてのセグメントで同じ顔と場所が保たれます。冒頭のショットを固定するには、画像を開始フレームに接続します。
モデルと長さを設定する
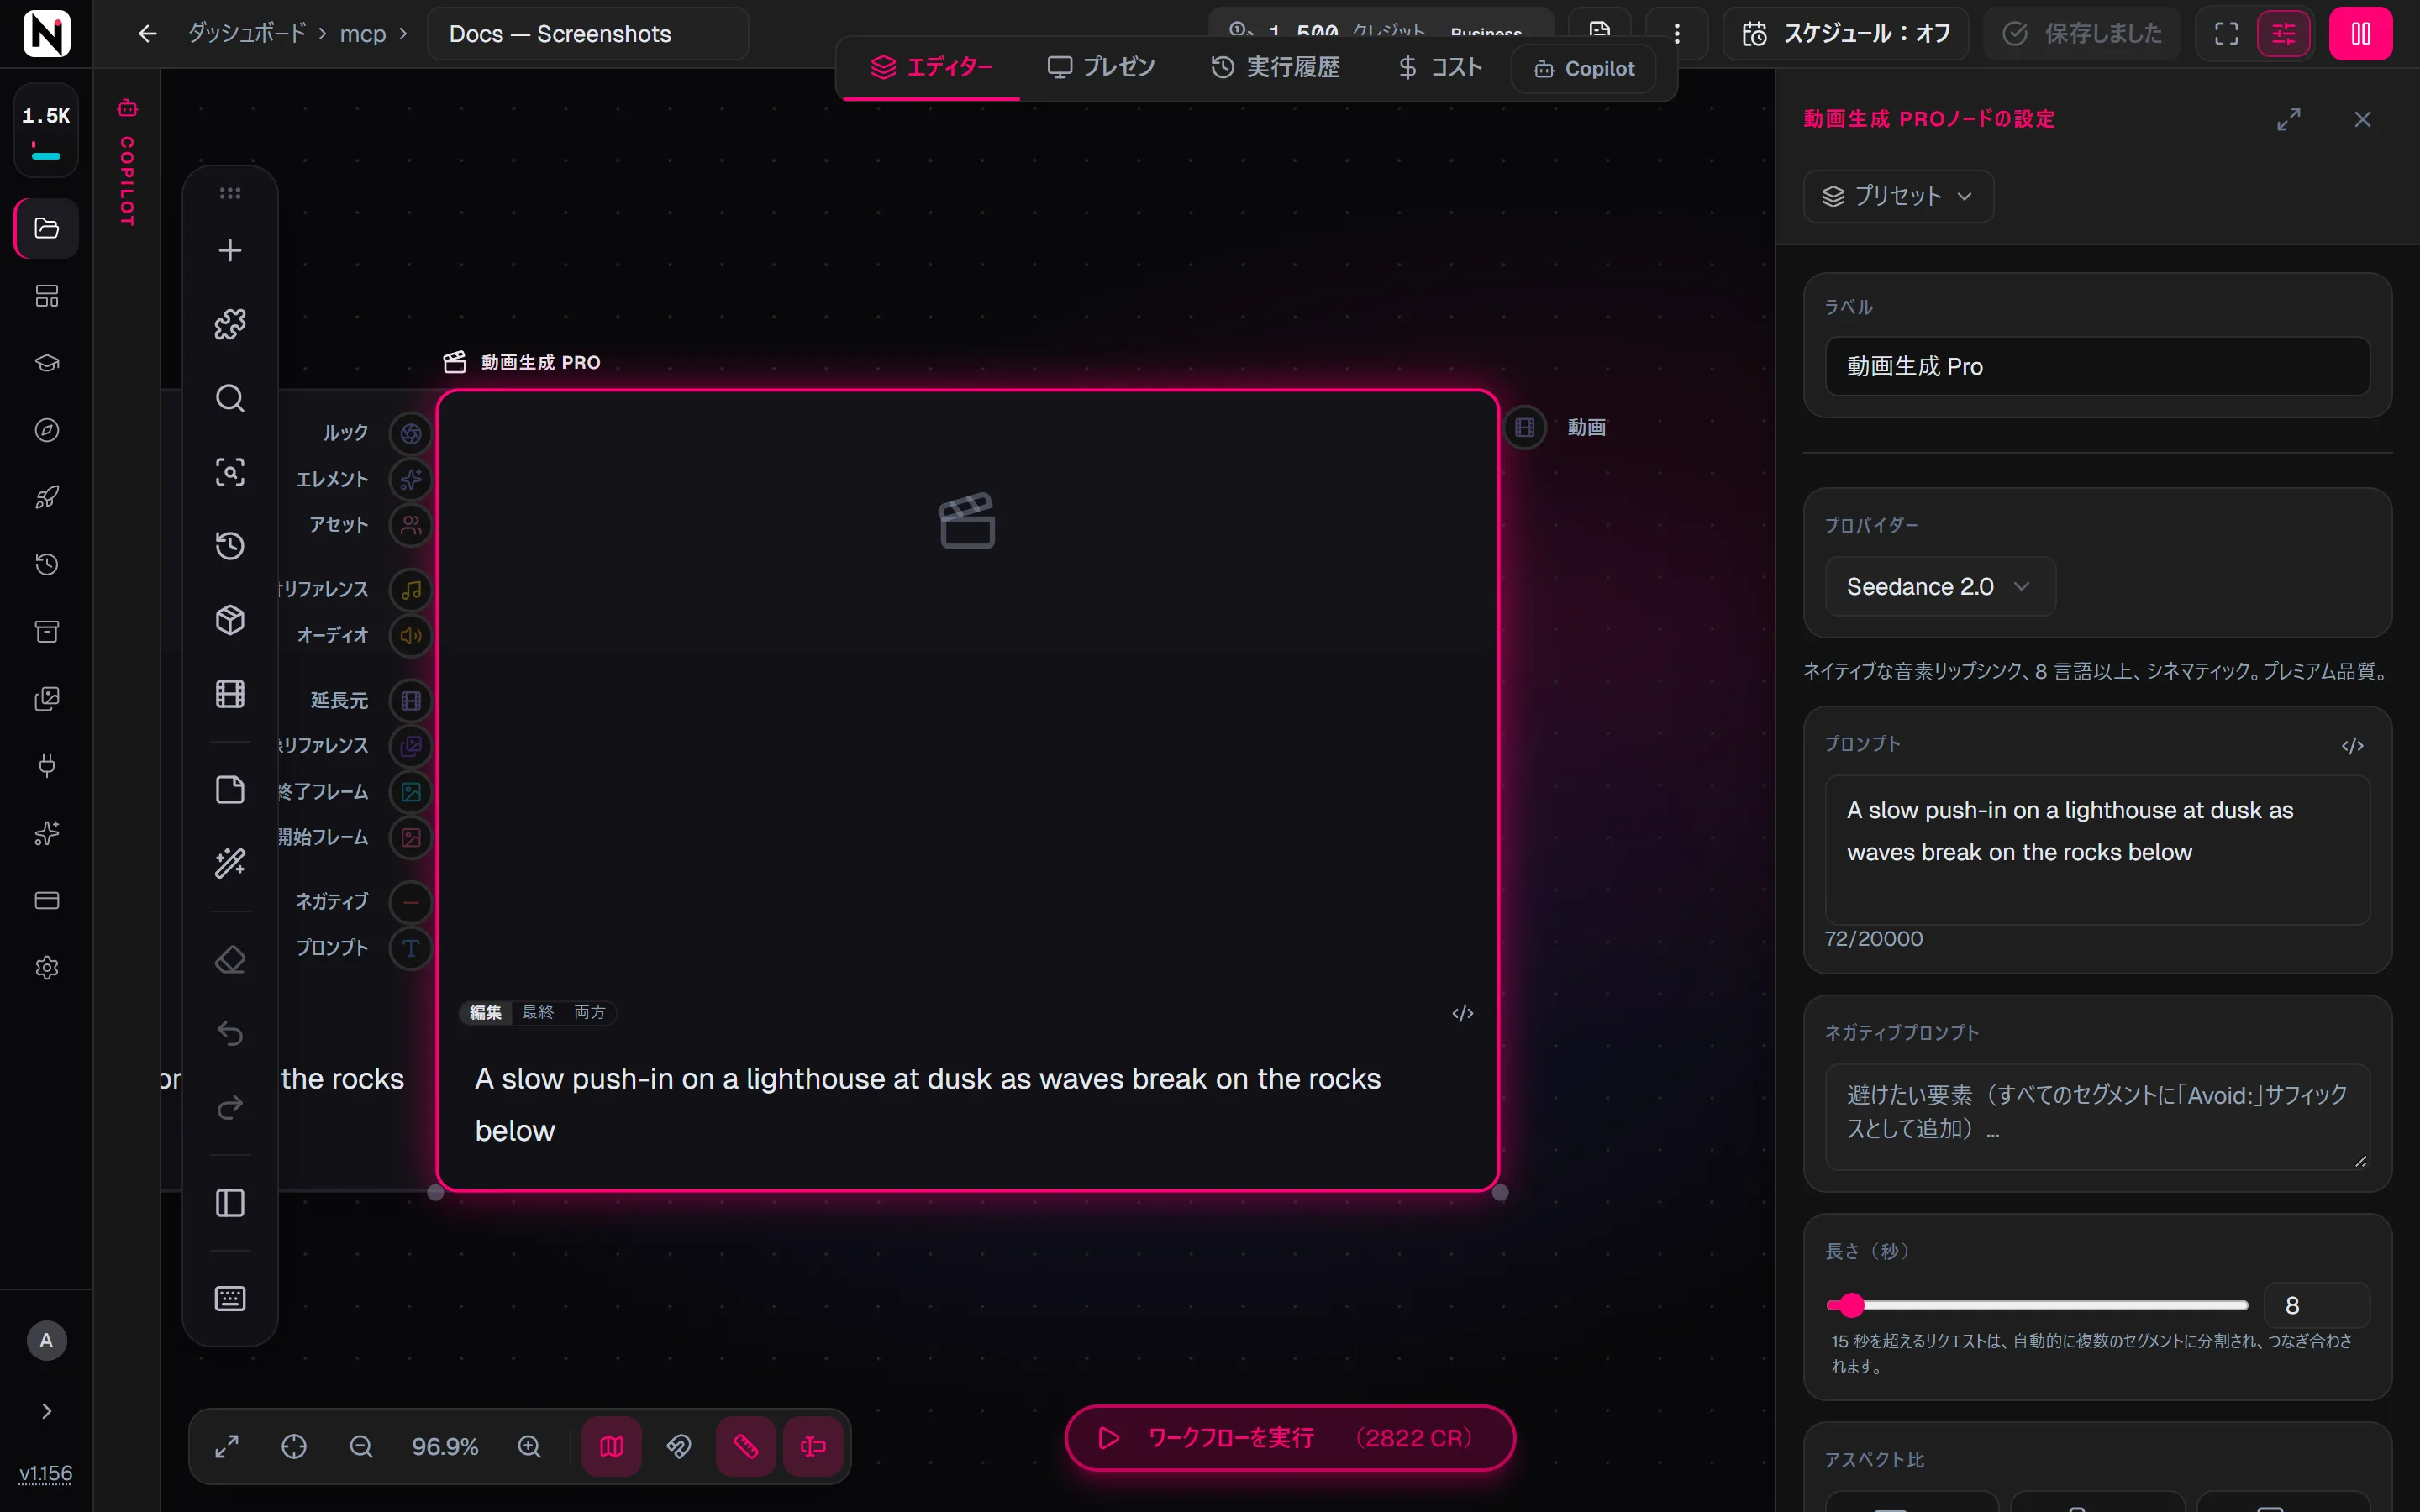
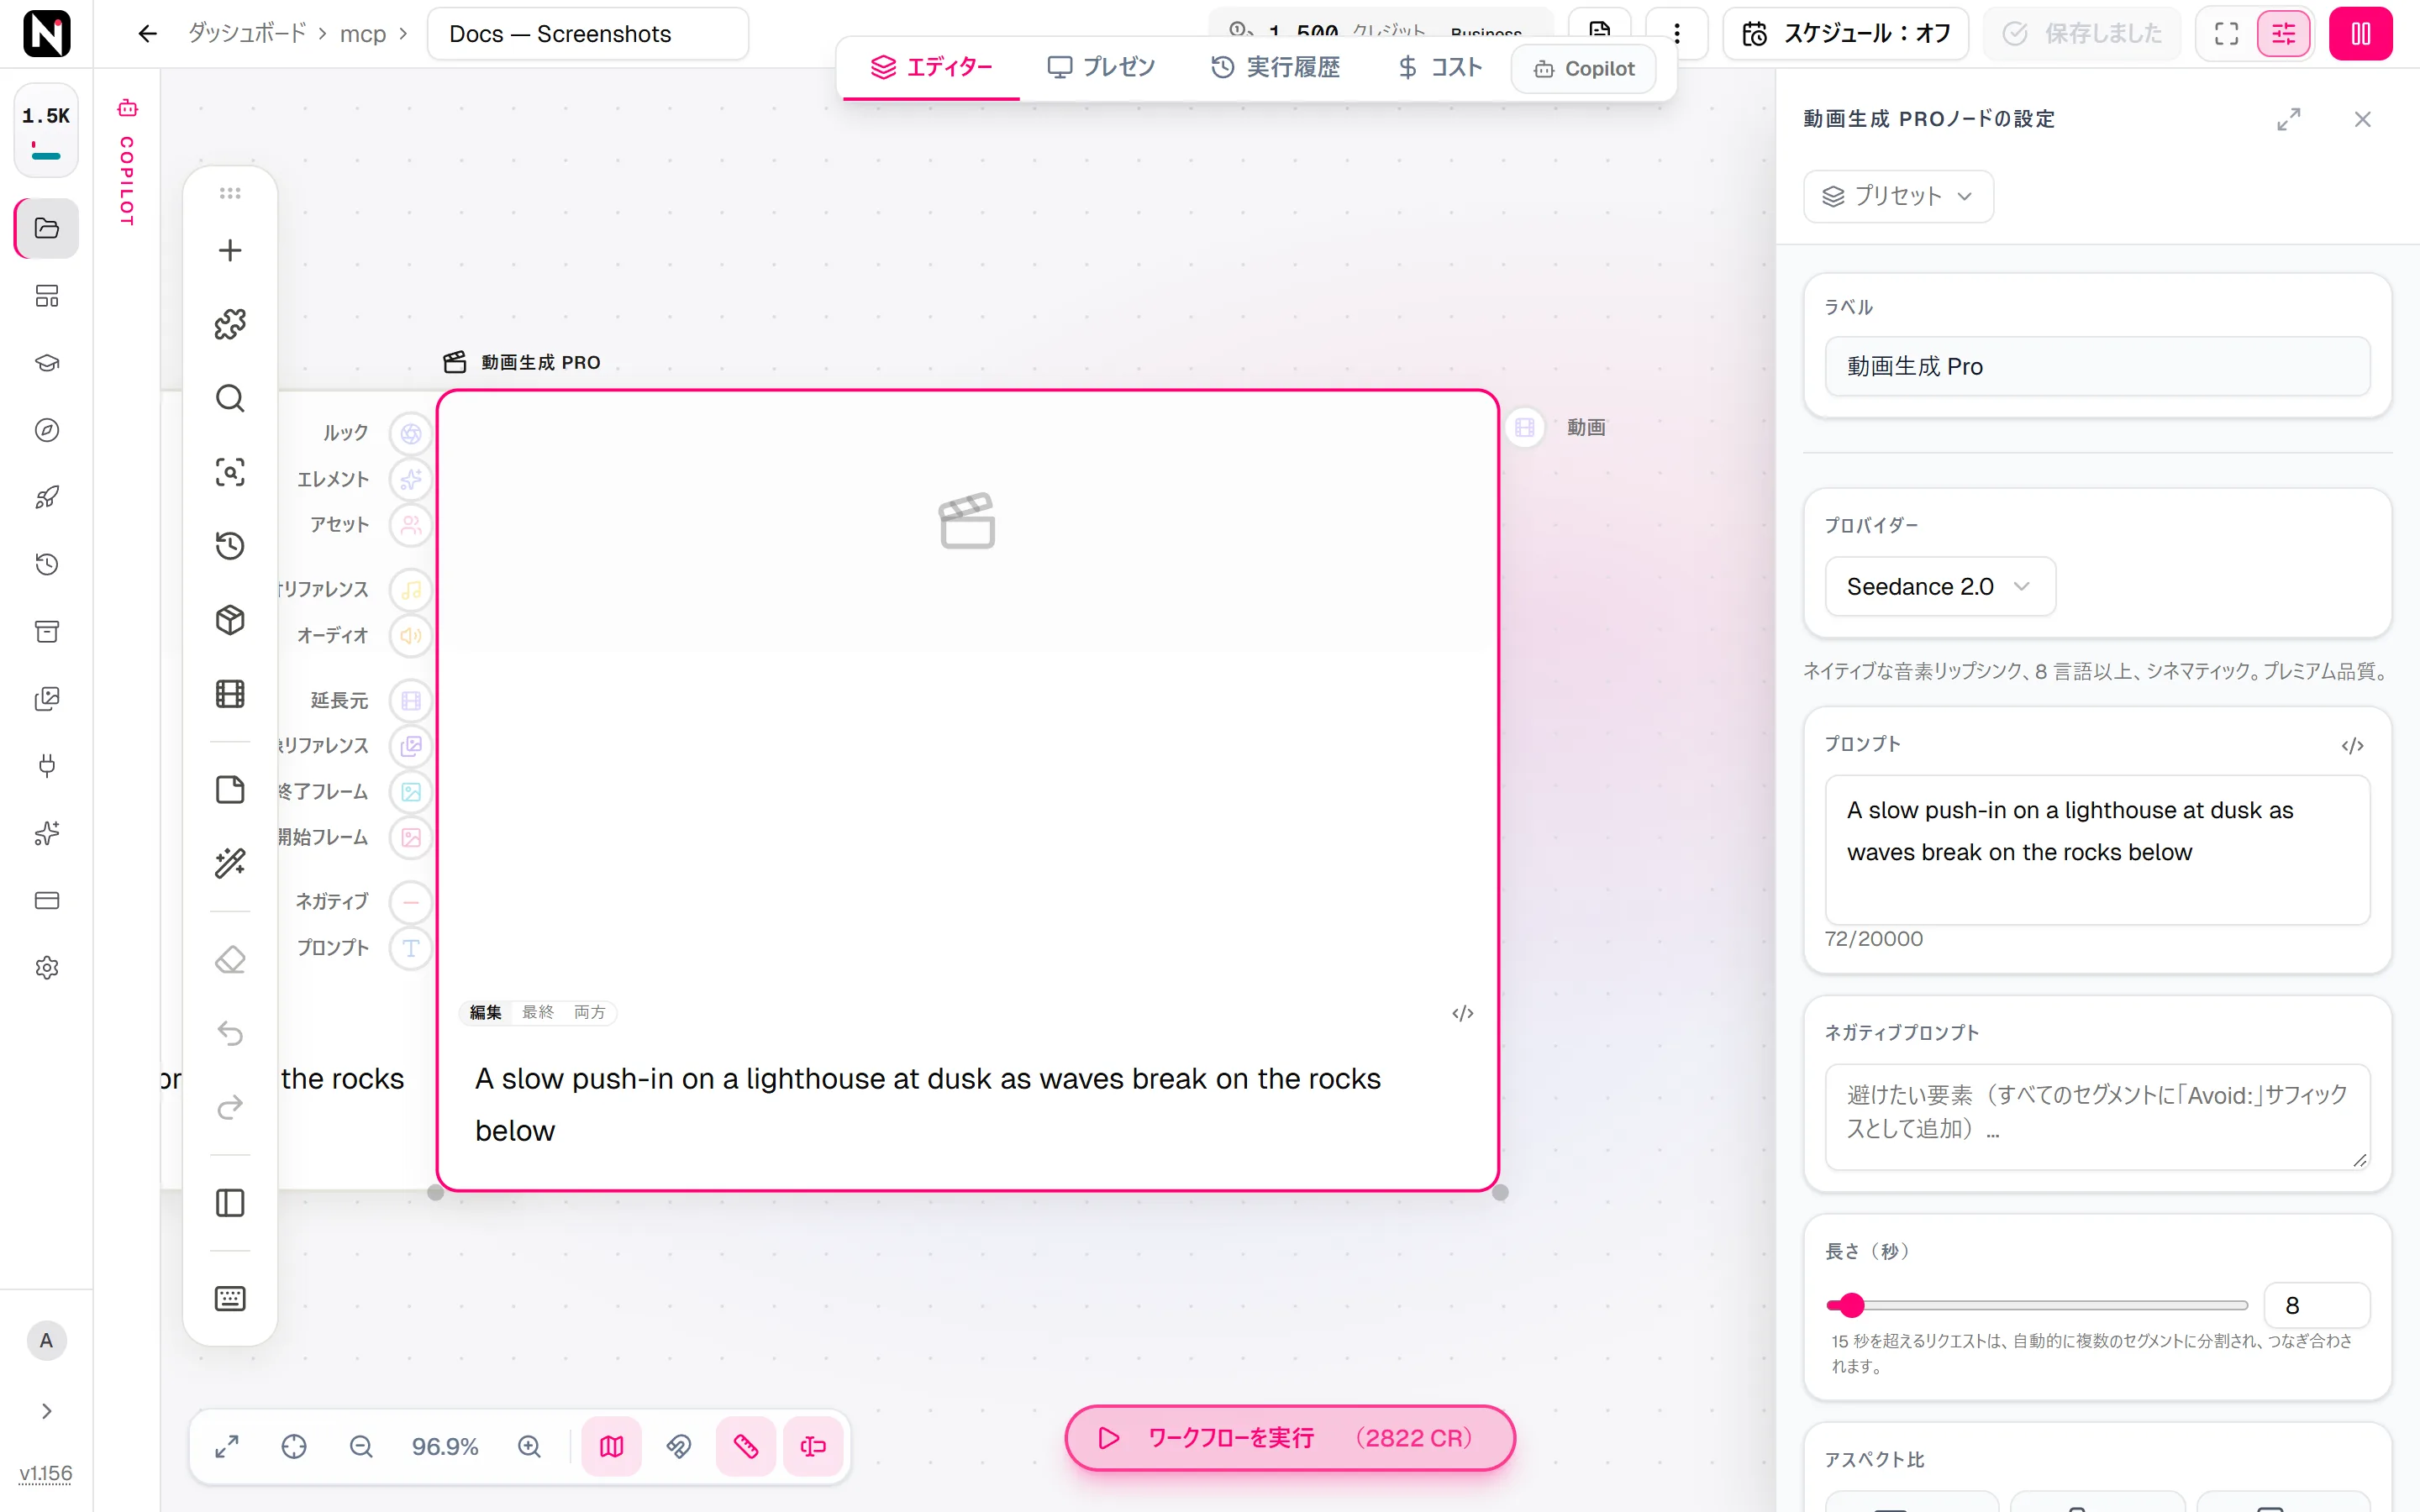
プロバイダーでモデルを選び、長さ(秒)を設定します。パネルには、そのモデルでは何秒を超えると動画がセグメントに分割されるかが表示されます。
実行する
実行をクリックします。セグメントが 1 つずつ順番にレンダリングされ、最後のセグメントが完成すると、つなぎ合わされた動画がノードに表示されます。
長い動画の作られ方
- 収まる場合は 1 セグメント:モデルが 1 回で作れるクリップの長さの上限までは、ノードは通常のクリップを 1 本作ります。料金は、そのモデルを 1 回実行するのと同じです。
- 長い動画はプランを立てる:上限を超えると、AI のプランナーがプロンプトをセグメントに分割します。プランナーは各セグメントのプロンプトを書き、つなぎ目ごとに、ショットを続けるか、新しいショットにカットするかを決めます。
- セグメントは順番にレンダリングされる:各セグメントは、前のセグメントの後に生成されます。連続したつなぎ目では、前のセグメントの最終フレームか最後の数秒を再利用します。計画されたカットでは、新しいショットから始めることができます。
- つなぎ合わせて 1 本のクリップにする:セグメントは 1 本の動画に結合されます。つなぎ目ごとに約 0.3 秒短くなるため、完成した動画はセグメントの合計より少し短くなることがあります。
続きのフレームを使っても、つなぎ目が見えなくなるとは限りません。動画モデルが、フレーミング、ポーズ、動きを変えてしまうこともあります。プロンプトはすべてのセグメントに使われるので、冒頭だけでなく動画全体に当てはまる内容にしてください。
セグメントでは、プランナーが動画をどうセグメントに詰めるかを選びます。
| 選択肢 | 説明 |
|---|---|
| 長め | 完結したアクションやシーンの切り替わりをまとめて保つ、長めのセグメントです。 |
| 短め | 短めのセグメントです。各セグメントは、完結したアクションかシーンの切り替わりで終わります。 |
| 最大(デフォルト) | モデルが許容する最小のセグメント数です。アクションの途中でセグメントが終わることがあります。 |
長めと短めでは、プランナーがまだ長さを決めていないため、料金にはまず確保額の上限が表示されます。最終的な請求額は、レンダリングされたセグメントに基づきます。
一部のモデルでは、選べる長さが限られています。たとえば、VEO 3.1 では 4、6、8 秒、Grok では 6、10 秒です。これらのモデルでは、合計の長さがモデルで作れる最も近い長さに合わせられ、実際にどの長さになるかがノードに表示されます。1 回の実行で作れるセグメントは、最大 24 個です。
入力
動画生成 Pro には、動画生成と同じ入力があります。ただし、動画が複数の部分に分けて作られるため、一部の入力は動作が異なります。
| 入力 | 接続できるノード | 説明 |
|---|---|---|
| プロンプト | テキストノードとピッカー | 動画全体のプロンプトまたは脚本です。 |
| ネガティブ | テキストノード | 避けたいものです。各セグメントのプロンプトに、「Avoid:」の行として追加されます。 |
| 開始フレーム | 画像ノード | 最初のセグメントの冒頭のフレームです。延長元にクリップが接続されている場合は無視されます。 |
| 終了フレーム | 画像ノード 1 つ | 最後のセグメントの最後のフレームです。 |
| 画像リファレンス | 画像ノード(複数を同時に接続可能) | リファレンス画像です。すべてのセグメントで使われます。 |
| 延長元 | 動画ノード 1 つ | 続きを作るクリップです。後のセグメントが前のセグメントから続くのと同じように、実行はこのクリップの終わりから始まります。 |
| オーディオ | オーディオノード 1 つ | 完成した動画に、音量を下げずに重ねるサウンドトラックです。生成された音は、背景に回るよう音量が下げられます。 |
| オーディオリファレンス | オーディオノード 3 つまで | Seedance 2 ファミリー用のリファレンスオーディオです。声や音楽の一貫性を保つため、すべてのセグメントで使われます。 |
| アセット | キャラクターアセット、ロケーションアセット、オブジェクト/小道具アセット(Object/Props Asset)、動物/クリーチャーアセット(Animal/Creature Asset)、顔を作成(Create Face)の各ノード | すべてのセグメントで使われるアイデンティティです。@ メンションは、動画生成と同じように使えます。メンションしたアセットが 1 つだけでも、そのアセットはリファレンスのままで、開始フレームにはなりません。 |
| ルック | カメラ・ルック系のピッカー | 各ピッカーの言い回しが、プロンプトに追加されます。 |
| エレメント | 被写体系のピッカー | 各ピッカーの言い回しが、プロンプトに追加されます。 |
| 設定 | アスペクト比(Aspect Ratio)、長さ(Duration)、プロバイダー(Provider)、モーション(Motion)の各ノード(1 つの入力で 4 種類すべてを接続可能) | ノードの実行時に、アスペクト比、全体の長さ、モデルを設定します。モーションノードは、プロンプトに語句を追加します。下記を参照してください。 |
出力の動画は、つなぎ合わせた動画の URL です。
設定入力は、動画生成と同じように機能します。ただし、次の 2 点が異なります。
- 接続した長さノードは、つなぎ合わせた動画の全体の長さを設定する:値は長さ(秒)の範囲である 4〜120 秒に収められ、モデルが 1 回で作れるクリップの長さには合わせられません。
- 接続したプロバイダーノードには、このノードのモデルのいずれかを設定する必要がある:VEO 3.1 Quality など、動画生成 Pro にない動画モデルは拒否されます。画像モデルも同様です。
接続した比率は、モデルが作れる最も近い比率で実行されます。ノードの左上には、接続した値がチップとして表示されます。設定が接続されている間は、実行の下に「接続した設定によって価格が変わる場合があります」という注記が表示され、料金には接続したモデルと長さが使われます。
設定
| 設定 | 説明 |
|---|---|
| プロバイダー | 動画モデルです。新しいノードは Seedance 2.0 で始まります。 |
| プロンプト | プロンプト入力に何も接続されていないときに使う、プロンプトまたは脚本です。 |
| ネガティブプロンプト | 避けたいものです。すべてのセグメントに追加されます。 |
| 長さ(秒) | 全体の長さで、4〜120 秒です。デフォルトは 8 秒です。 |
| アスペクト比 | 動画の形です。デフォルトの自動調整は、接続された入力に合わせます。選べる値はモデルによって異なります。 |
| 解像度 | 出力の解像度です。新しいノードでは 720p を使います。 |
| オーディオを生成(デフォルトでオン) | モデルが音を作るかどうかです。 |
| BGM なし(後で追加) | モデルに音楽を付けないよう指示し、あとから自分の音楽を加えられるようにします。 |
| レンダリング方式 | キーフレーム(シーンのアンカー)か延長(動画チェーン)です。新しいノードではキーフレームを使います。レンダリング方式を参照してください。 |
| アンカーフレーム | キーフレーム方式のみ。各ショットを、生成した静止画にどの程度固定するかです。新しいノードでは開始フレームのみを使います。アンカーフレームを参照してください。 |
| プランナーのモデル | セグメントを計画する AI モデルです。新しいノードでは Claude Fable 5 を使います。任意のテキストモデルを選んで、速度と計画の品質のどちらを優先するかを調整できます。 |
| プランナーのスタイル | プランナーが脚本をどう扱うかです。プランナーのスタイルを参照してください。 |
| セグメント | 長め、短め、最大のいずれかです。長い動画の作られ方を参照してください。 |
| プランのみ | 動画を生成せずに、セグメントのプランを返します。プランのみを参照してください。 |
| 前後のテキスト | プロンプトの前後に必ず追加されるテキストです。プロンプトの前後のテキストを参照してください。 |
設定入力に接続したプロバイダー、長さ、アスペクト比の各ノードは、ノードの実行時にプロバイダー、長さ(秒)、アスペクト比を置き換えます。接続したモーションノードは、設定を置き換える代わりに、プロンプトに語句を追加します。入力を参照してください。
特定のレンダリング方式では、さらに設定が表示されます。そのうちの一部には、パネルで「試験的」と表示されます。
| 設定 | 説明 |
|---|---|
| 継続コンテキスト(秒) | 延長方式のみ。各続きのセグメントが、前のセグメントをどれだけ参照するかです。デフォルトは 2 秒です。ゆっくりしたカメラの動きや、音楽に合わせた動きでは値を上げます。1 秒増やすごとに、つなぎ目ごとに少額の料金が加わります。5 秒を超える値では、モデルのリファレンス動画の上限を超えて、つなぎ目の生成に失敗することがあります。 |
| ローリングリファレンス | 延長方式のみ、試験的。画面から外れていたキャラクターが再登場すると、最後に登場したショットがリファレンスとして追加されるので、見た目と位置が引き継がれます。 |
| オーディオコンテキストの引き継ぎ | 延長方式で、オーディオを生成し、オーディオリファレンスを受け付けるモデルを使う場合。試験的。各続きのセグメントは、サウンドトラックの最後の約 8 秒も聞き取るので、音楽がずれずに続きます。オーディオリファレンスが接続されている場合は表示されません。 |
| 重複アンカー | 延長方式と最大の組み合わせのみ、試験的。最終フレーム(デフォルト)は、前のセグメントのいちばん最後から続けます。最終キーフレームは、モデルに短い重複部分を先に再現させ、つなぎ合わせの際にその繰り返しを取り除きます。オフは、この機能をオフにします。 |
| 単語単位のクリーンカット | 延長方式と最大の組み合わせのみ、試験的。各セグメントを 1 秒長く作り、歌や話し声の単語の間にある最も近い切れ目でカットするので、つなぎ目で単語が途切れることはありません。課金は、計画した長さのままです。 |
| スマートカット | 各つなぎ目のカット方法です。スマートカットを参照してください。 |
| ベストペアの検索範囲(フレーム) | つなぎ目の照合で比較するフレーム数です。前の末尾からと次の先頭からを、それぞれ 1〜24 で指定します。空欄の場合は 8 × 8 です。 |
| ショットのタイムスタンプ | ハイブリッドと凝縮のプランナースタイルで、セグメントのプロンプトに各ビートの時間範囲を追加します。これらのスタイルは、デフォルトでは時間を省きます。 |
| 分析から自動キャスト | 試験的で、デフォルトはオフです。脚本が、キャラクターのリファレンスフレームを含む動画分析の結果である場合、それらのフレームがアイデンティティのリファレンスとして追加されます。追加されるのは自分の画像の後で、モデルの上限の範囲内です。 |
| 希望するセグメントの長さ(秒) | 古いノードのために残されている設定です。セグメントはこの長さの近くで区切られます。範囲は 4〜15 秒です。長め、短め、最大のいずれかを選ぶと、この設定は置き換えられます。 |
モデル
動画生成 Pro では、開始画像とリファレンス画像を同時に受け付けるすべての動画モデルを使えます。VEO 3.1 Quality はリファレンスモードがないため、使えません。代わりに VEO 3.1 Fast か Lite を使うか、Quality のクリップが必要なら動画生成で 1 回実行してください。
| モデル | 開発元 | モード | クレジット | 詳細 |
|---|---|---|---|---|
| minimax-h3 | MiniMax | 画像から動画、テキストから動画 | 230 から | MiniMax Hailuo 3 はプレミアムなマルチモーダルのティアで、最初と最後のフレームに加えて画像/動画/オーディオのリファレンスを使え、ネイティブオーディオに対応し、2K(デフォルト)または 768P で出力し、長さは 4〜15 秒で料金は秒単位です。 |
| VEO 3.1 Fast | 画像から動画、テキストから動画 | 150 から | VEO 3.1 Fast は VEO 3.1 の安価なティアで、オーディオ付きの 4/6/8 秒のクリップを作ります。ほとんどの用途でバランスの良い選択です。料金は長さに関係なく、1 回の生成ごとに一律です。 | |
| VEO 3.1 Lite | 画像から動画、テキストから動画 | 75 から | VEO 3.1 Lite は、大量生成に向く、最もコスト効率の良い VEO のティアです。オーディオ付きの 4/6/8 秒のクリップを作り、最初と最後のフレームに対応しています。 | |
| Gemini Omni | 画像から動画、テキストから動画 | 230 から | ネイティブオーディオ付きの Google のマルチモーダル動画モデルで、テキストや画像から動画を作れるほか、動画の編集もできます。 | |
| Gemini Omni Flash | 画像から動画、テキストから動画 | 160 から | Google の Gemini Omni Flash は、より高速で安価な Omni のティアで、ネイティブオーディオ付きのマルチモーダル動画モデルとして、テキストや画像から動画を作れるほか、動画の編集もできます。 | |
| Grok Imagine (I2V) | xAI | 画像から動画 | 50 から | 画像から動画を生成する Grok のモデルで、スタイライズされた動きを作ります。長さは最大 15 秒です。 |
| Seedance 2 | Bytedance | 画像から動画、テキストから動画 | 230 から | Seedance 2 は、ネイティブオーディオ付きのプレミアムなティアです。料金は解像度ごとの秒単位です。 |
| Seedance 2 Fast | Bytedance | 画像から動画、テキストから動画 | 180 から | Seedance 2 の、より安価で高速なティアです。 |
| Seedance 2 Mini | Bytedance | 画像から動画、テキストから動画 | 120 から | Seedance 2 の低価格なティアで、480p/720p のみに対応し、料金は解像度ごとの秒単位です。 |
| Seedance 2.5 | Bytedance | 画像から動画、テキストから動画 | 340 から | Seedance 2.5 は、1 ショットで最大 30 秒を生成でき、ネイティブオーディオと幅広いマルチモーダルのリファレンスに対応しています。解像度は 480p/720p/1080p です。 |
| Wan 3.0 | Alibaba | 画像から動画、テキストから動画 | 160 から | Wan 3.0 はマルチモーダルなモデルで、最初と最後のフレーム、または画像/動画/オーディオのリファレンスを使え、ネイティブオーディオに対応し、480p/720p/1080p で 2〜30 秒の動画を作ります。 |
| Wan 3.0 Prime | Alibaba | 画像から動画、テキストから動画 | 250 から | Wan 3.0 Prime は Alibaba による Wan 3.0 の高速なティアで、マルチモーダルな入力と 2〜30 秒の範囲は同じまま、秒単位の料金が高い分、より早く仕上がります。 |
| HappyHorse 1.1 Ref2V | HappyHorse | 画像から動画 | 282 | リファレンスから動画を生成する HappyHorse 1.1 で、1〜9 枚のリファレンス画像を使って 720p/1080p で 3〜15 秒の動画を作り、料金は秒単位です。 |
| モデル | セグメントの長さ | 解像度 | レンダリング方式 |
|---|---|---|---|
| Seedance 2 | 4〜15 秒 | 480p、720p、1080p、4K | キーフレーム、延長 |
| Seedance 2 Fast | 4〜15 秒 | 480p、720p | キーフレーム、延長 |
| Seedance 2 Mini | 4〜15 秒 | 480p、720p | キーフレーム、延長 |
| Seedance 2.5 | 4〜30 秒 | 480p、720p、1080p | キーフレーム、延長 |
| Hailuo 3 (minimax-h3) | 4〜15 秒 | 2K、768P | キーフレーム、延長 |
| VEO 3.1 Fast と VEO 3.1 Lite | 4、6、8 秒 | 720p、1080p、4K | キーフレーム |
| Gemini Omni と Gemini Omni Flash | 4、6、8、10 秒 | 720p、1080p、4K | キーフレーム |
| Grok Imagine (I2V) | 6、10 秒 | 480p、720p | キーフレーム |
| Wan 3.0 と Wan 3.0 Prime | 2〜30 秒 | 480p、720p、1080p | キーフレーム |
| HappyHorse 1.1 Ref2V | 3〜15 秒 | 720p、1080p | キーフレーム |
シーンのタイミングを正確に合わせるには、長さを連続した範囲で選べるモデルを選びます。Seedance 2 ファミリー、Hailuo 3、Wan 3.0 です。提供が終了したモデルで保存されたワークフローはそのまま実行でき、次にパネルを開いたときに Seedance 2.0 に切り替わります。
レンダリング方式
レンダリング方式は、セグメントをどう作るかを決めます。分割そのものは変わりません。
キーフレーム(シーンのアンカー)
各セグメントは、前のセグメントの動画からではなく、アンカーフレームからレンダリングされます。新しいノードのデフォルトの方式で、リファレンス動画モードのないモデルではこの方式しか使えません。
- 連続したショットは境界のフレームを再利用する:納品されたセグメントの最終フレームが、描き直されることなく、次のセグメントの冒頭のアンカーになります。
- 計画されたカットはカットのまま:新しいカメラ設定、シーン、時間帯には、それぞれ専用のアンカーが作られます。
- シーンは互いに独立している:ほかのシーンに触れずに、1 つのシーンだけをレンダリングし直せます。
- 一貫性はアンカーから生まれる:一貫性を生むのは、動画チェーンではなく、アンカーと、自分で接続したアイデンティティのリファレンスです。
- 声と効果音のみ:この方式では、モデルに音楽を求めません。音楽は、あとから動画とオーディオを結合(Merge Video & Audio)で加えます。
アンカーは、21:9 も含め、GPT Image 2.5 により 2K で生成されます。GPT Image 2.5 でレンダリングできない 4:5 と 5:4 の比率では、Nano Banana Pro が使われます。
延長(動画チェーン)
各セグメントは、前のセグメントの最後の数秒から続きます。その数秒は、リファレンス動画としてモデルに送られます。光、色、被写体、舞台設定が、セグメントからセグメントへと引き継がれます。連続したアクションや、途切れないカメラの動きに使います。Seedance 2 ファミリーと Hailuo 3 で使えます。ほかのモデルでは、このコントロールは無効になり、その理由が表示されます。
各セグメントは直前のセグメントに依存するため、1 つのシーンを変えると、それ以降のすべてのシーンが作り直されます。
アンカーフレーム
キーフレーム方式では、アンカーフレームで、各ショットを生成した静止画にどの程度固定するかを決めます。
| 設定 | 動作 | 使う場面 |
|---|---|---|
| 自動(エンジンが判断) | シーンごとに冒頭の静止画を生成し、モデルが対応している場合は、長めのシーンに終わりの静止画も生成します。 | 特に選ぶ理由がない場合。 |
| 開始・終了フレーム | すべてのシーンを、生成した冒頭の静止画と終わりの静止画の間でレンダリングします。 | 静止したポーズ、商品のヒーローショット、タイトルフレームなど、ショットを特定の画像で終わらせる必要がある場合。 |
| 開始フレームのみ(デフォルト) | 連続したショットは、前のショットの実際の最終フレームから始まります。計画されたカットは、新しい静止画から始まります。終わりの静止画は固定しません。 | カメラが移動する場合や、終わりのフレームにたどり着こうとしてショットがゆがんでいた場合。 |
| リファレンスのみ | フレームを一切使いません。アイデンティティとロケーションのリファレンス、そしてプロンプトだけで各ショットを作ります。 | モデルに自由に構図を決めさせたい場合。 |
終わりの静止画はショットより先に生成されるため、最終的に画面がどうなるかの推測にすぎません。カメラが動くと、モデルはその推測に合わせようとして、シーンをゆがめることがあります。最後の 1 秒で、物がずれたり滑ったりするのです。開始フレームのみなら、この推測を使いません。終了フレームに何かが接続されている間は、リファレンスのみを選べません。
プランナーのスタイル
| スタイル | プランナーの動作 |
|---|---|
| 自動(デフォルト) | 動画分析の結果は凝縮し、それ以外はすべて忠実に分割します。 |
| 忠実な分割 | 元の文言とタイミングを保ちます。タイムスタンプは、各セグメントが 0:00 から始まるようにずらされます。 |
| 凝縮 | 脚本を、タイムスタンプのない短いセグメントプロンプトに書き換えます。分析の脚本では、短いプロンプトのほうがうまくいくことがよくあります。 |
| スロット固定 | 忠実な分割を保ったうえで、各セグメントの冒頭にキャラクターごとの定義を 1 行ずつ置き、以降はその名前を使います。 |
| ハイブリッド | 試験的。キャラクターを常にラベルで呼ぶ、コンパクトなビートです。リファレンス画像のあるキャラクターにはテキストの説明を付けず、見た目は画像に任せます。 |
| ハイブリッドプラス | 試験的。各セグメントの冒頭に、そのセグメントに登場するキャラクターのアイデンティティ一覧を置き、その下のビートではキャラクターをラベルだけで呼びます。延長方式ではローリングリファレンスが必要です。 |
| ハイブリッドマックス | 試験的。圧縮なしのハイブリッドプラスです。分析のすべての詳細を残すため、最も忠実で、最も長いプロンプトになります。延長方式ではローリングリファレンスが必要です。 |
スタイルとプランのみを組み合わせると、生成する前にスタイルを比較できます。
スマートカット
セグメントが前のセグメントから続く場合、同じ瞬間が、あるセグメントの終わりと次のセグメントの始まりの両方に含まれることがあります。そのままにすると、その瞬間が 2 回再生され、つなぎ目がカクつきます。スマートカットは、この繰り返しを取り除きます。
- ベストペア(デフォルト):セグメントの最後のフレーム群と、次のセグメントの最初のフレーム群を 1 枚ずつ比較します。最も一致するフレームで前のセグメントを終え、次のセグメントをその対になるフレームの直後から始めるので、動きがつなぎ目をそのまま通り抜けます。
- プリロール(次を保持)とプリロール(前を保持):続きのセグメントが早めに始まり、前のセグメントの末尾の一部を繰り返す場合に対応します。次を保持は、重複部分の中につなぎ目を隠します。前を保持は、前のセグメントのフレームを残します。どちらも延長方式でのみ使え、重複アンカーが「最終キーフレーム」の場合は使えません。オーディオ補助カットを使うと、声や効果音を照合して、カットの位置を決めやすくなります。
キーフレーム方式では、ベストペアは連続として計画されたつなぎ目でのみ動作します。計画されたカットがトリムされることはなく、十分に近い一致が見つからない場合は、両方のセグメントがそのまま残ります。検索範囲を 24 × 24 に広げるのは、つなぎ目にカクつきが見える場合だけにしてください。範囲を広げると、見た目が似ているだけの 2 つのフレームを組み合わせてしまうことがあります。
プランのみ
プランのみをオンにすると、プランニングの段階だけを実行して、そこで止まります。ノードは、動画の代わりに表を返します。表には、各セグメントについて、送信されるとおりのプロンプト、長さ、つなぎ目が連続したショットかカットかが示されます。さらに、モデル、解像度、アスペクト比、全体の長さも示されます。表にポインターを合わせると、JSON としてコピーできます。
プランのみでかかるのはプランニングの料金だけで、動画の料金はかかりません。動画を生成するには、プランのみをオフにして、もう一度実行します。
実行の停止と続行
ノードはセグメントを 1 つずつレンダリングし、1 つ終わるたびに進捗を保存します。
- 停止して保持する:ノードの実行中に停止メニューを開き、停止してレンダリング済みの部分を保持を選びます。作成中のセグメントは破棄されますが、モデルがレンダリングを続けるため、料金はかかります。それまでに完成した部分は、すべてつなぎ合わされて短い動画になります。最初のセグメントが完成する前に停止すると、何も納品されず、請求されるのは手数料と最初のセグメントの料金だけです。
- 続行する:停止した後や、一部のセグメントを納品して失敗した後には、ノードの実行ボタンのツールバーに続行のコントロールが表示されます。最初の欠けているセグメントから始めるには、セグメント N から再開を選びます。それより前のセグメントを作り直すには、そのセグメントを選びます。続行すると、新しい実行が始まります。新しい実行では、元のプランと、選んだセグメントより前のセグメントがそのまま使われ、料金がかかるのは作ったセグメントの分だけです。
長い実行の途中でサービスが再起動した場合、実行は最後に保存されたセグメントから再開されます。完成したセグメントが、二重に作られたり二重に請求されたりすることはありません。
クレジット
ノードには、実行する前に料金が表示されます。確保額は、その実行でかかりうる最大の料金です。最終的な請求額は実際に作られたセグメントに基づき、残りは返還されます。
- 1 セグメント:1 つのセグメントに収まる動画は、そのモデルを 1 回実行するのと同じ料金です。料金は常に、リファレンスなしの価格です。
- キーフレーム方式で複数セグメント:1 回の実行につき一律 100 クレジットの手数料、リファレンスなしのモデルの価格による各セグメントの料金、アンカーの静止画の料金がかかります。アンカーは、アンカー用の画像モデルの価格で、シーンごとに 2 枚分が確保されます。請求されるのは実際に生成されたアンカーだけで、前のセグメントから再利用したフレームは無料です。
- 延長方式で複数セグメント:1 回の実行につき一律 100 クレジットの手数料、リファレンスなしの価格による最初のセグメントの料金、リファレンスありの安い価格による以降のセグメントの料金、つなぎ目ごとの継続コンテキストの料金がかかります。最初のセグメントは 15 秒分がまるごと確保され、その後、実際の長さで精算されます。
- クリップ単位で料金が決まるモデル:VEO 3.1、Gemini Omni、Grok、HappyHorse、Wan 3.0 では、各セグメントの料金は、同じ長さと解像度で動画生成を 1 回実行した場合と同じです。これに手数料とアンカーの料金が加わります。
- 続行:続行した実行では、手数料と、作り直すセグメントの料金を支払います。再利用できるアンカーの分は確保されません。
- 一部の納品:実行が途中で止まった場合、完成したセグメントは残されて請求され、確保額の残りは返還されます。実行の中で再試行されたセグメントの請求は、1 回だけです。
Seedance 2 の 720p で延長方式を使う場合の確保額は、次のとおりです。
| 指定した長さ | セグメント数 | 確保されるクレジット |
|---|---|---|
| 8 秒 | 1 | 820 |
| 15 秒 | 1 | 1,540 |
| 16 秒 | 2 | 1,888 |
| 43 秒 | 3 | 3,701 |
| 60 秒 | 5 | 5,076 |
| 120 秒 | 9 | 9,388 |
たとえば、Seedance 2 の 720p で延長方式を使って 60 秒の動画を実行すると、14、12、12、12、12 秒の 5 つのセグメントに分割されます。確保されるのは 5,076 クレジットです。5 つのセグメントがすべて完成すると、請求額は 5,035 クレジットで、41 クレジットが返還されます。Gemini Omni Flash の 720p では、10、8、6 秒のセグメントの料金が 320 + 270 + 210 = 800 クレジットで、これに手数料とアンカーの料金が加わります。Wan 3.0 の 720p では、30 秒と 15 秒のセグメントの料金が 1,200 + 600 = 1,800 クレジットで、これに手数料とアンカーの料金が加わります。
確保と返還のしくみについては、クレジットを参照してください。
ヒント
- できるだけ 1 セグメントに収める:モデルが 1 回で作れるクリップの長さの上限より短い場合は、動画生成のほうが安く、リファレンスのすべての機能を使えます。
- 冒頭を固定する:開始フレームを接続します。接続しないと、最初のセグメントはプロンプトだけから作られます。
- 支払う前にプランを確認する:プランのみで実行すると、どこでカットされるか、各セグメントのプロンプトがどうなるかを確認できます。
- クレジットだけでなく時間も見込む:セグメントは 1 つずつ順番にレンダリングされるので、長い動画はそれに比例して時間がかかります。
- カットを実際のショットに合わせる:動画分析から得た脚本では、長さを連続した範囲で選べるモデルを使うと、セグメントの境界を実際のカットの位置に合わせられます。
トラブルシューティング
アンカーフレームにリファレンスのみがない:終了フレームに何かが接続されています。リファレンスのみの実行には終わりのフレームがないため、使うには終了フレームの接続を解除してください。
レンダリング方式が無効になっている:モデルにリファレンス動画モードがないため、常にキーフレーム方式でレンダリングされます。延長方式を使うには、Seedance 2 のモデルか Hailuo 3 を選んでください。
動画が指定より少し短い:つなぎ目ごとに約 0.3 秒短くなります。また、選べる長さが限られているモデルでは、作れる最も近い合計の長さに合わせられます。実際の長さはノードに表示されます。
つなぎ目がカクつく:続きのセグメントが、前のセグメントの一部を繰り返しています。ベストペアの検索範囲を広げるか、延長方式ではプリロールのスマートカットを試してください。
実行が無効で、ノードのチップが赤い:設定入力に接続したプロバイダーノードに、VEO 3.1 Quality や画像モデルなど、このノードにないモデルが設定されています。プロバイダーノードで、動画生成 Pro のモデルを 1 つ選んでください。ワークフローの実行は、料金がかかる前にこのノードで止まり、そのエラーにはプロバイダーノードの名前が示されます。
API から
このノードは、ほかのノードと同じ API で実行できます。一部の機能は、コードからしか使えません。
- セグメントの正確な長さ:分割を自分で決めるには、
segmentDurationsを渡します。これは、4〜15 秒の整数を 1〜24 個並べたリストです。合計は、指定した長さに、つなぎ目ごとに 0.3 秒を足して切り上げた値と等しくなければなりません。 - セグメントの詰め方:
segmentModeには、short、long、maxを指定できます。 - 見積もり:
POST /v1/credits/video-pro-estimateは現在の見積もりを返し、それが上限値かどうかも示します。 - 停止と続行:
POST /v1/generate-video-pro/:jobId/stopは実行を停止し、そのセグメントを残します。POST /v1/generate-video-pro/continueにfromJobIdと、必要に応じてfromSegmentを指定すると、実行を続行します。MCP ツールのstop_video_proとcontinue_video_proでも、同じことができます。
単体のノードを実行すると MCP ツールを参照してください。
よくある質問
関連ページ
動画生成
動画分析
動画とオーディオを結合
Nodaro Cloud に接続する
クレジット
最終更新