
 Nodaro ドキュメント
文字起こし
ElevenLabs STT、Whisper、Nemotron 3.5 Transcribe で、オーディオや動画の音声をテキストにします。字幕用の単語のタイミング、話者のラベル、翻訳も取得できます。
文字起こしノードは、音声をテキストにします。オーディオか動画を接続すると、ノードは文字起こしを 2 つの形で返します。プレーンなテキストと、すべての単語のタイミングが入った構造化された文字起こしです。4 つのエンジンから選べ、エンジンによって、字幕にとって重要な 1 点が異なります。単語のタイミングを返すかどうかです。Nemotron 3.5 Transcribe は、音声を文字起こしする代わりに翻訳することもできます。
使いどころ
- インタビューやポッドキャストを文字起こしして、文章のコンテンツにします。
- 字幕を追加で、動画の音声から字幕を作ります。
- ボイスメモや会議の録音をテキストにします。
- オーディオライブラリを、テキストで検索できるようにします。
- 文字起こしをテキスト系のノードに渡して、要約や分析をします。
- 編集プランが編集を計画するのに必要な、タイミング付きの文字起こしを渡します。
クイックスタート
ノードを追加する
キャンバス上で Tab を押し、オーディオ › 文字起こし › 文字起こしを選びます。
録音を接続する
オーディオ系か動画系のノードを、オーディオ入力に接続します。
エンジンと言語を選ぶ
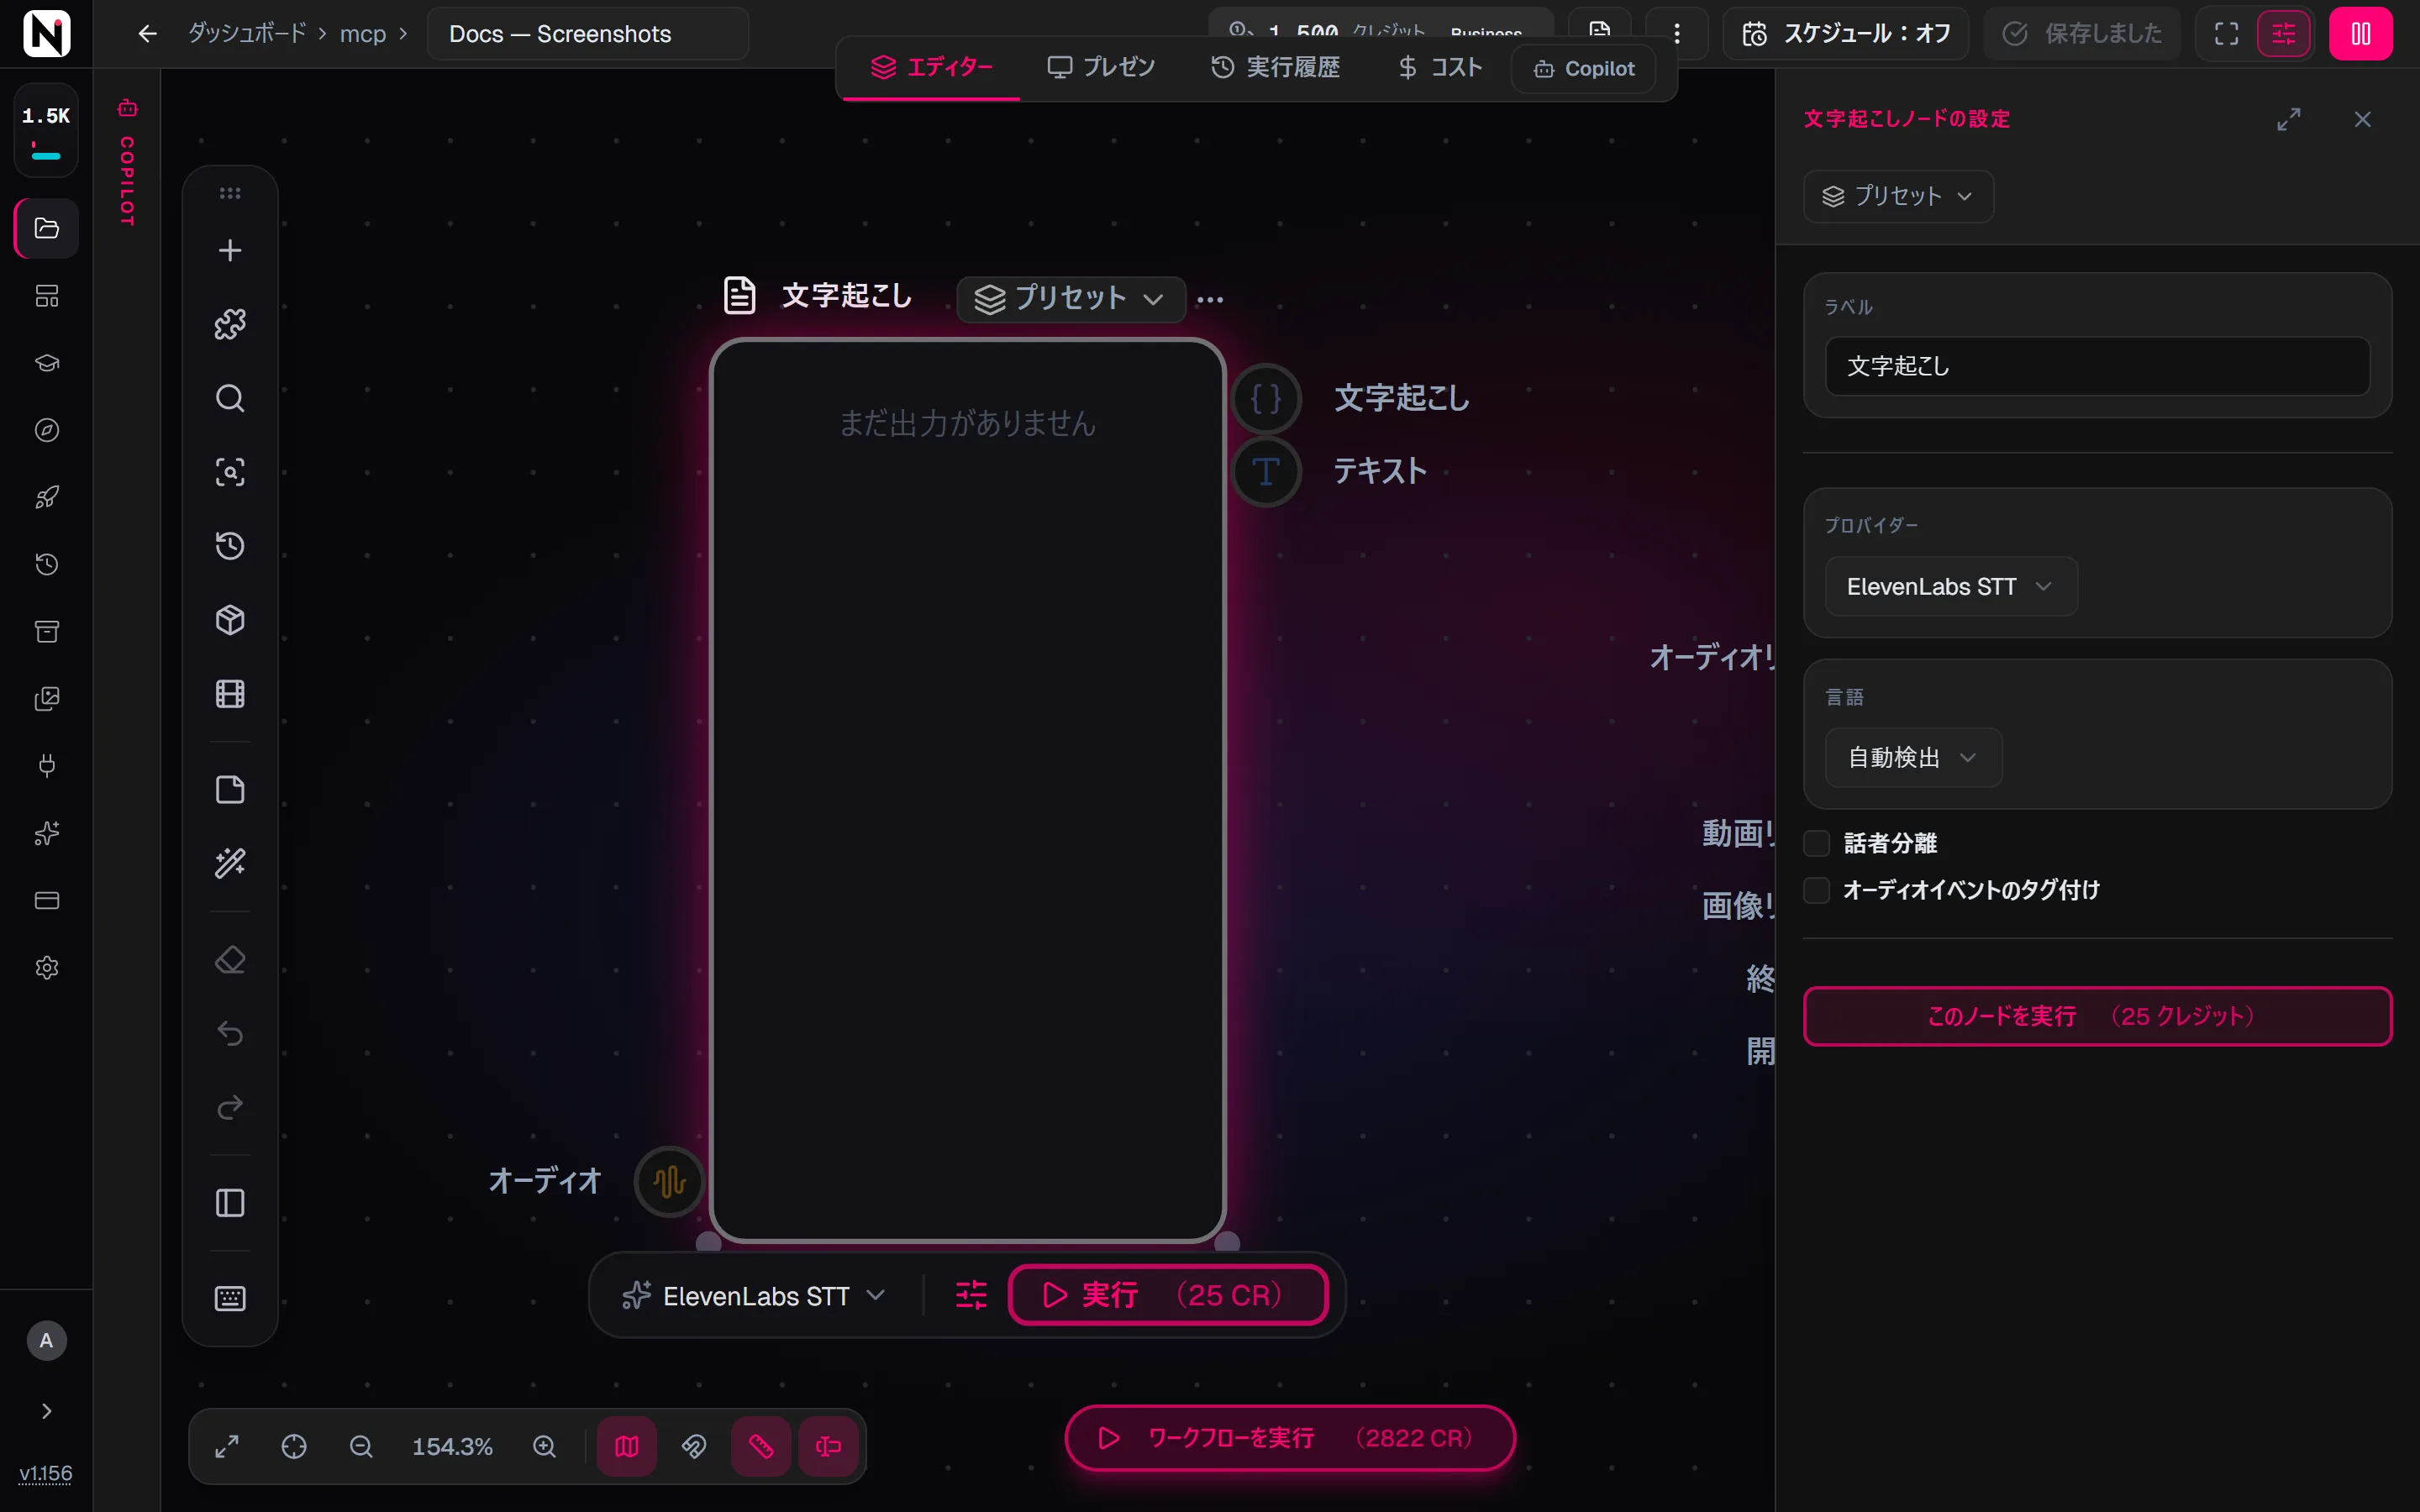
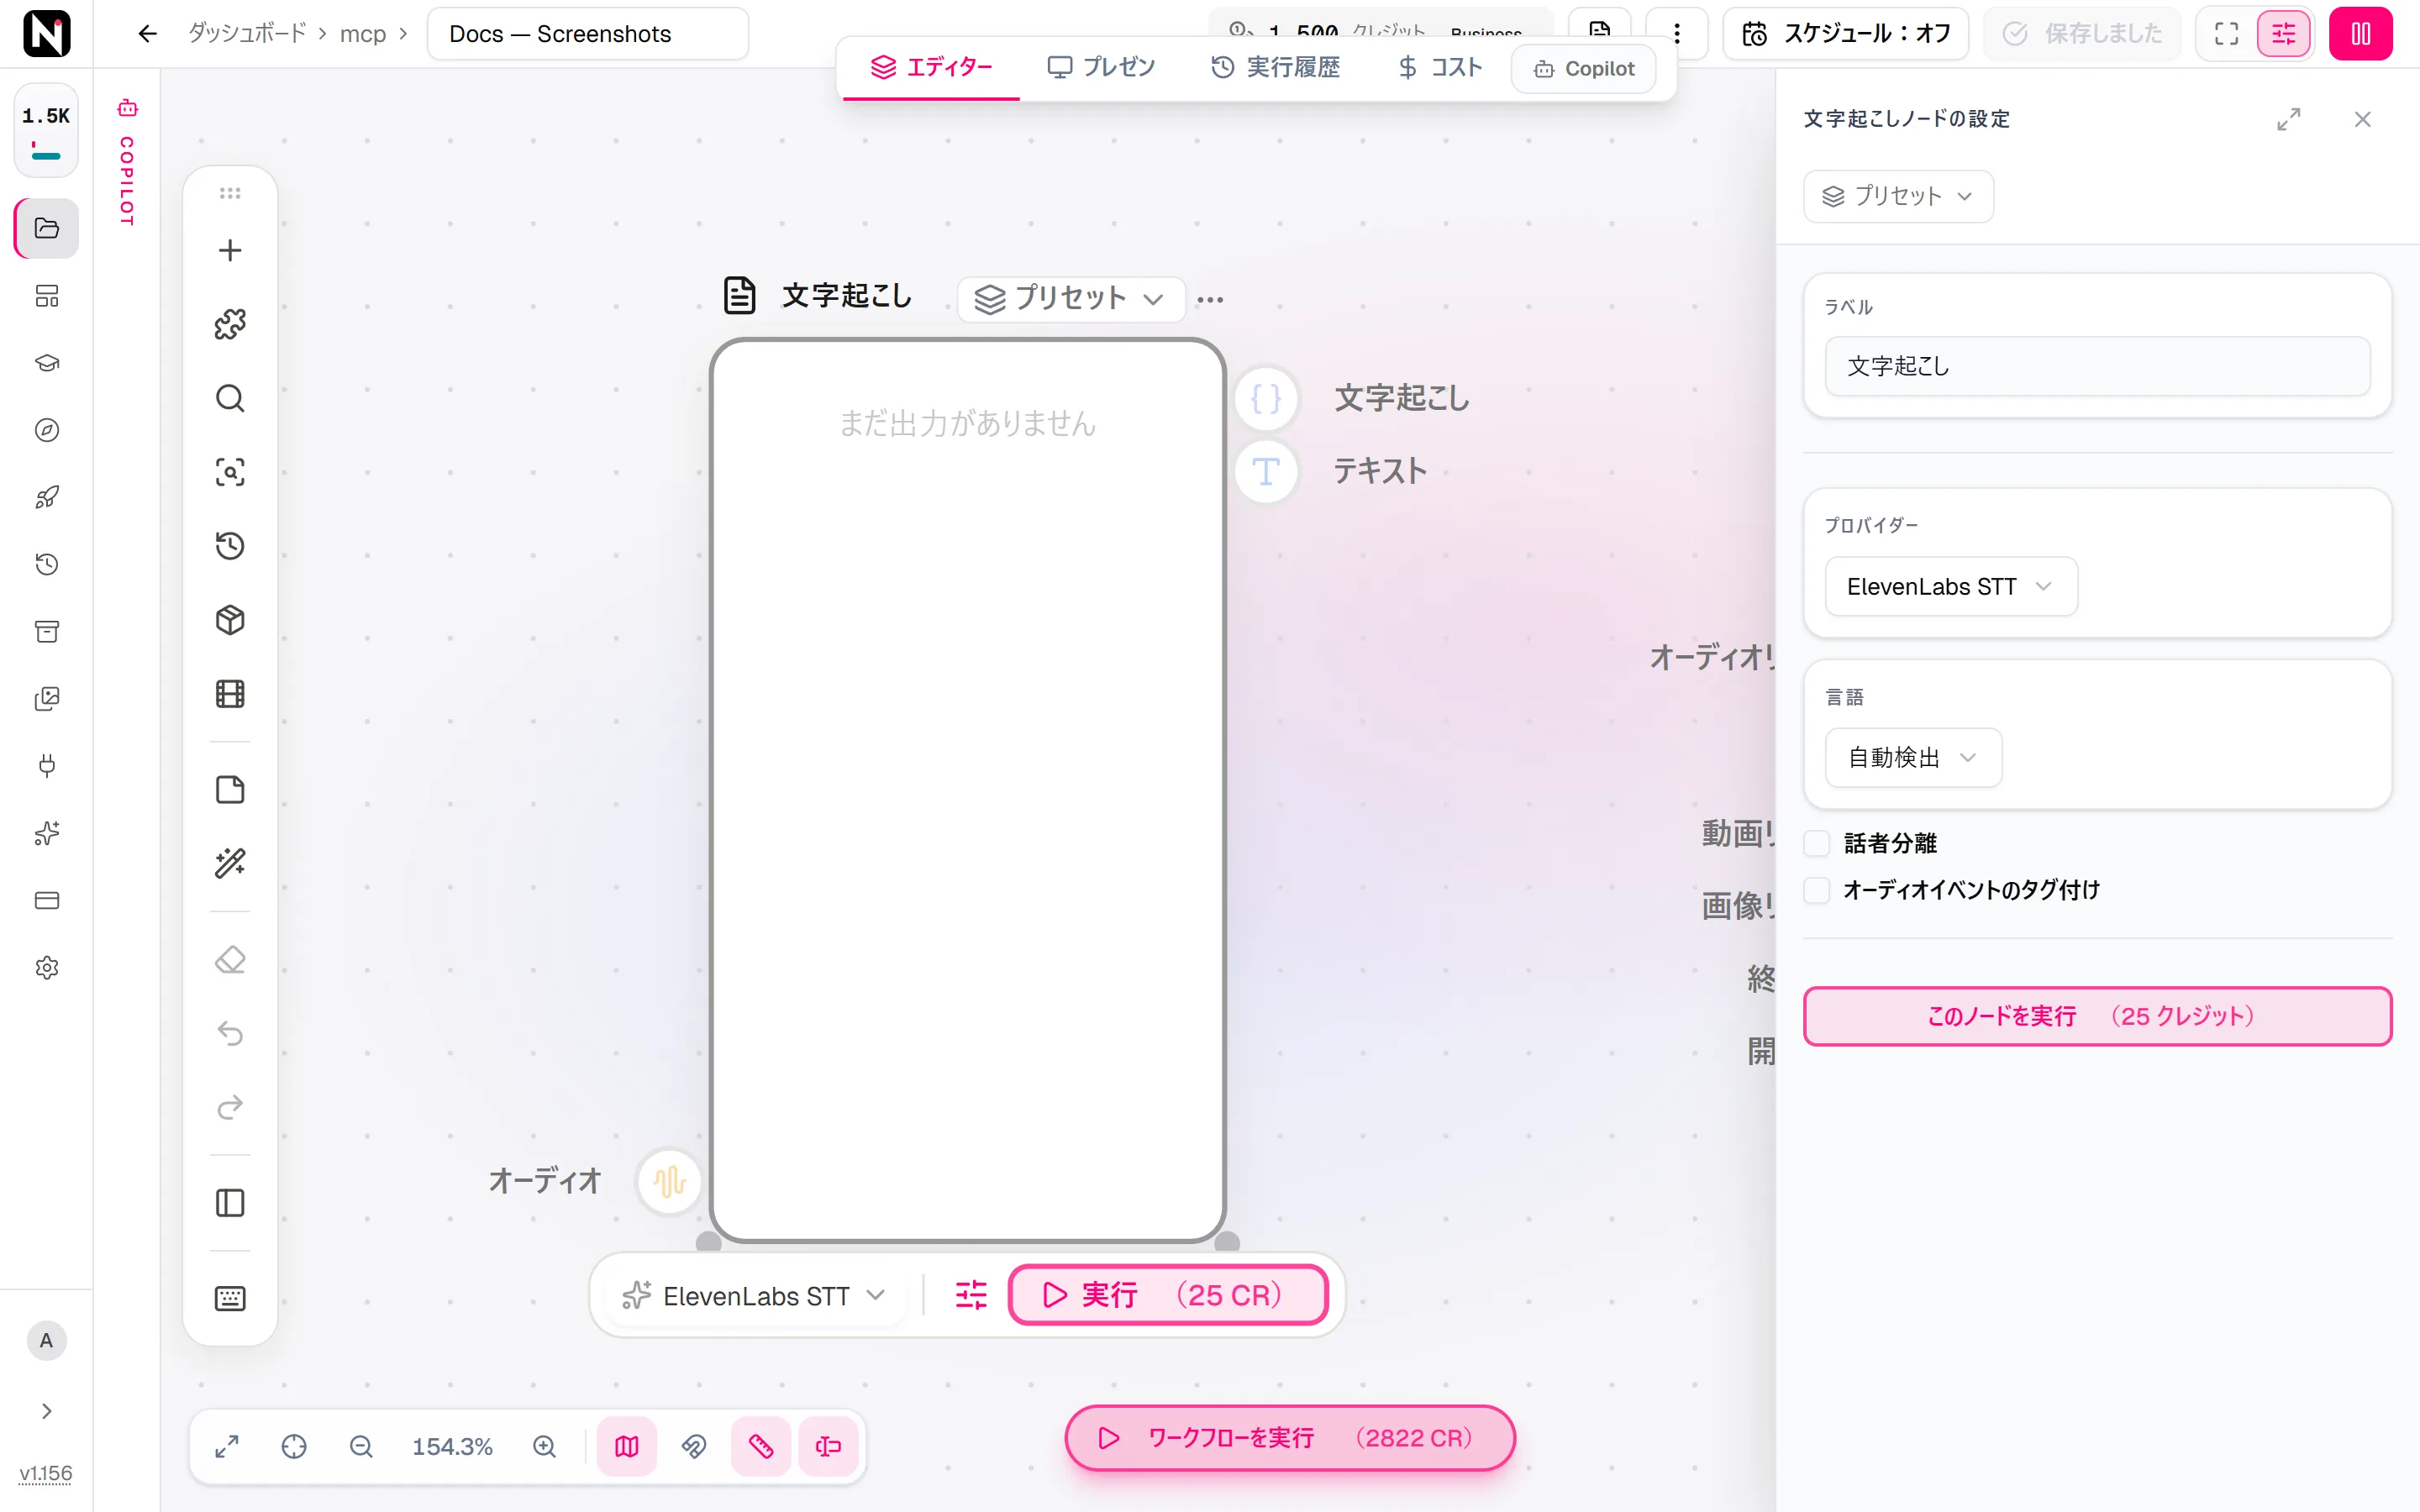
設定パネルを開きます。ほかのエンジンが必要でなければ、プロバイダーは ElevenLabs STT のままにします。言語は自動検出のままにするか、言語を選びます。
実行する
ノードの実行をクリックします。プレーンな文字起こしはテキスト出力に、タイミング付きの文字起こしは文字起こし出力に表示されます。
入力と出力
| 入力 | 接続できるノード | 説明 |
|---|---|---|
| オーディオ | オーディオ系と動画系のノード | 文字起こしする音声です。動画の場合、ノードはその音声トラックを使います。 |
動画がある場所へのリンクから動画を文字起こしするには、動画 URLノードを接続します。動画 URL ノードがコンテンツ権利の宣言の確認を求めて音声を取得し、文字起こしがそのトラックを文字起こしします。ほかの方法で文字起こしに動画のページへのリンクを渡すと、エディターでの実行は止まり、メッセージでそのことが示されます。
| 出力 | 内容 |
|---|---|
| テキスト | 文字起こし全体を、プレーンなテキストにしたものです。テキストを受け付けるどのノードにも接続できます。 |
| 文字起こし | ミリ秒単位の単語とセグメントのタイミングが入った、構造化された文字起こしです。字幕を追加や編集系のノードに渡します。 |
プロンプトの中で {Transcribe} のようにノードのラベルを参照すると、プレーンなテキストが入ります。
設定
| 設定 | 説明 |
|---|---|
| プロバイダー | エンジンです。ElevenLabs STT(デフォルト)、Whisper — 単語タイミングなし、Incredibly Fast Whisper、Nemotron 3.5 Transcribe のいずれかです。 |
| 言語 | 自動検出(デフォルト)か、英語、スペイン語、ヘブライ語、日本語、アラビア語など 20 の言語のいずれかです。Nemotron 3.5 Transcribe では表示されません。このエンジンは、40 の言語の中から話されている言語を自分で検出します。 |
| 翻訳先 | プロバイダーが Nemotron 3.5 Transcribe のときだけ表示されます。翻訳しない(デフォルト)では文字起こしを返します。言語を選ぶと、代わりにその言語への翻訳を返します。音声を翻訳するを参照してください。プロバイダーをほかのエンジンに切り替えると、この設定はクリアされます。 |
| 話者分離 | 誰が何を話したかを、ラベルで示します。デフォルトはオフです。プロバイダーが ElevenLabs STT のときだけ表示されます。 |
| オーディオイベントのタグ付け | [music] や [laughter] など、話し声以外の音を文字起こしの中に記します。デフォルトはオフです。プロバイダーが ElevenLabs STT のときだけ表示されます。 |
話者分離とオーディオイベントのタグ付けは、互いに独立した設定です。どちらか一方だけをオンにすることも、両方をオンにすることも、どちらもオフのままにすることもできます。
モデル
| モデル | 開発元 | モード | クレジット | 詳細 |
|---|---|---|---|---|
| ElevenLabs STT | ElevenLabs | 文字起こし | 25 | 単語単位のタイムスタンプ(常にオン)、話者の識別、効果音イベントのタグ付きで文字起こしをします。文字起こしを字幕に使うときは、このエンジンを選んでください。 |
| Incredibly Fast Whisper | OpenAI | 文字起こし | 44 | Whisper による高速な文字起こしです。指定すると単語単位のタイムスタンプを返すため、その文字起こしを字幕に使えます。 |
| Whisper | OpenAI | 文字起こし | 44 | Whisper による文字起こしで、返すのはフレーズ単位のセグメントのみ、単語のタイムスタンプはありません。文字起こしや静的な字幕には十分ですが、単語ごとにタイミングを合わせる(キネティックな)字幕には向きません。 |
| Nemotron 3.5 Transcribe | NVIDIA | 文字起こし | 4 | NVIDIA による 40 言語の音声の文字起こしで、言語は自動で検出され、単語の誤り率が低いのが特長です。指定すると単語ごとに話者ラベルを付けた単語単位のタイムスタンプを返すので文字起こしを字幕に使えるほか、文字起こしの代わりに音声を翻訳することもでき(英語への翻訳か英語からの翻訳で、ほかの言語の音声は英語に、英語の音声は 31 言語のいずれかに訳します)、その場合は単語のタイミングは付きません。ファイルは最大 60 分、200 MB までです。料金はオプションにかかわらず、ファイルの長さを 1 分単位(端数は切り上げ)で数えて決まり、掲載の料金は 4 分の場合です。 |
単語のタイミング:どのエンジンが返すか
| エンジン | 単語のタイミング | 備考 |
|---|---|---|
| ElevenLabs STT(デフォルト) | 常に返す | 設計上、単語単位です。字幕、話者のラベル、オーディオイベントに使うエンジンです。 |
| Incredibly Fast Whisper | 必要なときに返す | 文字起こし出力が接続されていると、ノードが自動で単語のタイミングを要求します。 |
| Whisper | 返さない | フレーズ単位のセグメントだけです。プレーンな文字起こしや静的な字幕なら、これで十分です。 |
| Nemotron 3.5 Transcribe | 必要なときに返す | 文字起こし出力が接続されていると、ノードが自動で単語のタイミングを要求します。その場合、各単語に話者が付きます。翻訳には単語のタイミングが付きません。 |
明らかに話し声があるオーディオに対して、ElevenLabs STT、Incredibly Fast Whisper、Nemotron 3.5 Transcribe が単語のタイミングを返さなかった場合、実行は失敗し、クレジットは返還されます。話し声がまったくないオーディオは、単語なしのまま成功します。たとえば、[music] と文字起こしされるクリップです。
音声を翻訳する
翻訳先を設定すると、Nemotron 3.5 Transcribe は音声を文字起こしする代わりに翻訳します。翻訳は英語との間で行われます。
- 英語へ:ほかの言語の音声を、英語のテキストにします。
- 英語から:英語の音声を、中国語、日本語、韓国語、フランス語、ドイツ語、スペイン語、ポルトガル語、イタリア語、ロシア語、オランダ語、ポーランド語、チェコ語、スロバキア語、ヒンディー語、ブルガリア語、クロアチア語、デンマーク語、エストニア語、フィンランド語、ハンガリー語、ラトビア語、リトアニア語、ルーマニア語、スロベニア語、スウェーデン語、タイ語、ウクライナ語、アラビア語、ギリシャ語、ヘブライ語、マルタ語のテキストにします。
英語以外の 2 つの言語の間の翻訳もできる場合がありますが、保証はされません。最良の結果を得るには、英語に翻訳してください。
- テキスト出力には翻訳が入り、文字起こしの
languageは翻訳先の言語になります。 - 翻訳には単語のタイミングがないため、文字起こし出力の
wordsのリストは空になります。翻訳するノードが字幕を追加につながっている場合、実行は開始前に拒否されます。 - 翻訳できるのは Nemotron 3.5 Transcribe だけです。翻訳の料金は、文字起こしと同じです。
Nemotron 3.5 Transcribe が受け付けるファイル
Nemotron 3.5 Transcribe は、最大 60 分、200 MB までのファイルを受け付けます。ファイルは MP3、WAV、M4A または AAC、FLAC、OGG または Opus、WEBM のオーディオか、音声トラックのある MP4 または MOV の動画です。公開ホスト上のファイルへの、HTTPS の直接リンクである必要があります。
- 先に測定:料金が長さで決まるため、ノードはクレジットを確保する前にファイルを測定します。
- 料金なしで拒否されるもの:HTTPS ではないリンク(
invalid_media_url)、60 分または 200 MB を超えるファイル、ソーシャルプラットフォーム上の動画のページへのリンクです。ホストが存在しないリンクや、プライベートまたは予約済みのアドレスを指すリンクも、media_link_bad_hostで拒否されます。メディアのリンクを参照してください。そのような動画は、先に 動画 URLノードで音声を取り込むか、ほかのエンジンを選んでください。 - 60 分は厳密です:モデルはリンクからファイルを読み込むため、ファイルを切り詰めることはできません。60 分のつもりのカットが 1 秒未満でも長くなった場合も、
media_duration_exceeds_limitで拒否されます。少し短くカットしてください。 - その時点で名前を解決できないホストは
503 source_unreachableになります。ノードをもう一度実行してください。 - 事前に長さを読めないファイルは、拒否されません。ストリームとして保存されたブラウザーの録音や、断片化された MP4 では 60 分の料金が確保され、モデルがデコードした長さで課金されます。
- 話者:単語のタイミングを付けると、声がはっきり異なる話者はよく分かれます。似た声は、1 人の話者にまとめられることがあります。
- 繰り返されるテキスト:回答がオーディオに対するモデルの長さの上限に達すると、ジョブの出力に
truncated: trueが付きます。これは通常、モデルが同じことを繰り返していることを意味するので、結果を確認するか破棄してください。
構造化された文字起こし
文字起こし出力は、次のような形です。
{
  "version": 1,
  "language": "en",
  "words": [
    { "text": "Welcome", "startMs": 0, "endMs": 420 },
    { "text": "back", "startMs": 460, "endMs": 700 }
  ],
  "segments": [
    { "startMs": 0, "endMs": 700, "text": "Welcome back" }
  ]
}- 時間はすべて、ミリ秒単位の整数です。
wordsには、すべての単語が開始と終了の時間とともに入ります。エンジンが単語のタイミングを返すときは、常に値が入ります。segmentsには、より大きな単位の文やフレーズが入ります。エンジンがそれを返す場合だけです。- 話者分離をオンにした実行では、各単語と各セグメントに
speakerも付きます。単語にはconfidenceが付くこともあります。
テキスト出力では、話者分離によって各セグメントの前に Speaker 1: のようなラベルが付き、オーディオイベントのタグ付けによって [music] や [laughter] のようなタグが、その音の位置に入ります。
文字起こしから字幕を作る
文字起こし出力を、字幕を追加の文字起こし入力に接続します。すると字幕を追加が、各単語のタイミングに合わせて字幕を描きます。これには ElevenLabs STT、Incredibly Fast Whisper、Nemotron 3.5 Transcribe のいずれかを使います。
Whisper の文字起こしでは字幕を作れません。Whisper を使う文字起こしノードが字幕を追加につながっている場合、何かが実行されたり課金されたりする前に、次のメッセージとともに実行が拒否されます。
Captions need word timings, but the "whisper" engine does not return word timings — pick incredibly-fast-whisper or elevenlabs-stt.- 翻訳するように設定した Nemotron 3.5 Transcribe のノードも、翻訳には単語のタイミングがないため、同じように拒否されます。実行するには、翻訳先を翻訳しないにします。
- このチェックは、EDL 適用を経由するつながりや、どの深さのサブワークフロー内のつながりも対象にします。
- 接続した時点で、設定パネルのプロバイダーの横にも同じ警告が表示されるので、実行する前に修正できます。
- 文字起こしノードを単独で実行する場合は、ブロックされることはありません。Whisper の文字起こしを、ほかの場所に渡すのも問題ありません。
- 事前にチェックできないケースが 1 つあります。文字起こしと字幕を追加が、サブワークフローの境界をはさんで別々の側にあるつながりです。この場合、文字起こしが実行されて課金された後に、字幕を追加で実行が失敗します。
クレジット
3 つのエンジンの料金は、オーディオの長さにかかわらず、1 回の実行ごとの定額です。
| エンジン | 1 回の実行あたりのクレジット |
|---|---|
| ElevenLabs STT | 25 |
| Incredibly Fast Whisper | 44 |
| Whisper | 44 |
Nemotron 3.5 Transcribe は、ファイルの長さで料金が決まります。オーディオの開始した 1 分ごとに、最大 60 分まで課金されます。単語のタイミングや翻訳を付けても料金は同じです。分を合計し、実行全体で 1 回だけ整数のクレジットに切り上げます。
- 1 分を 1 秒まで超える分は、下の分数になります:1 分ちょうどを 1 秒まで超えるファイルは、その分数として確保と課金が行われるため、1:00.8 のファイルは 1 分として課金されます。再エンコードしたカットや結合は、長さを 100 分の数秒超えて測定されることがよくあります。1 秒を超えると、次の 1 分が始まります。
- 実行の前:ノードの料金、実行ボタン、ワークフローの見積もり、アプリに表示される料金には、ワークフローがわかっている長さの開始した分数が表示されます。それは、アップロードの記録された長さ、実行の中で別のノードがその設定で作る長さ(トリミングの範囲や生成の長さ)、または実行されないノードの結果とともに記録された長さです。1 分を少し超える既知の長さは次の分数で表示され、実行では低いほうで課金されます。長さがまだわからない場合は、60 分の料金が表示されます。
- 実行の中でもう一度作られる音声(テキストから音声など)は、現在保持しているテイクの長さで見積もられます。これは最低額です。新しい音声はより長くなることがあり、実行では測定した分数で課金されます。
- 確保:実行の前にファイルを測定し、その長さの料金を確保します。長さを読めないファイルでは、60 分の料金を確保します。
- 課金:実行の後、モデルが実際にデコードした長さで課金されます。MP3 ファイルの中には長さを誤って記録しているものがあるため、ファイルのヘッダーにある長さとは異なることがあります。長さが短ければ確保の残りが解放され、長ければその差額が残高から引かれます。
字幕を追加に接続された Whisper の文字起こしのように、開始前に拒否されたリクエストには料金がかかりません。
セルフホスティング環境の場合
各エンジンは、自分のプロバイダーキーで動きます。選んだエンジンのキーがなく、環境に Nodaro Cloud への接続がある場合、文字起こしはその接続を通じて実行されます。どちらもない場合、ノードは失敗し、追加すべきキーを示すメッセージが表示されます。プロバイダーキーを参照してください。
ヒント
- 言語は自動検出のままにする:言語を選ぶのは、その言語がわかっている場合だけにします。たとえば、2 つの言語の響きが似ている場合です。
- 会話では話者にラベルを付ける:インタビュー、会議、ポッドキャストでは、話者分離をオンにします。
- 必要なときはイベントにタグを付ける:背景の音が録音の理解に役立つ場合は、オーディオイベントのタグ付けをオンにします。
- ノイズの多いオーディオは先にクリーンにする:文字起こしの前に、録音を音声抽出に通します。
- とても長いオーディオは分割する:短いセグメントのほうが、確実に文字起こしできます。チャンクに分割は、長いファイルを最小と最大の長さの間のパートに分け、文字起こしはパートごとに 1 回実行されます。
- 代わりに手元の台本を合わせる:正確な台本がすでにある場合は、強制アライメントが、台本の各単語のタイミングをオーディオに合わせて求めます。
API から
POST /v1/transcribe は、audioUrl と、任意の provider(elevenlabs-stt、incredibly-fast-whisper、whisper、nemotron-3-5-transcribe)、language、diarize、tagAudioEvents、wordTimestamps、targetLanguage を受け取ります。
-
動画のページへのリンク:ソーシャルプラットフォーム上の動画のページにリンクする
audioUrlは、そのリンクのインポートです。先に音声が取得されます。そのリンクについて、POST /v1/content-rights/confirmで得たconfirmationIdを送ってください。送らない場合、確認を必須とするデプロイ環境では、ジョブが作成される前にリクエストが403で拒否されます。アカウントに継続的な承認があるキーやエージェントでは確認は不要で、ファイルへの直接リンクにも不要です。コンテンツ権利を参照してください。 -
エンジンを指定する:
providerのないリクエストは Whisper で実行されるので、既存の呼び出し元はこれまでと同じエンジンを使い続けます。単語のタイミング、diarize、tagAudioEventsが必要な場合は、必ずproviderを設定してください。 -
単語のタイミング:
incredibly-fast-whisperとnemotron-3-5-transcribeが単語を返すのは、wordTimestamps: trueを指定した場合だけです。whisperでwordTimestamps: trueを指定すると、ジョブが作成される前に400 validation_errorで拒否されるので、料金はかかりません。エンジンが知らないうちに切り替えられることはありません。 -
翻訳:
targetLanguageはnemotron-3-5-transcribeでだけ使えます。ほかのエンジンで指定した場合、翻訳できない言語を指定した場合、wordTimestamps: trueと一緒に指定した場合は、targetLanguageについての400 validation_errorで拒否され、料金はかかりません。 -
字幕:完了したジョブの
output_data.wordsは、すでに字幕の形(text、startMs、endMs)になっています。これをcaptionsとしてPOST /v1/add-captionsに渡せば、字幕を追加がもう一度文字起こしすることはありません。 -
料金:
GET /v1/credits/model-cost?model=<engine>は、自分のアカウントでの正確な料金を返します。Nemotron 3.5 Transcribe では、nemotron-3-5-transcribe:<minutes>mを指定します。
SDK のメソッドは client.audio.transcribe、CLI のコマンドは nodaro audio transcribe --provider <engine> で、翻訳には --target-language を付けます。MCP ツールの transcribe は、エンジンを model で、翻訳を target_language で受け取ります。model がない場合は ElevenLabs STT で実行されるので、その結果には単語のタイミングが含まれます。音声とメディアを参照してください。
よくある質問
どの文字起こしエンジンを選べばよいですか?
デフォルトの ElevenLabs STT のままにしてください。常に単語のタイミングを返し、話者のラベル付けやオーディオイベントのタグ付けもでき、最も安価です。Incredibly Fast Whisper と Nemotron 3.5 Transcribe も、ノードが必要とする場合は単語のタイミングを返します。Nemotron 3.5 Transcribe はファイルの長さで料金が決まり、音声を翻訳することもできます。Whisper が返すのはフレーズだけです。
文字起こしノードと「字幕を追加」ノードを使ったワークフローが拒否されたのは、なぜですか?
文字起こしノードが Whisper を使っているためです。Whisper は単語のタイミングを返しませんが、字幕にはそれが必要です。「プロバイダー」を ElevenLabs STT、Incredibly Fast Whisper、Nemotron 3.5 Transcribe のいずれかに切り替えて、もう一度実行してください。翻訳には単語のタイミングがないため、翻訳するように設定したノードも拒否されます。料金はかかりません。
文字起こしノードには、何クレジットかかりますか?
ElevenLabs STT は 1 回の実行あたり 25 クレジット、Incredibly Fast Whisper は 44 クレジット、Whisper は 44 クレジットで、オーディオの長さにかかわりません。Nemotron 3.5 Transcribe は、ファイルの開始した 1 分ごとに、最大 60 分まで課金されます。
文字起こしノードは、話者を区別できますか?
はい。ElevenLabs STT なら区別できます。「話者分離」をオンにすると、テキストの各セグメントに「Speaker 1:」(話者 1)のような話者のラベルが付きます。構造化された文字起こしでは、各単語にも話者が記録されます。Nemotron 3.5 Transcribe も、単語のタイミングを返すときは各単語に話者を付けます。
文字起こしノードで、音声を翻訳できますか?
はい。Nemotron 3.5 Transcribe なら翻訳できます。「翻訳先」を設定すると、ノードは文字起こしの代わりに翻訳を返します。ほかの言語の音声を英語に、または英語の音声を 31 の言語のいずれかに翻訳します。翻訳には単語のタイミングがありません。
動画を文字起こしできますか?
はい。動画を「オーディオ」入力に接続すると、ノードがその音声トラックを文字起こしします。
関連ページ
字幕を追加
強制アライメント
編集プラン
音声抽出
ElevenLabs STT
最終更新