
 Nodaro 문서
프레임 한 장으로 만드는 카메라 앵글 10개
Nodaro에서 AI 이미지 한 장을 같은 장면의 카메라 앵글 10개로 바꿉니다. LLM이 샷 목록을 쓰고, 이미지 생성 노드 하나가 모든 앵글을 렌더링합니다.
카메라 커버리지 튜토리얼은 이미지 한 장을 같은 장면의 샷 10개로 바꿉니다. 와이드, 미디엄, 클로즈업, 오버 더 숄더, 리버스, 인서트, 로 앵글, 옆모습입니다. LLM이 이미지를 읽고 샷 목록을 쓰면, 목록이 이미지 생성 노드 하나를 샷마다 한 번씩 실행합니다. 캐릭터, 의상, 장소, 조명은 그대로이고 카메라만 바뀝니다.
레퍼런스 프레임
장면은 GPT Image 2가 짧은 프롬프트로 만든 이미지 한 장에서 시작합니다.
번역된 프롬프트입니다. 모델에는 아래에 있는 영어 원문을 보냈습니다.
영어 원문 프롬프트
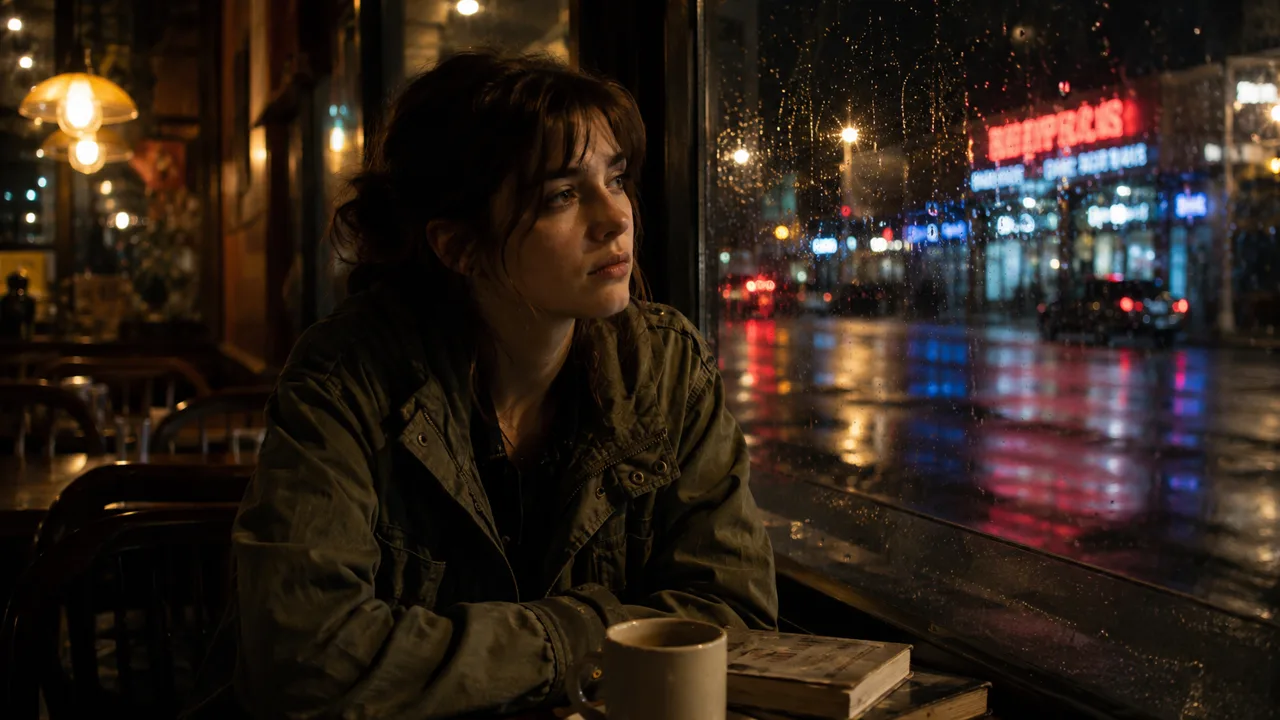
워크플로가 샷을 계획하는 방식
- 텍스트 노드에 장면이 담기고, 이미지 생성이 그 장면으로 레퍼런스 프레임을 만듭니다.
- 두 번째 텍스트 노드에는 커버리지 브리프가 담깁니다. 실제 영화 촬영의 커버리지 규칙으로, 아래에 나와 있습니다.
- 텍스트 생성 - 모든 LLM 노드가 레퍼런스 프레임과 브리프를 읽고, GPT-5.2가 카메라 설정 10개를 한 줄에 하나씩 씁니다.
- 텍스트 분할이 10줄을 항목 10개로 나누고, 목록이 이를 편집할 수 있는 행으로 보여 줍니다.
- 이미지 생성 노드 하나가 목록을 프롬프트로, 레퍼런스 프레임을 레퍼런스로 받습니다. 행마다 한 번씩 실행되므로 행 10개가 이미지 10장을 만듭니다.
샷을 실행하기 전에 목록의 어느 행이든 편집하세요. 그러면 원하는 계획에만 크레딧을 씁니다.
바꿀 부분은 브리프입니다. 다음은 LLM이 받은 브리프를 그대로 옮긴 것입니다.
번역된 프롬프트입니다. 모델에는 아래에 있는 영어 원문을 보냈습니다.
영어 원문 프롬프트
샷 10개
각 샷 아래에는 LLM이 쓴 줄이 있습니다. 이 줄이 그 이미지의 프롬프트 전부였습니다.
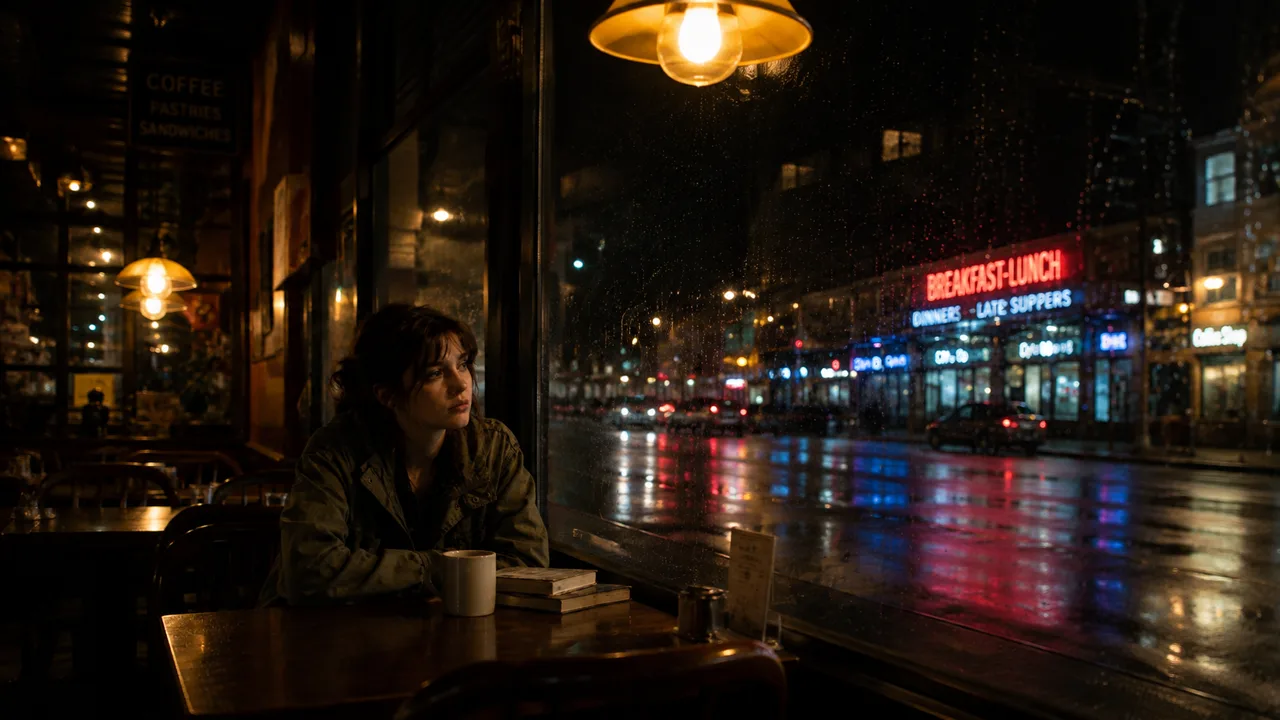
Wide establishing shot from inside the cozy café, woman seated left of frame beside rain-streaked window, neon-lit street outside, warm tungsten lighting, ample headroom.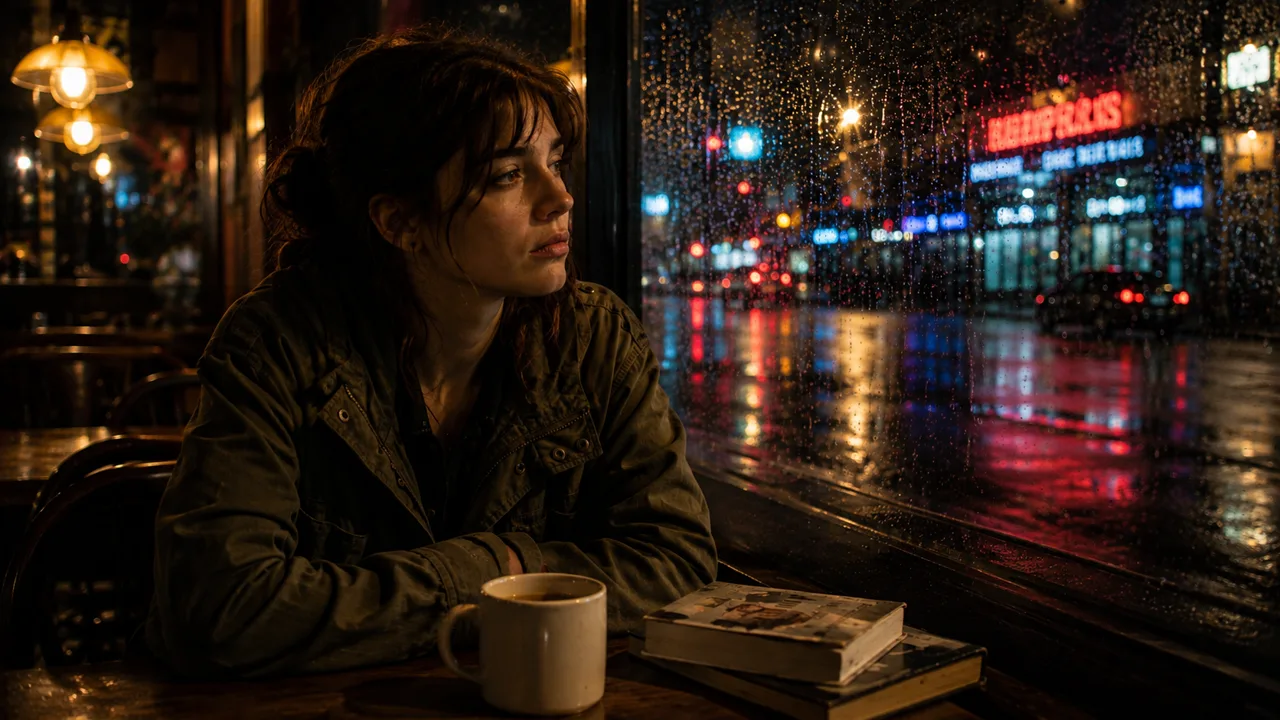
Medium waist-up from across the table, woman left of frame gazing through rain-covered glass, coffee mug and books foreground, identical night lighting.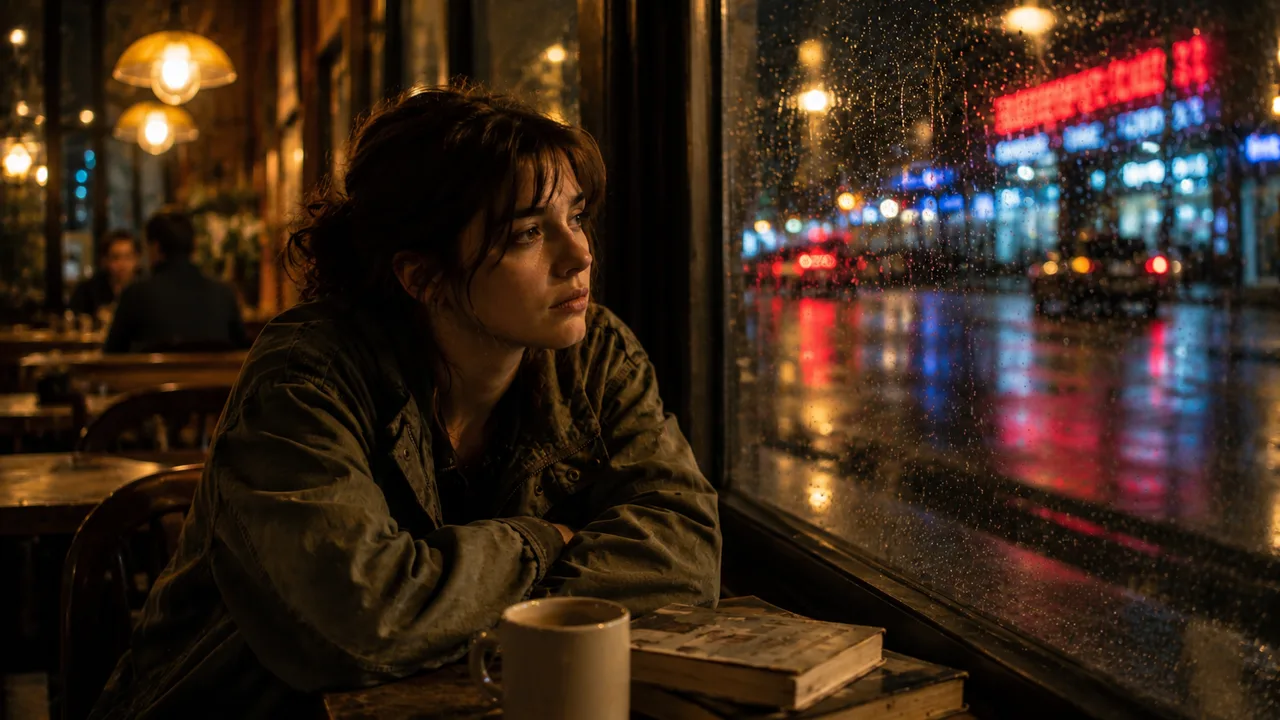
Medium three-quarter side view from café aisle, woman left of frame leaning on folded arms beside window, reflections shimmering outside, warm interior glow.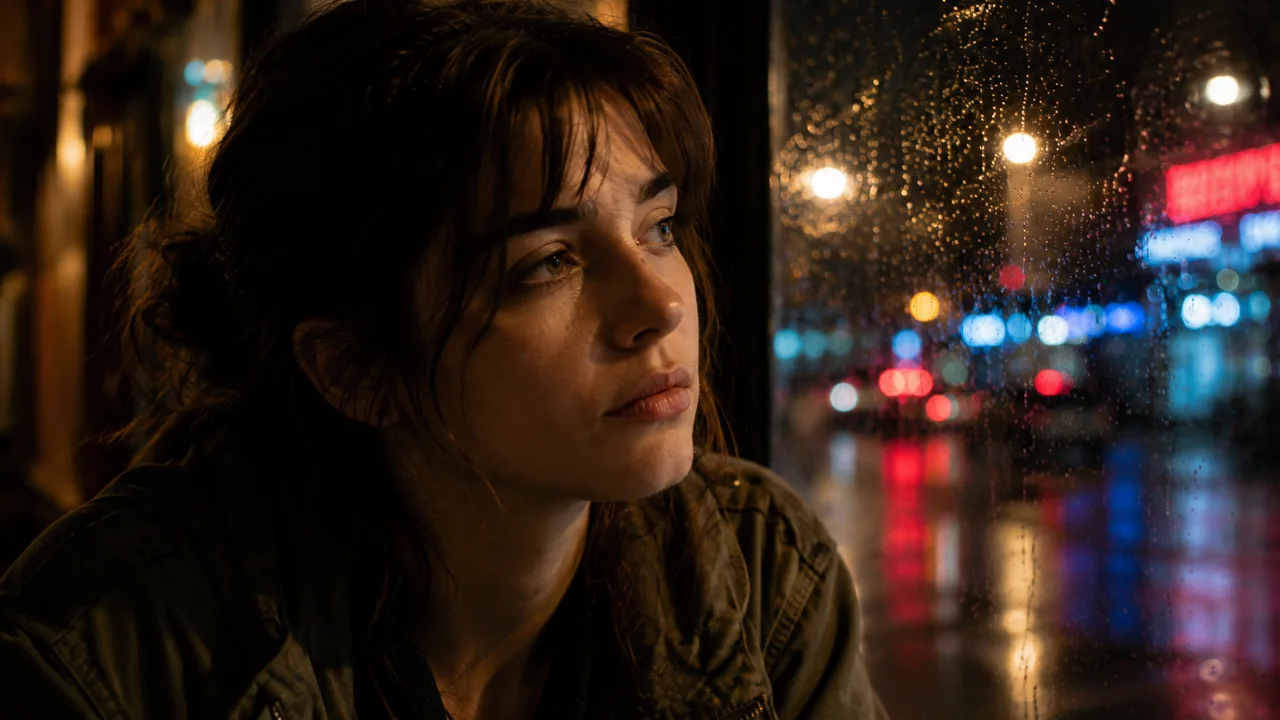
Close-up on her face in profile-three-quarter, eyes fixed outside, raindrops and neon bokeh behind, soft warm café lighting, breathing room around head.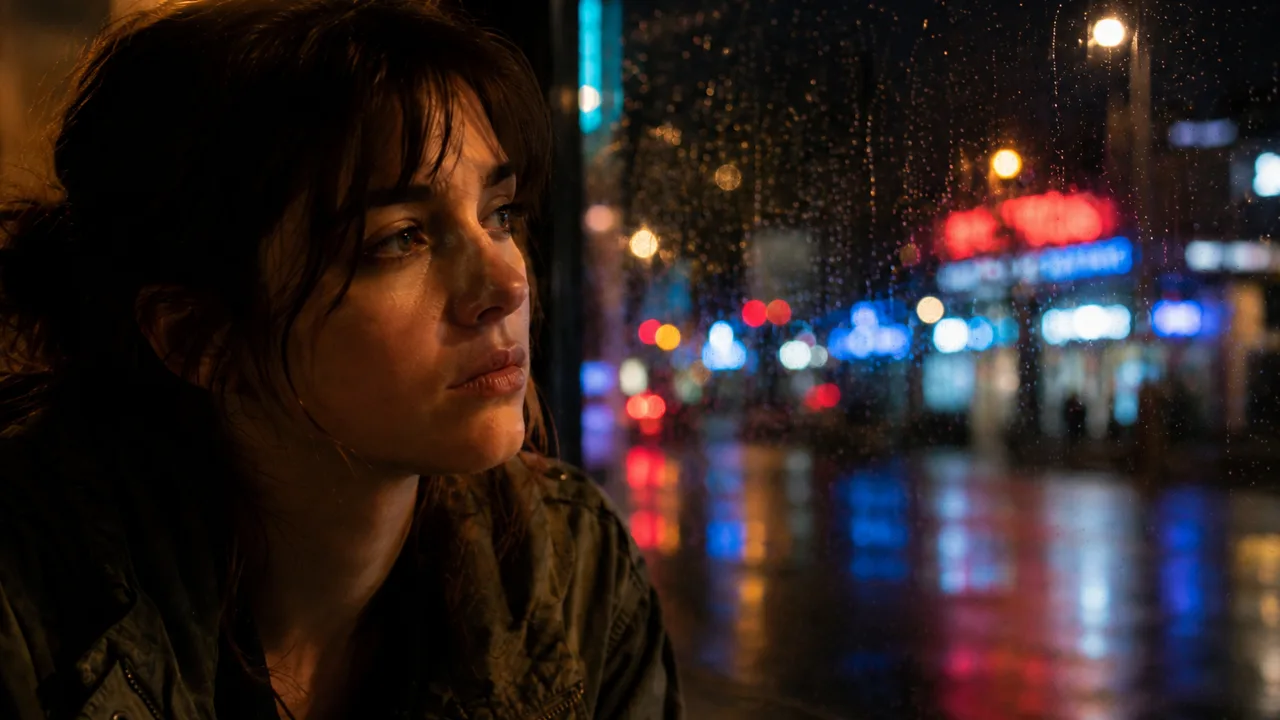
Tight close-up of her thoughtful expression, window reflections crossing her face, identical wardrobe and lighting, negative space ahead of her gaze.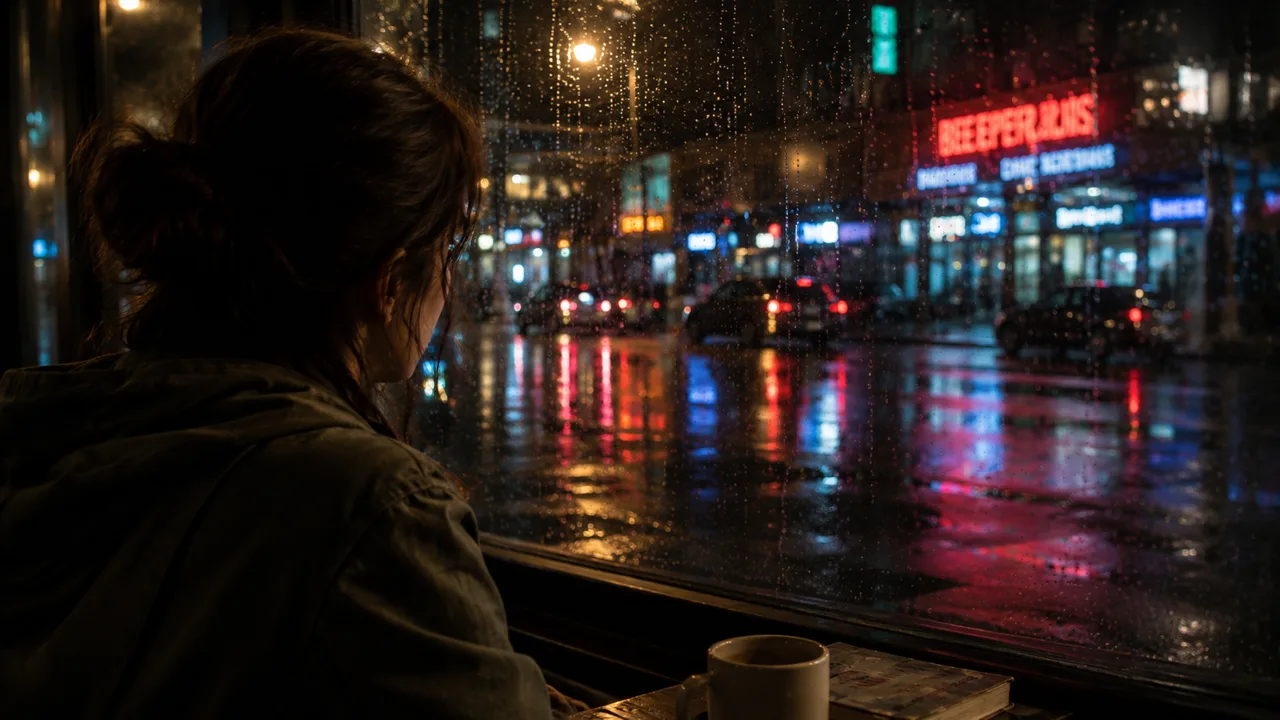
Over-the-shoulder from behind her left shoulder toward the rain-soaked street, her silhouette and jacket foreground, neon storefronts beyond, consistent screen direction.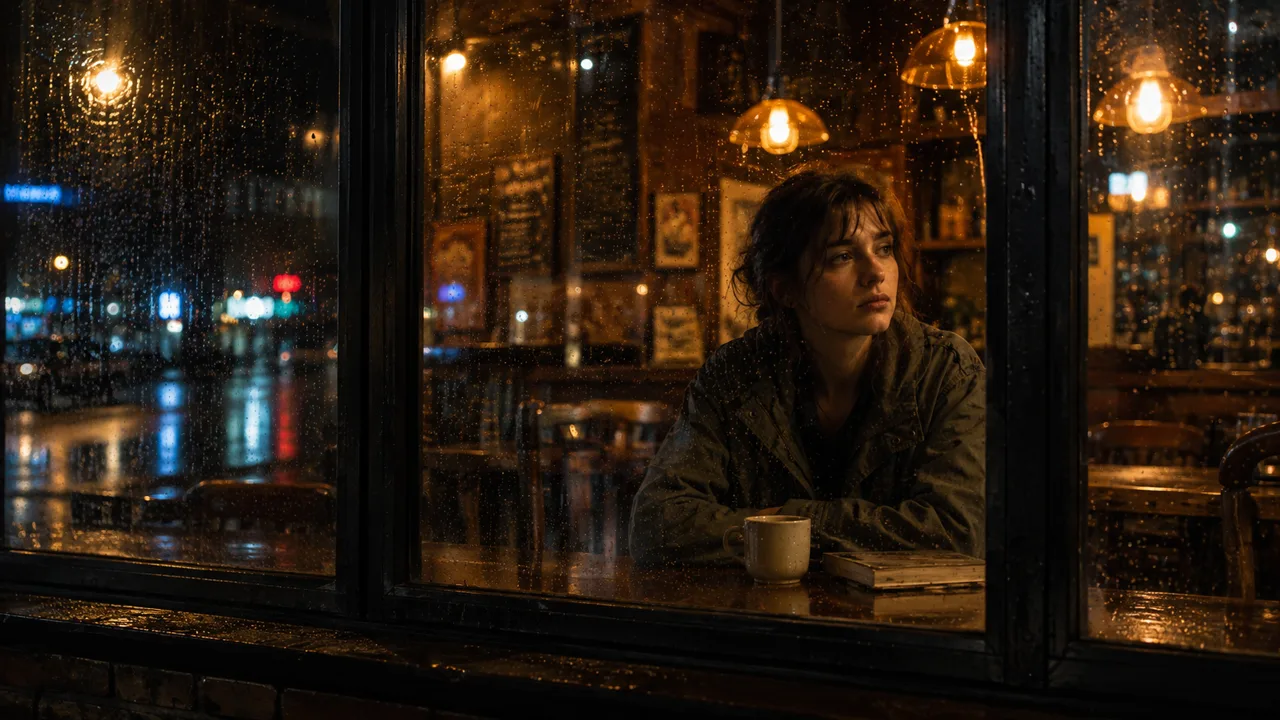
Reverse angle from outside the window toward the café interior, rain-speckled glass foreground, woman visible inside watching the street, warm interior contrasting cool night.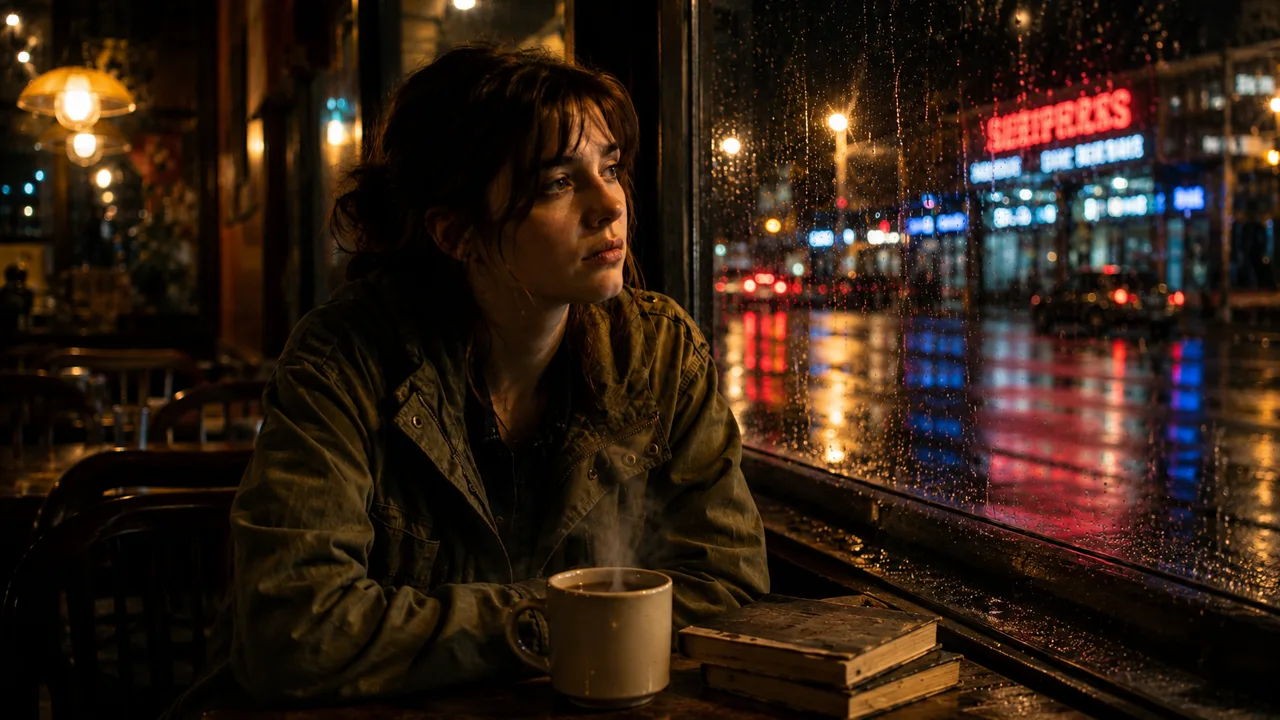
Insert detail of steaming coffee mug, worn books, and raindrops on the windowsill, warm café light reflecting across wet surfaces.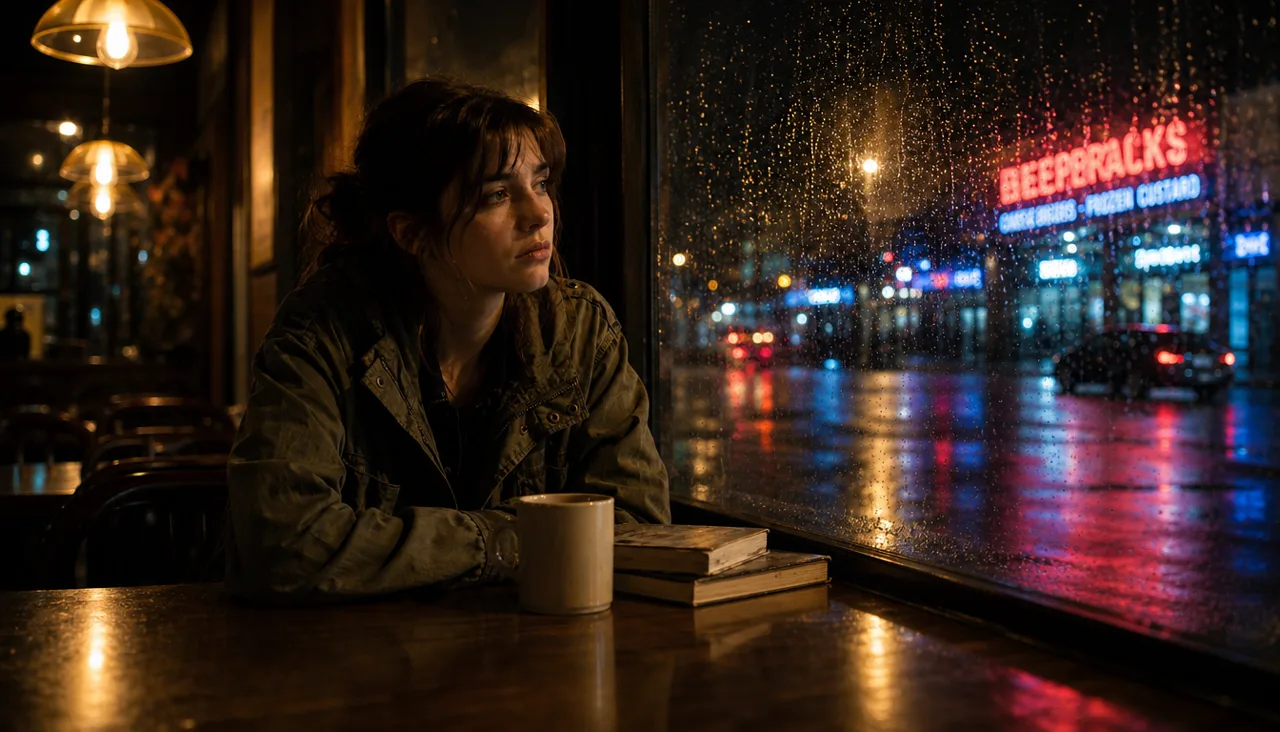
Low-angle medium shot from table height, woman left of frame against glowing window and neon reflections, same wardrobe, location, and nighttime lighting.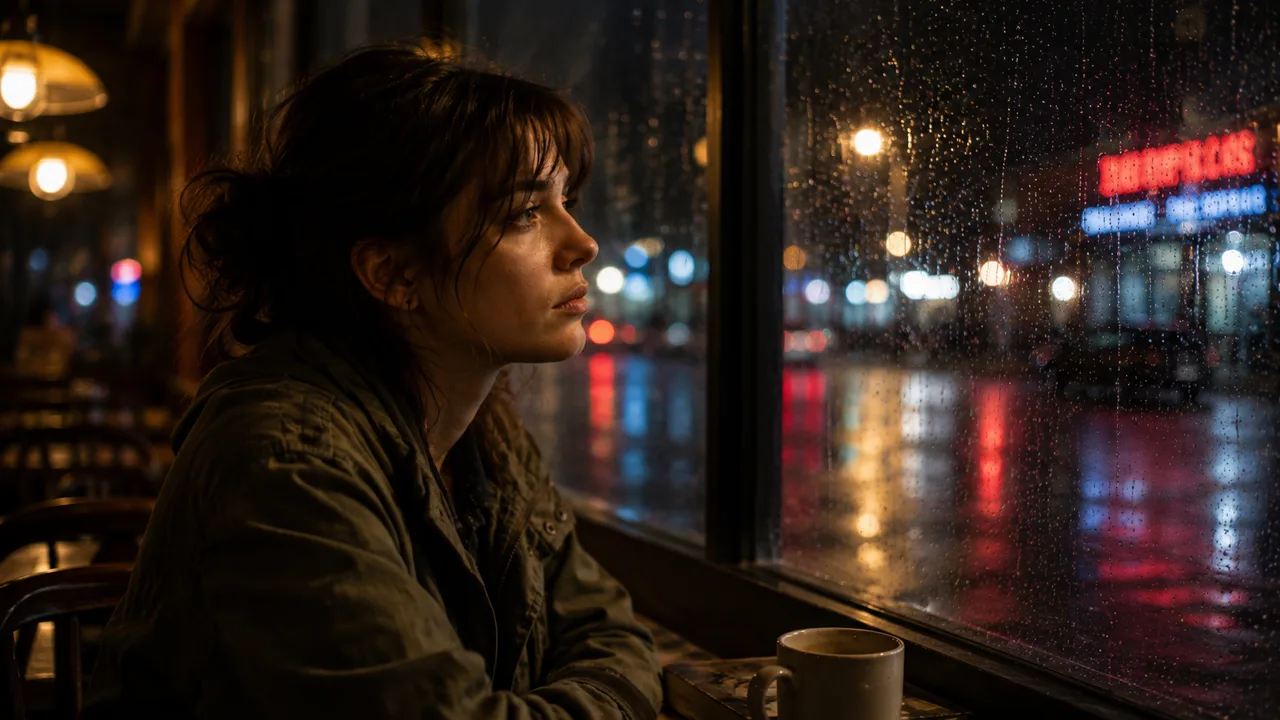
Clean side-profile shot parallel to the window, woman left of frame facing right toward the rain, café interior softly receding behind her.유지된 것과 유지되지 않은 것
- 장면은 유지되었습니다. 여성, 올리브색 재킷, 카페, 비, 밤의 조명이 10샷 모두에서 일치합니다. 각 샷이 레퍼런스 프레임을 레퍼런스 이미지로 사용했고, 그 덕분에 일관성이 유지됩니다.
- 샷 하나는 계획을 벗어났습니다. 인서트는 머그잔과 책만 담은 디테일로 계획했습니다. GPT Image 2가 여성을 프레임에 남겼기 때문에 8번 샷은 또 하나의 미디엄 샷이 되었습니다. 제대로 된 인서트를 얻으려면 그 행을 다시 쓰거나 다시 실행하세요.
- 네온사인은 지어낸 것입니다. 모델이 바깥 간판에 존재하지 않는 단어를 썼으므로, 샷을 쓰기 전에 글자를 확인하세요.
내 것으로 만들기
- 새 장면: 첫 번째 텍스트 노드의 장면을 바꾸고 워크플로를 처음부터 실행하세요. 커버리지 계획은 그대로입니다.
- 다른 계획: 브리프를 바꿔 샷 6개, 다른 순서, 또는 다큐멘터리, 액션, 인터뷰 같은 다른 종류의 커버리지를 요청하세요.
- 한 번에 앵글 하나: 이미지 생성을 실행하기 전에 목록의 행 하나를 편집하세요.
- 다음은 움직임: 브리프가 피사체 주위에 여유를 두도록 요청하므로, 샷을 동영상 생성의 시작 프레임으로 쓸 수 있습니다.
비용
가격은 같은 설정을 기준으로 한 현재 가격입니다.
| 단계 | 모델 | 크레딧 |
|---|---|---|
| 레퍼런스 프레임 | GPT Image 2 | 21 |
| 샷 목록 | 텍스트 생성 - 모든 LLM 노드의 LLM | 2~17, 모델에 따라 다름 |
| 샷 10개 | GPT Image 2 | 210 |
써 보기
app.nodaro.ai에서 카메라 커버리지 튜토리얼을 여세요. 로그인하지 않아도 모든 노드와 이미지가 담긴 이 실행을 볼 수 있습니다. 튜토리얼 실행은 워크플로를 내 계정에 복사하며, 복사는 무료입니다. 앱에서 튜토리얼이 있는 위치는 튜토리얼과 템플릿을 참고하세요.
자주 묻는 질문
같은 AI 이미지의 다른 카메라 앵글은 어떻게 얻나요?
그 이미지를 이미지 모델의 레퍼런스로 쓰고, 프롬프트마다 카메라 설정 하나를 묘사하세요. 이 워크플로에서는 LLM이 이미지를 보고 설정 10개를 쓰고, 목록이 이미지 생성 노드 하나를 설정마다 한 번씩 실행합니다.
모든 앵글에서 캐릭터가 똑같이 유지되나요?
이번 실행에서는 그렇습니다. 여성, 재킷, 카페, 밤의 조명이 10샷 모두에서 일치합니다. 모든 샷이 원본 프레임을 레퍼런스 이미지로 사용했기 때문입니다.
모든 앵글이 계획대로 나왔나요?
10개 중 9개가 계획대로 나왔습니다. 인서트 샷은 머그잔과 책만 가까이 담은 디테일로 계획했지만, GPT Image 2가 여성을 프레임 안에 남겼습니다.
커버리지 전체의 비용은 얼마인가요?
기본 크기의 GPT Image 2에서 이미지 한 장은 21크레딧이므로, 10샷은 210크레딧입니다. 샷 목록은 LLM에 따라 2~17크레딧입니다.
이 워크플로는 어디서 써 볼 수 있나요?
app.nodaro.ai에서 카메라 커버리지 튜토리얼을 여세요. 로그인하지 않아도 실제 실행을 볼 수 있고, 튜토리얼 실행을 클릭하면 워크플로가 내 계정에 무료로 복사됩니다.
관련 문서
이미지 생성
목록
텍스트 생성 - 모든 LLM
캐릭터 일관성
피커 활용 사례
최종 업데이트