
 Docs do Nodaro
Transcrever
Transcreva a fala de um áudio ou vídeo com o ElevenLabs STT, o Whisper ou o Nemotron 3.5 Transcribe: o tempo de cada palavra, os falantes ou uma tradução.
O nó Transcrever transforma fala em texto. Conecte um áudio ou um vídeo, e o nó retorna a transcrição duas vezes: como texto simples e como uma transcrição estruturada, com o tempo de cada palavra. Você pode escolher entre quatro mecanismos, e eles diferem em um ponto que importa para as legendas: se retornam ou não os tempos de cada palavra. O Nemotron 3.5 Transcribe também pode traduzir a fala em vez de transcrevê-la.
Quando usar
- Transcrever uma entrevista ou um podcast para criar conteúdo escrito.
- Criar legendas a partir do som de um vídeo, com Adicionar legendas.
- Transformar notas de voz e gravações de reuniões em texto.
- Tornar uma biblioteca de áudios pesquisável como texto.
- Passar uma transcrição a um nó de texto para resumi-la ou analisá-la.
- Dar ao Plano de edição a transcrição com tempos de que ele precisa para planejar uma edição.
Início rápido
Adicione o nó
Pressione Tab no canvas e escolha Áudio › Transcrição › Transcrever.
Conecte a gravação
Conecte um nó de áudio ou um nó de vídeo à entrada Áudio.
Escolha o mecanismo e o idioma
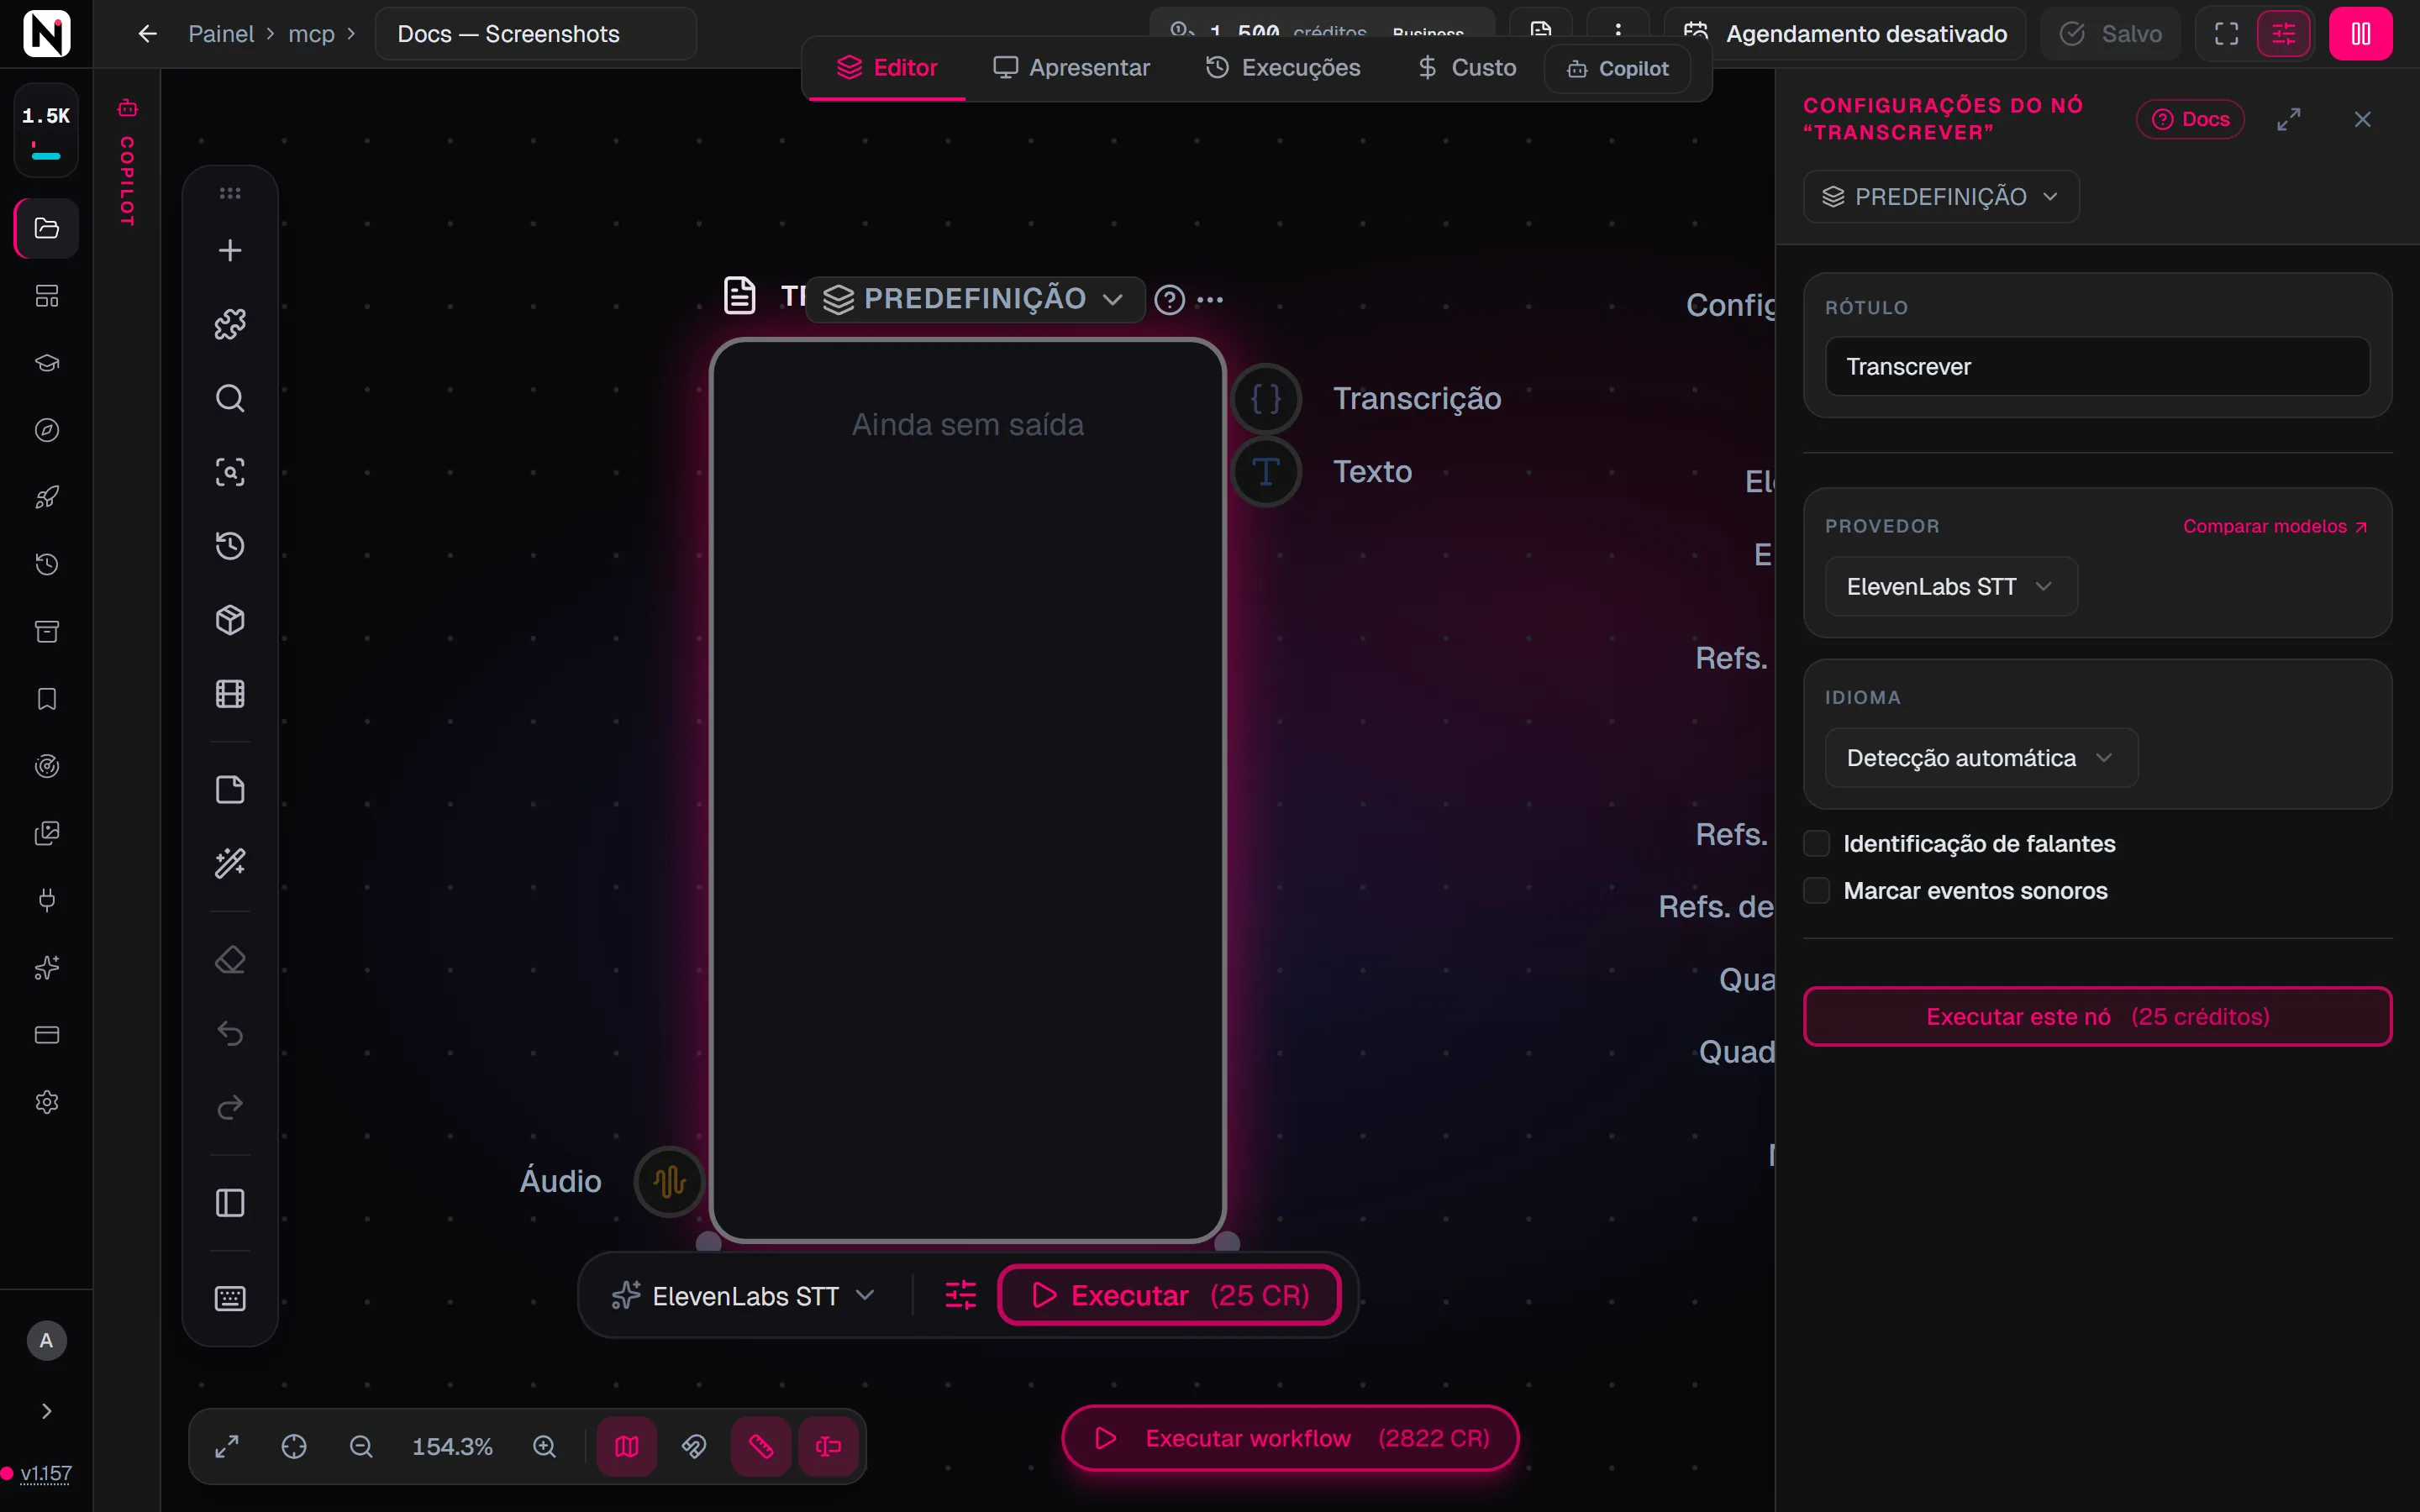
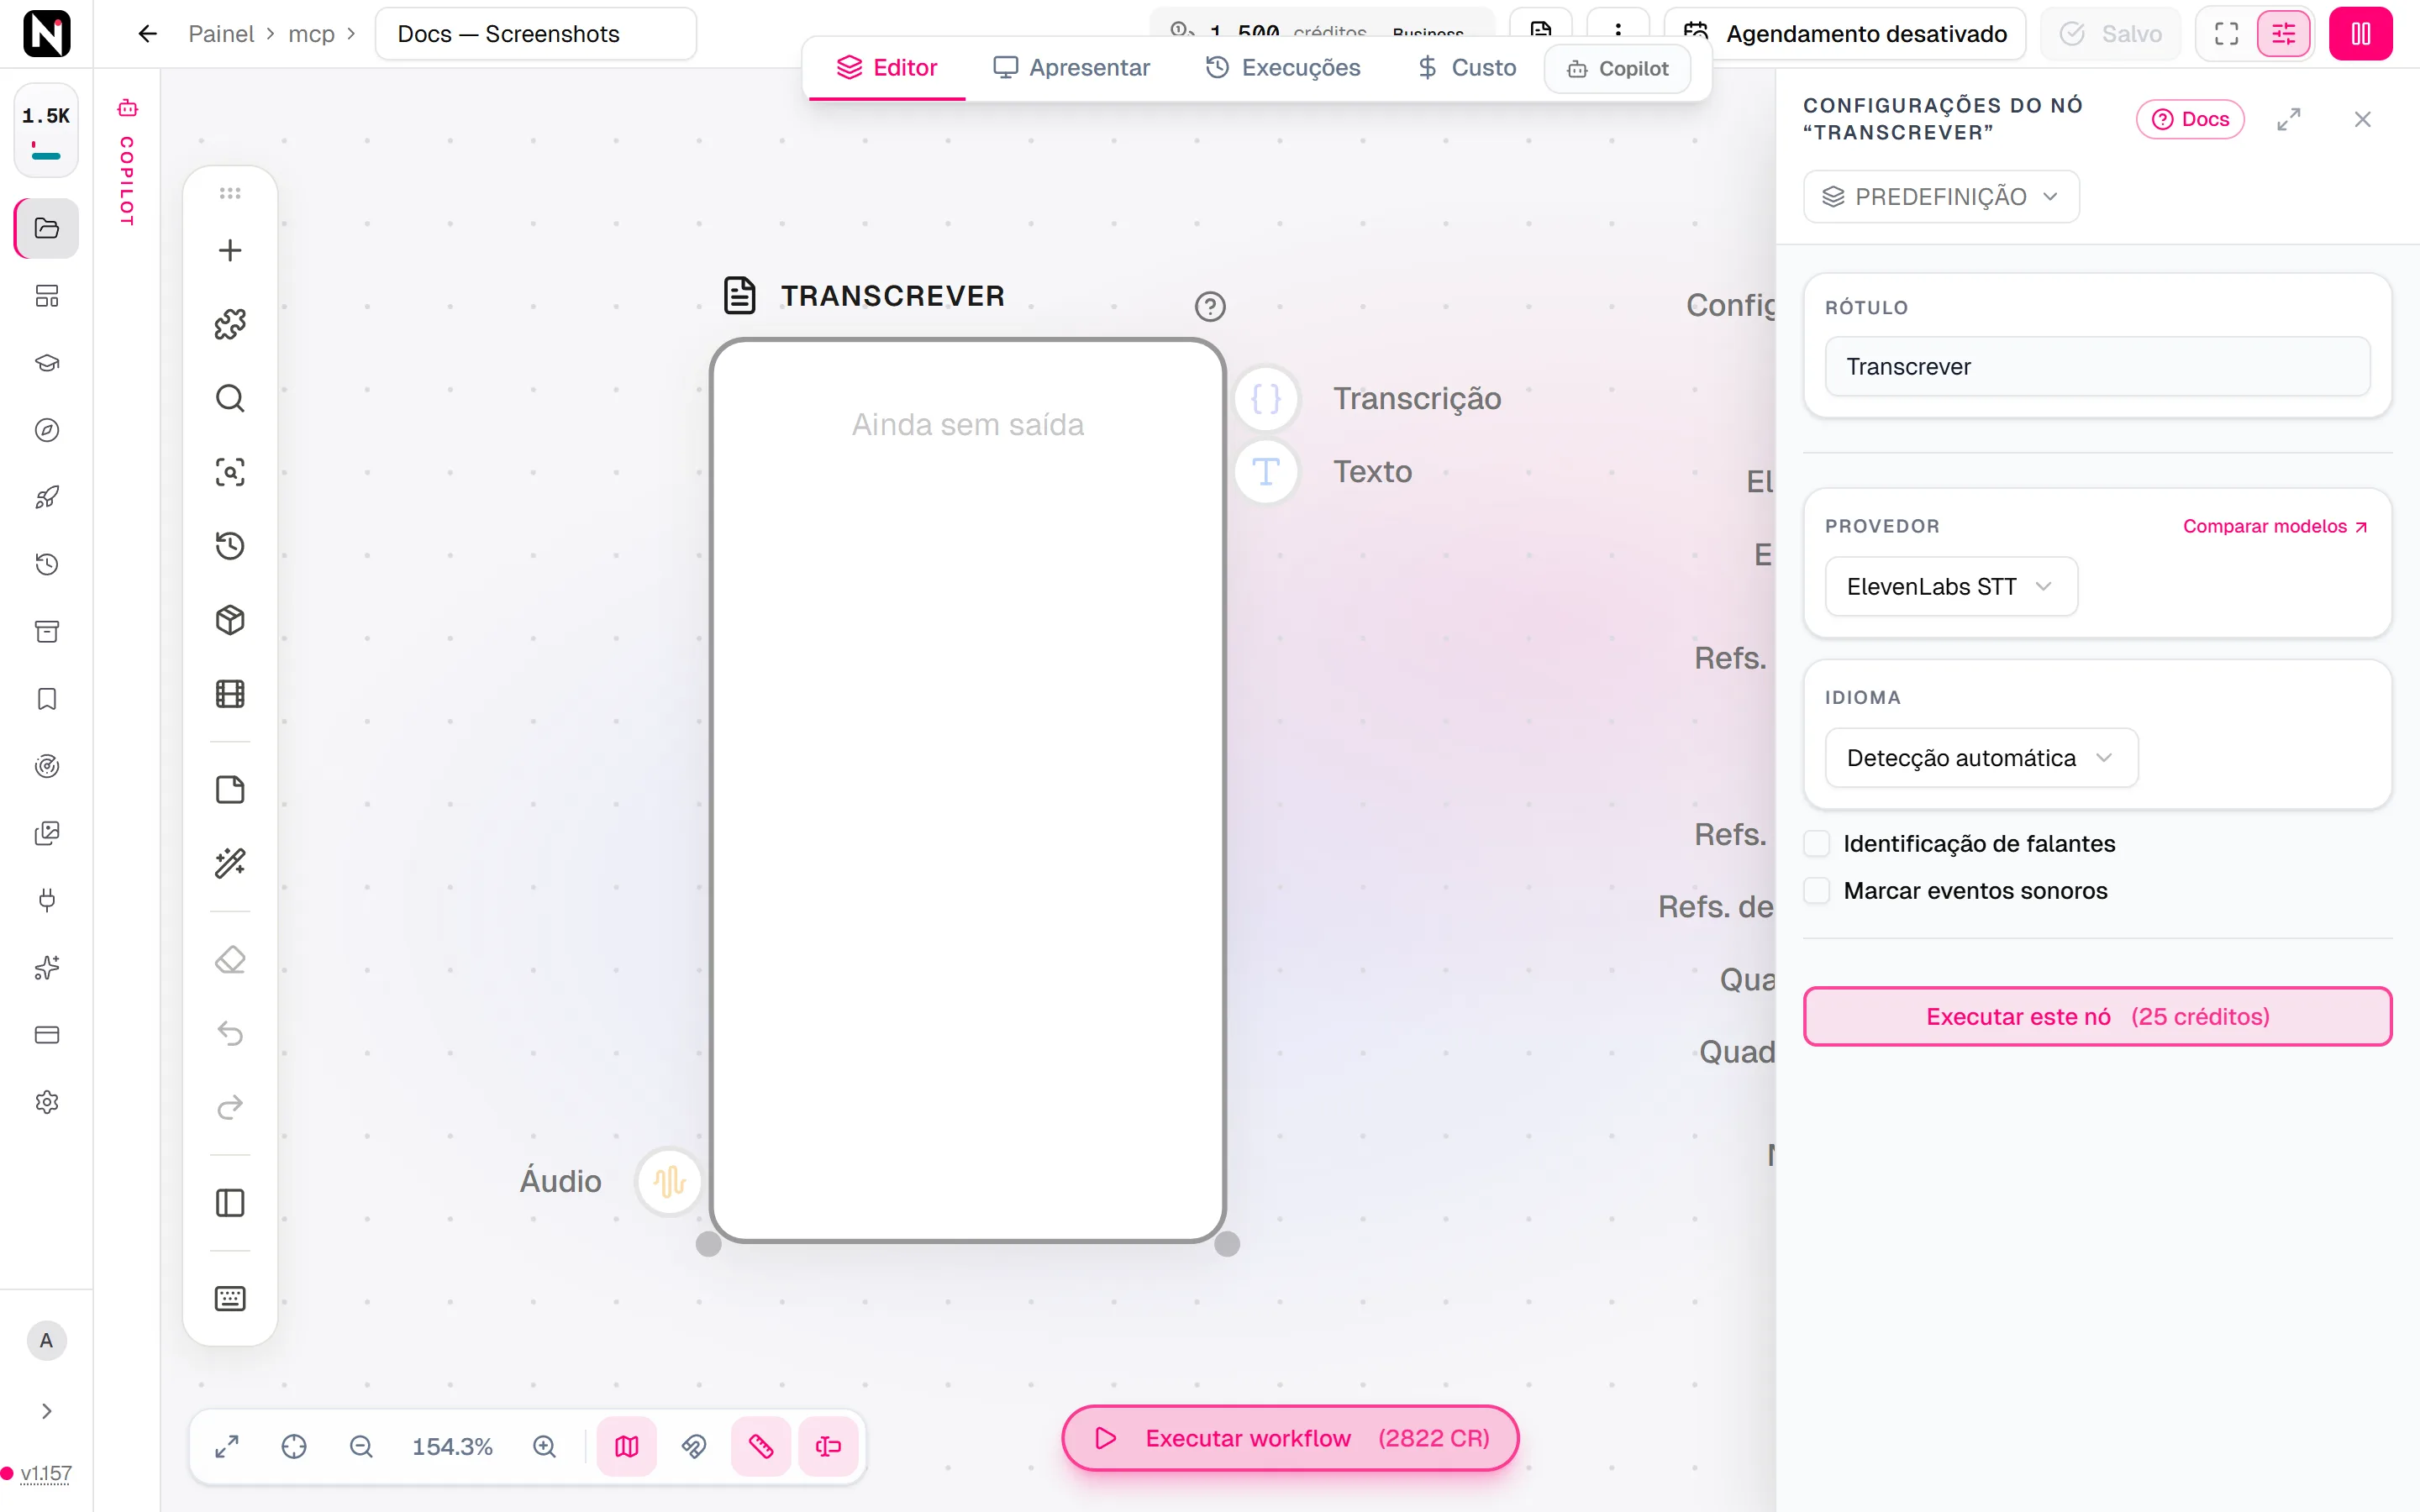
Abra o painel de configurações. Mantenha Provedor em ElevenLabs STT, a menos que você precise de outro mecanismo. Mantenha Idioma em Detecção automática ou escolha o idioma.
Execute
Clique em Executar no nó. A transcrição simples aparece na saída Texto, e a transcrição com tempos, na saída Transcrição.
Entrada e saídas
| Entrada | Aceita | O que faz |
|---|---|---|
| Áudio | Nós de áudio e de vídeo | A fala a transcrever. No caso de um vídeo, o nó usa a faixa de áudio dele. |
Para transcrever um vídeo a partir de um link para onde ele está, conecte um nó URL de vídeo. O nó URL de vídeo pede a declaração de direitos de conteúdo e busca o som, e o Transcrever transcreve essa faixa. Um link para a página de um vídeo entregue ao Transcrever de outra forma interrompe uma execução no editor, e a mensagem avisa isso.
| Saída | O que traz |
|---|---|
| Texto | A transcrição inteira como texto simples. Ela se conecta a qualquer nó que receba texto. |
| Transcrição | A transcrição estruturada, com os tempos das palavras e dos segmentos em milissegundos. Ela alimenta o Adicionar legendas e os nós de edição. |
Em um prompt, uma referência ao rótulo do nó, como {Transcribe}, fornece o texto simples.
Configurações
| Configuração | O que faz |
|---|---|
| Provedor | O mecanismo: ElevenLabs STT (o padrão), Whisper — sem tempos por palavra, Incredibly Fast Whisper ou Nemotron 3.5 Transcribe. |
| Idioma | Detecção automática (o padrão) ou um de 20 idiomas, como inglês, espanhol, hebraico, japonês e árabe. Não aparece com o Nemotron 3.5 Transcribe, que detecta sozinho o idioma falado, entre 40 idiomas. |
| Traduzir para | Só aparece quando o Provedor é Nemotron 3.5 Transcribe. Não traduzir (o padrão) retorna uma transcrição. Um idioma retorna, no lugar dela, uma tradução para esse idioma, veja Traduza a fala. Mudar o Provedor para outro mecanismo limpa essa escolha. |
| Identificação de falantes | Identifica quem disse o quê. Vem desativada por padrão. Só aparece quando o Provedor é ElevenLabs STT. |
| Marcar eventos sonoros | Marca na transcrição os sons que não são fala, como [music] ou [laughter]. Vem desativada por padrão. Só aparece quando o Provedor é ElevenLabs STT. |
Identificação de falantes e Marcar eventos sonoros são independentes: ative uma, as duas ou nenhuma.
Modelos
| Modelo | Desenvolvedor | Modos | Créditos | Detalhes |
|---|---|---|---|---|
| ElevenLabs STT | ElevenLabs | Fala para texto | 25 | Fala para texto com marcações de tempo POR PALAVRA (sempre ativas), identificação de falantes e etiquetas de eventos sonoros. É o mecanismo certo quando a transcrição alimenta legendas. |
| Incredibly Fast Whisper | OpenAI | Fala para texto | 44 | Fala para texto rápido com o Whisper. Retorna marcações de tempo POR PALAVRA quando solicitado, então a transcrição pode alimentar legendas. |
| Whisper | OpenAI | Fala para texto | 44 | Fala para texto com o Whisper — só segmentos POR FRASE, SEM marcações de tempo por palavra. Serve para uma transcrição ou uma legenda estática, mas não para legendas sincronizadas palavra por palavra (cinéticas). |
| Nemotron 3.5 Transcribe | NVIDIA | Fala para texto | 4 | Fala para texto da NVIDIA em 40 idiomas, detectados automaticamente, com uma baixa taxa de erro por palavra. Quando solicitado, retorna marcações de tempo POR PALAVRA com um rótulo de falante em cada palavra, então a transcrição pode alimentar legendas; ou então traduz a fala (para o inglês ou a partir dele: outra fala para o inglês, ou uma fala em inglês para um de 31 idiomas), sem marcações de tempo por palavra. Arquivos de até 60 minutos e 200 MB. Preço por minuto iniciado do arquivo, quaisquer que sejam as opções; o preço listado é de quatro minutos. |
Tempos de cada palavra: qual mecanismo os retorna
| Mecanismo | Tempos de cada palavra | Observações |
|---|---|---|
| ElevenLabs STT (padrão) | Sempre | Projetado para trabalhar palavra por palavra. O mecanismo para legendas, rótulos de falante e eventos sonoros. |
| Incredibly Fast Whisper | Quando necessário | O nó pede os tempos de cada palavra automaticamente quando a saída Transcrição está conectada. |
| Whisper | Nunca | Só segmentos de frases. Serve para uma transcrição simples ou uma legenda estática. |
| Nemotron 3.5 Transcribe | Quando necessário | O nó pede os tempos de cada palavra automaticamente quando a saída Transcrição está conectada. Cada palavra traz então o falante dela. Uma tradução nunca tem tempos de cada palavra. |
Se o ElevenLabs STT, o Incredibly Fast Whisper ou o Nemotron 3.5 Transcribe não retornar os tempos de cada palavra para um áudio que claramente tem fala, a execução falha e os créditos são reembolsados. Um áudio sem nenhuma fala ainda é concluído com sucesso, sem palavras, por exemplo um clipe cuja transcrição é [music].
Traduza a fala
Com Traduzir para definido, o Nemotron 3.5 Transcribe traduz a fala em vez de transcrevê-la. A tradução é sempre para o inglês ou a partir dele:
- Para o inglês. A fala em outro idioma vira texto em inglês.
- A partir do inglês. A fala em inglês vira texto em chinês, japonês, coreano, francês, alemão, espanhol, português, italiano, russo, holandês, polonês, tcheco, eslovaco, hindi, búlgaro, croata, dinamarquês, estoniano, finlandês, húngaro, letão, lituano, romeno, esloveno, sueco, tailandês, ucraniano, árabe, grego, hebraico ou maltês.
Uma tradução entre dois outros idiomas pode funcionar, mas não é garantida. Para o melhor resultado, traduza para o inglês.
- A saída Texto traz a tradução, e o
languageda transcrição é o idioma de destino. - Uma tradução não tem tempos de cada palavra, então a lista
wordsda saída Transcrição fica vazia. Um nó que traduz e alimenta o Adicionar legendas é recusado antes da execução. - Só o Nemotron 3.5 Transcribe traduz. Uma tradução custa o mesmo que uma transcrição.
O arquivo que o Nemotron 3.5 Transcribe aceita
O Nemotron 3.5 Transcribe aceita um arquivo de até 60 minutos e 200 MB. O arquivo é um áudio MP3, WAV, M4A ou AAC, FLAC, OGG ou Opus, ou WEBM, ou um vídeo MP4 ou MOV com faixa de áudio. Ele precisa ser um link HTTPS direto para um arquivo em um host público.
- Medido antes. O nó mede o arquivo antes de reservar qualquer crédito, porque o preço depende da duração.
- Recusados sem nenhuma cobrança: um link que não seja HTTPS (
invalid_media_url), um arquivo com mais de 60 minutos ou 200 MB e um link para a página de um vídeo em uma plataforma social. Um link cujo host não existe, ou que aponta para um endereço privado ou reservado, também é recusado, commedia_link_bad_host. Veja Links de mídia. Para esse vídeo, traga primeiro o áudio dele por um nó URL de vídeo, ou escolha outro mecanismo. - Os 60 minutos são exatos. O modelo lê o arquivo pelo link dele, então nada pode cortá-lo. Um corte feito para ter 60 minutos que sai uma fração de segundo mais longo também é recusado, com
media_duration_exceeds_limit. Corte-o um pouco mais curto. - Um host que não pode ser consultado naquele momento é um
503 source_unreachable. Execute o nó de novo. - Uma duração que não pode ser lida antes não é recusada. Uma gravação do navegador salva como fluxo ou um MP4 fragmentado reserva o preço de 60 minutos, e a execução é cobrada pela duração que o modelo decodificou.
- Falantes. Com os tempos de cada palavra, vozes muito diferentes se separam bem. Vozes parecidas podem ser juntadas em um só falante.
- Texto repetido. Quando a resposta atinge o limite de tamanho do modelo para o áudio, a saída da tarefa traz
truncated: true. Isso costuma significar que o modelo se repete, então revise ou descarte o resultado.
A transcrição estruturada
A saída Transcrição tem esta forma:
{
  "version": 1,
  "language": "en",
  "words": [
    { "text": "Welcome", "startMs": 0, "endMs": 420 },
    { "text": "back", "startMs": 460, "endMs": 700 }
  ],
  "segments": [
    { "startMs": 0, "endMs": 700, "text": "Welcome back" }
  ]
}- Todos os tempos estão em milissegundos inteiros.
wordstraz cada palavra com o início e o fim dela. Ele é preenchido sempre que o mecanismo retorna os tempos de cada palavra.segmentstraz as frases ou os trechos maiores, quando o mecanismo os fornece.- Em uma execução com Identificação de falantes, cada palavra e cada segmento também têm um
speaker. Uma palavra também pode trazer umconfidence.
Na saída Texto, a Identificação de falantes adiciona rótulos como Speaker 1: antes de cada segmento, e Marcar eventos sonoros adiciona tags como [music] e [laughter] no lugar em que os sons ocorrem.
Crie legendas a partir de uma transcrição
Conecte a saída Transcrição à entrada de transcrição do Adicionar legendas. O Adicionar legendas então desenha legendas sincronizadas com cada palavra. Para isso, use o ElevenLabs STT, o Incredibly Fast Whisper ou o Nemotron 3.5 Transcribe.
Uma transcrição do Whisper não serve para legendas. Quando um nó Transcrever com o Whisper alimenta o Adicionar legendas, a execução é recusada antes que qualquer coisa seja executada ou cobrada, com esta mensagem:
Captions need word timings, but the "whisper" engine does not return word timings — pick incredibly-fast-whisper or elevenlabs-stt.- Um nó Nemotron 3.5 Transcribe configurado para traduzir é recusado da mesma forma, porque uma tradução não tem tempos de cada palavra. Defina Traduzir para como Não traduzir para executá-lo.
- A verificação também cobre uma cadeia que passa pelo Aplicar EDL e cadeias dentro de um sub-workflow, em qualquer profundidade.
- O painel de configurações mostra o mesmo aviso ao lado de Provedor assim que a conexão existe, para que você corrija antes de executar.
- Executar o nó Transcrever sozinho nunca é bloqueado. Uma transcrição do Whisper que vai para qualquer outro lugar não tem problema.
- Um caso não pode ser verificado com antecedência: uma cadeia em que o Transcrever e o Adicionar legendas ficam em lados diferentes do limite de um sub-workflow. Essa execução falha no Adicionar legendas, depois que a transcrição já foi executada e cobrada.
Créditos
Três mecanismos custam um preço fixo por execução, qualquer que seja a duração do áudio:
| Mecanismo | Créditos por execução |
|---|---|
| ElevenLabs STT | 25 |
| Incredibly Fast Whisper | 44 |
| Whisper | 44 |
O Nemotron 3.5 Transcribe tem o preço definido pela duração do arquivo. Ele cobra por minuto do áudio, ou parte dele, até 60 minutos, e o preço é o mesmo com os tempos de cada palavra ou com uma tradução. Os minutos são somados, e a execução é arredondada para cima, para um crédito inteiro, uma só vez.
- Até um segundo além de um minuto conta como o minuto de baixo. Um arquivo até 1 segundo além de um minuto inteiro é reservado e cobrado como esse minuto. Assim, um arquivo de 1:00,8 é cobrado como um minuto. Um corte ou uma junção recodificada costuma medir alguns centésimos de segundo além da própria duração. Depois desse segundo, começa o minuto seguinte.
- Antes de uma execução, o preço do nó, o botão Executar, a estimativa do workflow e o preço listado de um app mostram os minutos iniciados da duração que o workflow conhece. Essa é a duração registrada de um upload ou a duração que outro nó da execução vai produzir com as configurações dele (a janela de um corte, a duração de uma geração). Também pode ser a duração registrada com o resultado de um nó que não roda. Uma duração conhecida um pouco além de um minuto aparece no minuto seguinte, e a execução cobra o menor. Quando ainda não se conhece nenhuma duração, ele mostra o preço de 60 minutos.
- Uma voz gerada de novo na execução, como a do Texto para fala, é estimada pela duração da tentativa que ela guarda agora. Isso é um mínimo: a voz nova pode ser mais longa, e a execução é cobrada pelos minutos que ela mede.
- A reserva. O arquivo é medido antes da execução, e o preço dessa duração é reservado. Um arquivo cuja duração não pode ser lida reserva o preço de 60 minutos.
- A cobrança. Depois da execução, ela é cobrada pela duração que o modelo realmente decodificou. Essa duração pode diferir da que está no cabeçalho do arquivo, porque alguns arquivos MP3 informam uma duração errada. Uma duração menor libera o resto da reserva, e uma maior tira a diferença do seu saldo.
Uma requisição recusada antes de começar, como uma transcrição do Whisper conectada ao Adicionar legendas, não é cobrada.
Em uma instalação auto-hospedada
Cada mecanismo usa a sua própria chave de provedor. Quando o mecanismo escolhido não tem chave e a instalação tem uma conexão com o Nodaro Cloud, a transcrição passa por essa conexão. Sem nenhuma das duas, o nó falha com uma mensagem que indica a chave a adicionar. Veja Chaves de provedor.
Dicas
- Deixe o idioma em Detecção automática. Escolha um idioma só quando você souber qual é, por exemplo quando dois idiomas soam parecidos.
- Identifique os falantes em conversas. Ative Identificação de falantes em entrevistas, reuniões e podcasts.
- Marque os eventos quando eles importarem. Ative Marcar eventos sonoros quando os sons de fundo ajudarem a entender a gravação.
- Limpe antes o áudio com ruído. Passe a gravação pelo Extrator de voz antes do Transcrever.
- Divida áudios muito longos. Segmentos mais curtos são transcritos com mais confiabilidade. O Dividir em partes corta um arquivo longo em partes entre uma duração mínima e uma máxima, e o Transcrever é executado uma vez para cada parte.
- Ou alinhe o seu próprio roteiro. Quando você já tem o roteiro exato, o Alinhamento forçado marca no áudio o tempo de cada palavra dele.
Pela API
POST /v1/transcribe recebe audioUrl e, opcionalmente, provider (elevenlabs-stt, incredibly-fast-whisper, whisper ou nemotron-3-5-transcribe), language, diarize, tagAudioEvents, wordTimestamps e targetLanguage.
- Um link para a página de um vídeo. Um
audioUrlque aponta para a página de um vídeo em uma plataforma social é uma importação desse link: o som dele é buscado primeiro. Envie oconfirmationIddePOST /v1/content-rights/confirmpara esse link. Sem ele, uma implantação que exige uma confirmação recusa a requisição com403antes de a tarefa ser criada. Uma chave ou um agente cuja conta tem uma autorização permanente não precisa de nenhum, e um link direto de arquivo também não. Veja Direitos de conteúdo. - Indique o mecanismo. Uma requisição sem
providerexecuta o Whisper, para que as integrações existentes mantenham o mecanismo que já usavam. Definaprovidersempre que precisar dos tempos de cada palavra, dediarizeou detagAudioEvents. - Tempos de cada palavra.
incredibly-fast-whisperenemotron-3-5-transcribesó retornam as palavras comwordTimestamps: true.wordTimestamps: truecomwhisperé recusado com um400 validation_errorantes de a tarefa ser criada, então nada é cobrado. O mecanismo nunca é trocado sem aviso. - Tradução.
targetLanguagesó funciona comnemotron-3-5-transcribe. Com outro mecanismo, com um idioma para o qual ele não traduz, ou junto comwordTimestamps: true, ele é recusado com um400 validation_erroremtargetLanguage, e nada é cobrado. - Legendas. O
output_data.wordsda tarefa concluída já tem o formato das legendas (text,startMs,endMs). Passe-o paraPOST /v1/add-captionscomocaptions, e o Adicionar legendas não transcreve de novo. - Preço.
GET /v1/credits/model-cost?model=<engine>retorna o preço exato para a sua conta. Para o Nemotron 3.5 Transcribe, peçanemotron-3-5-transcribe:<minutes>m.
O método do SDK é client.audio.transcribe, e o comando da CLI é nodaro audio transcribe --provider <engine>, com --target-language para uma tradução. A ferramenta MCP transcribe recebe o mecanismo em model e uma tradução em target_language. Sem model, ela executa o ElevenLabs STT, então o resultado dela tem os tempos de cada palavra. Veja Voz e mídia.
Perguntas frequentes
Qual mecanismo de transcrição devo escolher?
Mantenha o ElevenLabs STT, o padrão. Ele sempre retorna os tempos de cada palavra, pode identificar os falantes e marcar eventos sonoros, e é o mais barato. O Incredibly Fast Whisper e o Nemotron 3.5 Transcribe também retornam os tempos de cada palavra quando um nó precisa deles. O Nemotron 3.5 Transcribe tem o preço definido pela duração do arquivo e pode traduzir a fala. O Whisper retorna só frases.
Por que o meu workflow com “Transcrever” e “Adicionar legendas” foi recusado?
O nó “Transcrever” usa o Whisper, que não retorna os tempos de cada palavra, e as legendas precisam deles. Mude “Provedor” para ElevenLabs STT, Incredibly Fast Whisper ou Nemotron 3.5 Transcribe e execute de novo. Um nó configurado para traduzir também é recusado, porque uma tradução não tem tempos de cada palavra. Nada é cobrado.
Quantos créditos o nó “Transcrever” custa?
O ElevenLabs STT custa 25 créditos por execução, o Incredibly Fast Whisper custa 44 e o Whisper custa 44, qualquer que seja a duração do áudio. O Nemotron 3.5 Transcribe é cobrado por minuto do arquivo, ou parte dele, até 60 minutos.
O nó “Transcrever” consegue distinguir os falantes?
Sim, com o ElevenLabs STT. Ative “Identificação de falantes”, e o texto indica o falante de cada segmento, como “Speaker 1:”. Cada palavra da transcrição estruturada também traz o falante dela. O Nemotron 3.5 Transcribe também dá um falante a cada palavra quando retorna os tempos de cada palavra.
O nó “Transcrever” consegue traduzir a fala?
Sim, com o Nemotron 3.5 Transcribe. Defina “Traduzir para”, e o nó retorna uma tradução no lugar da transcrição. Ele traduz outras falas para o inglês, ou a fala em inglês para um de 31 idiomas. Uma tradução não tem tempos de cada palavra.
Posso transcrever um vídeo?
Sim. Conecte o vídeo à entrada “Áudio”, e o nó transcreve a faixa de áudio dele.
Páginas relacionadas
Adicionar legendas
Alinhamento forçado
Plano de edição
Extrator de voz
ElevenLabs STT
Última atualização
Tom e andamento
Suba ou desça o tom de uma voz ou de uma música em semitons, ou acelere e desacelere o áudio sem mudar o tom. Funciona com áudio e com o som de um vídeo.
Alinhamento forçado
Marque no áudio o tempo de cada palavra de uma transcrição conhecida e receba o início e o fim de cada uma como dados, para karaokê, gráficos e legendas.