
 Nodaro 문서
음성 텍스트 변환
ElevenLabs STT나 Whisper로 오디오와 동영상 속 음성을 텍스트로 바꾸세요. 자막용 단어 타이밍, 화자 레이블, 음악과 웃음소리 태그도 받을 수 있습니다.
음성 텍스트 변환 노드는 음성을 텍스트로 바꿉니다. 오디오나 동영상을 연결하면 노드가 녹취록을 두 가지 형태로 반환합니다. 일반 텍스트와, 모든 단어의 타이밍이 담긴 구조화된 녹취록입니다. 세 가지 엔진 중에서 고를 수 있으며, 엔진마다 자막에 중요한 한 가지가 다릅니다. 바로 단어 타이밍을 반환하는지 여부입니다.
사용 시기
- 인터뷰나 팟캐스트를 텍스트로 옮겨 글 콘텐츠로 만듭니다.
- 자막 추가로 동영상의 소리에서 자막을 만듭니다.
- 음성 메모와 회의 녹음을 텍스트로 바꿉니다.
- 오디오 라이브러리를 텍스트로 검색할 수 있게 만듭니다.
- 녹취록을 텍스트 노드에 넘겨 요약하거나 분석합니다.
- 편집 계획이 편집을 계획하는 데 필요한, 타이밍이 담긴 녹취록을 제공합니다.
빠른 시작
노드 추가
캔버스에서 Tab 키를 누르고 오디오 › 음성 텍스트 변환 › 음성 텍스트 변환을 선택하세요.
녹음 연결
오디오 노드나 동영상 노드를 오디오 입력에 연결하세요.
엔진과 언어 선택
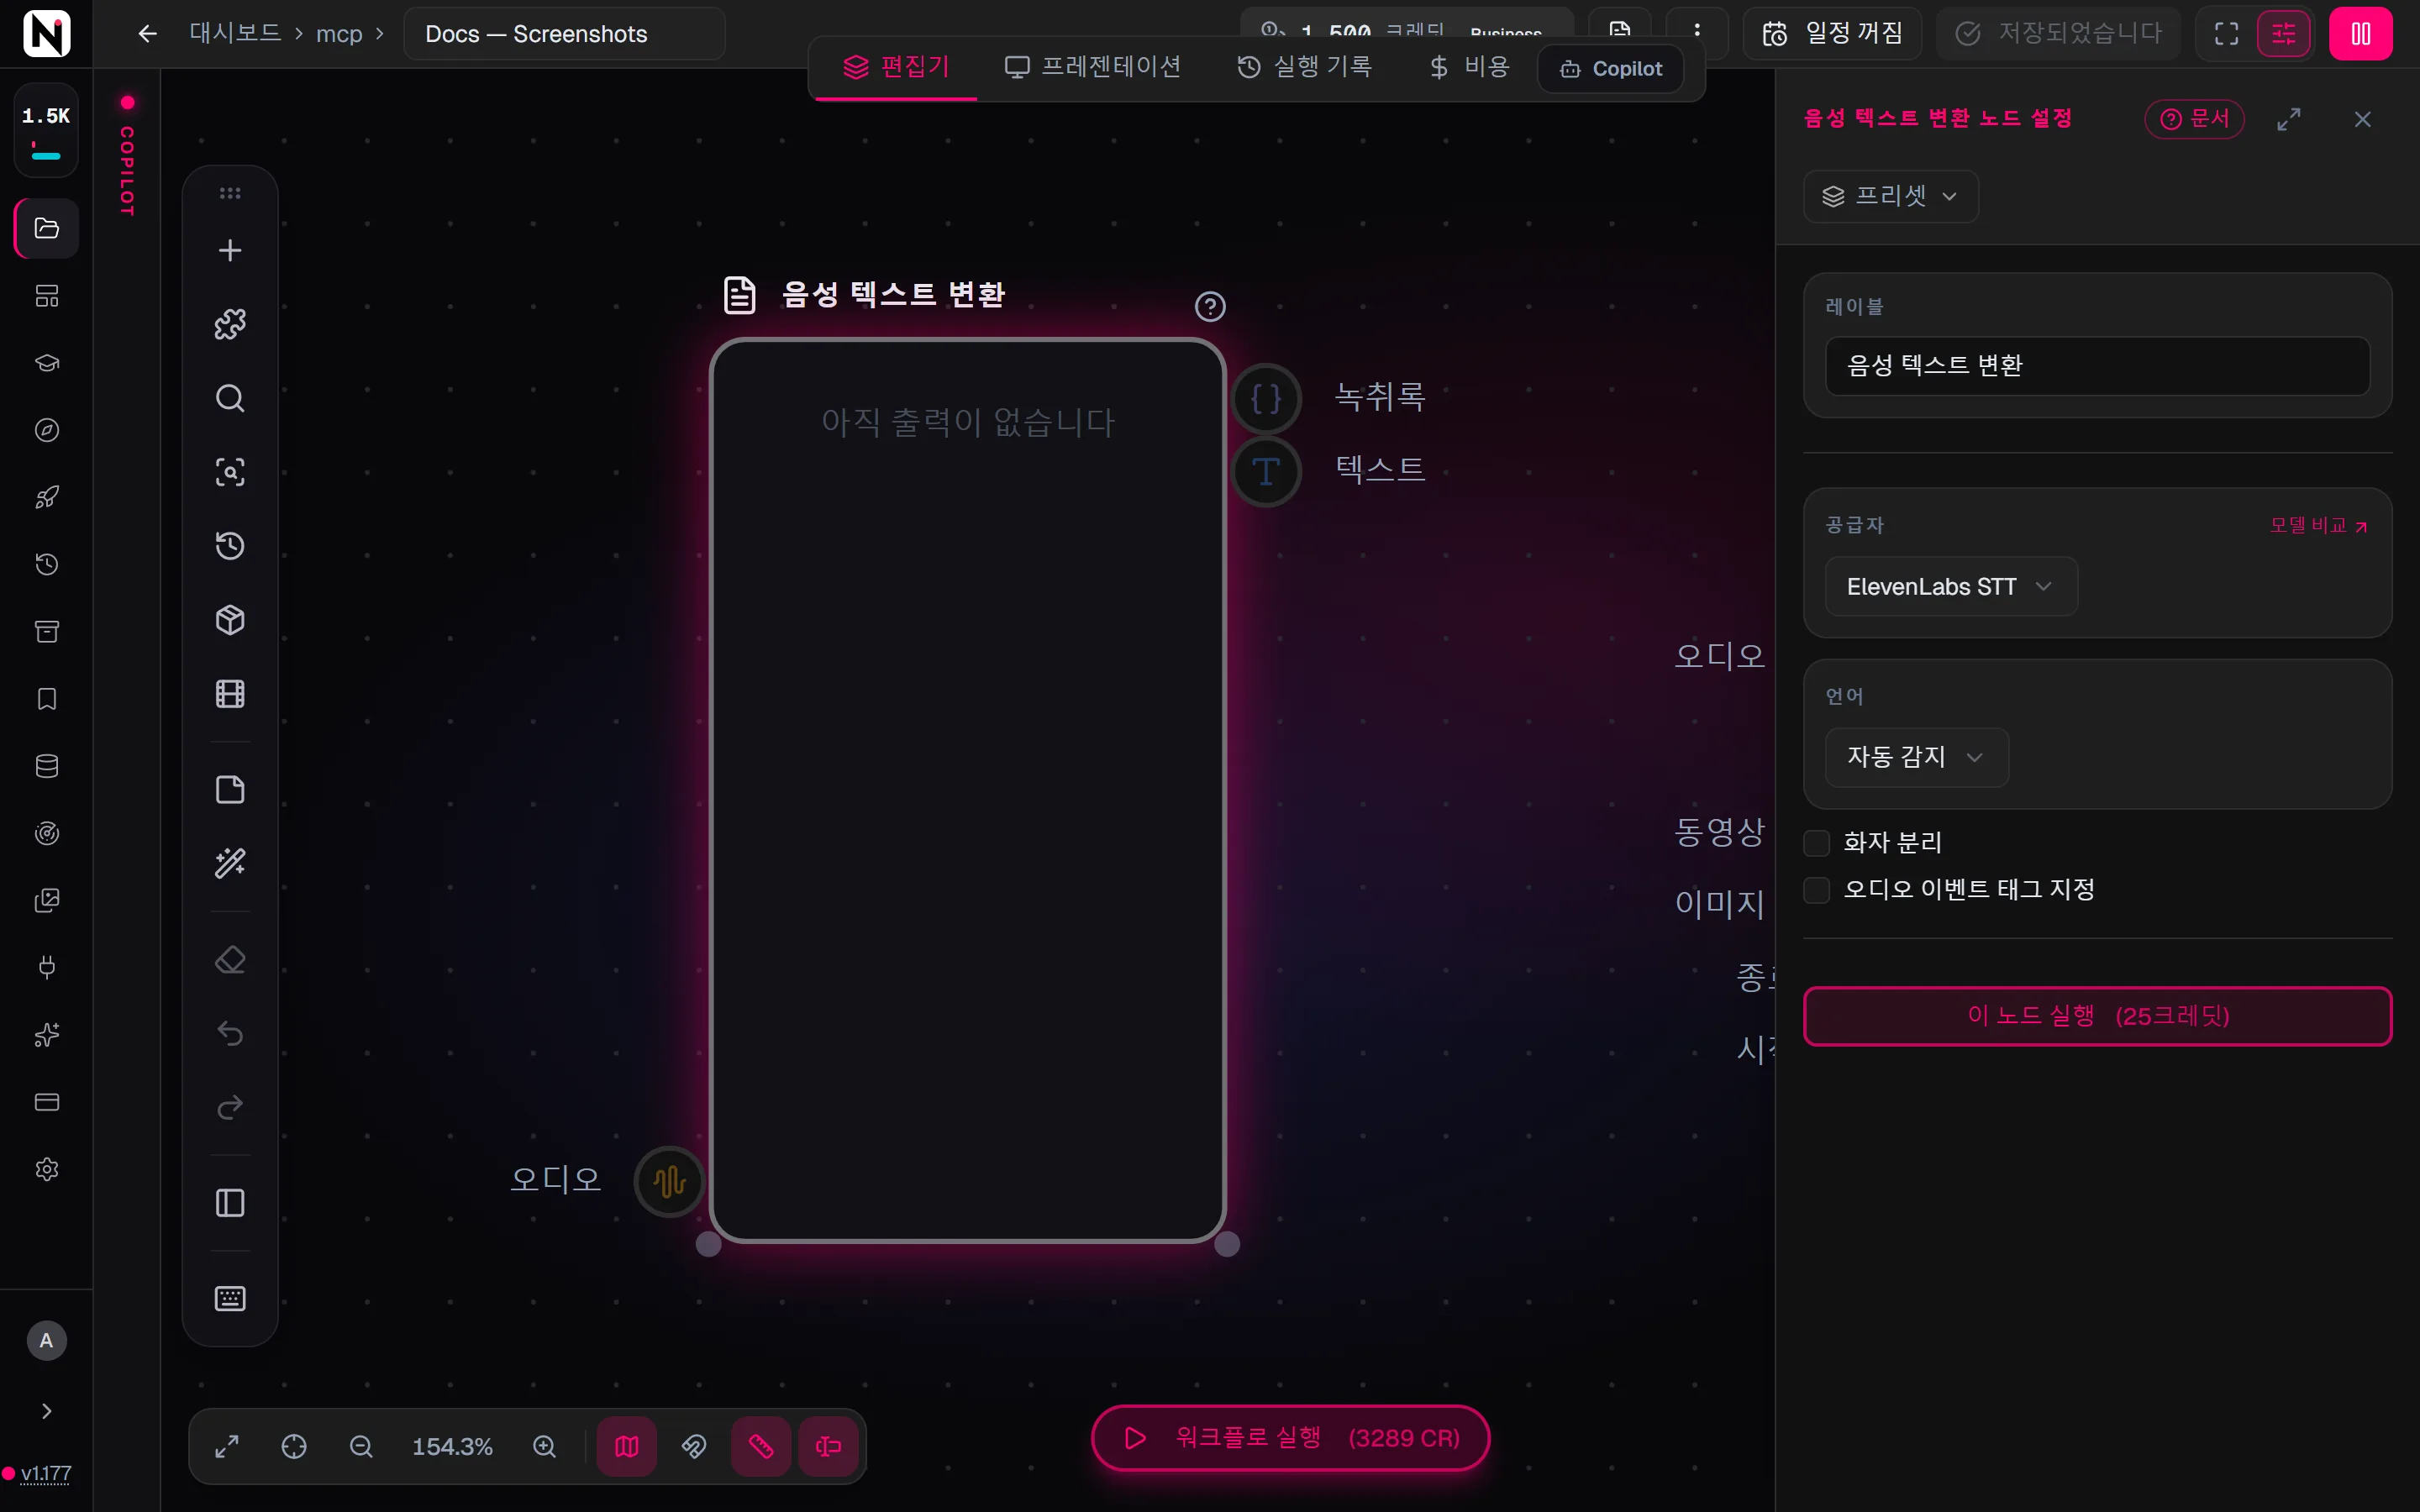
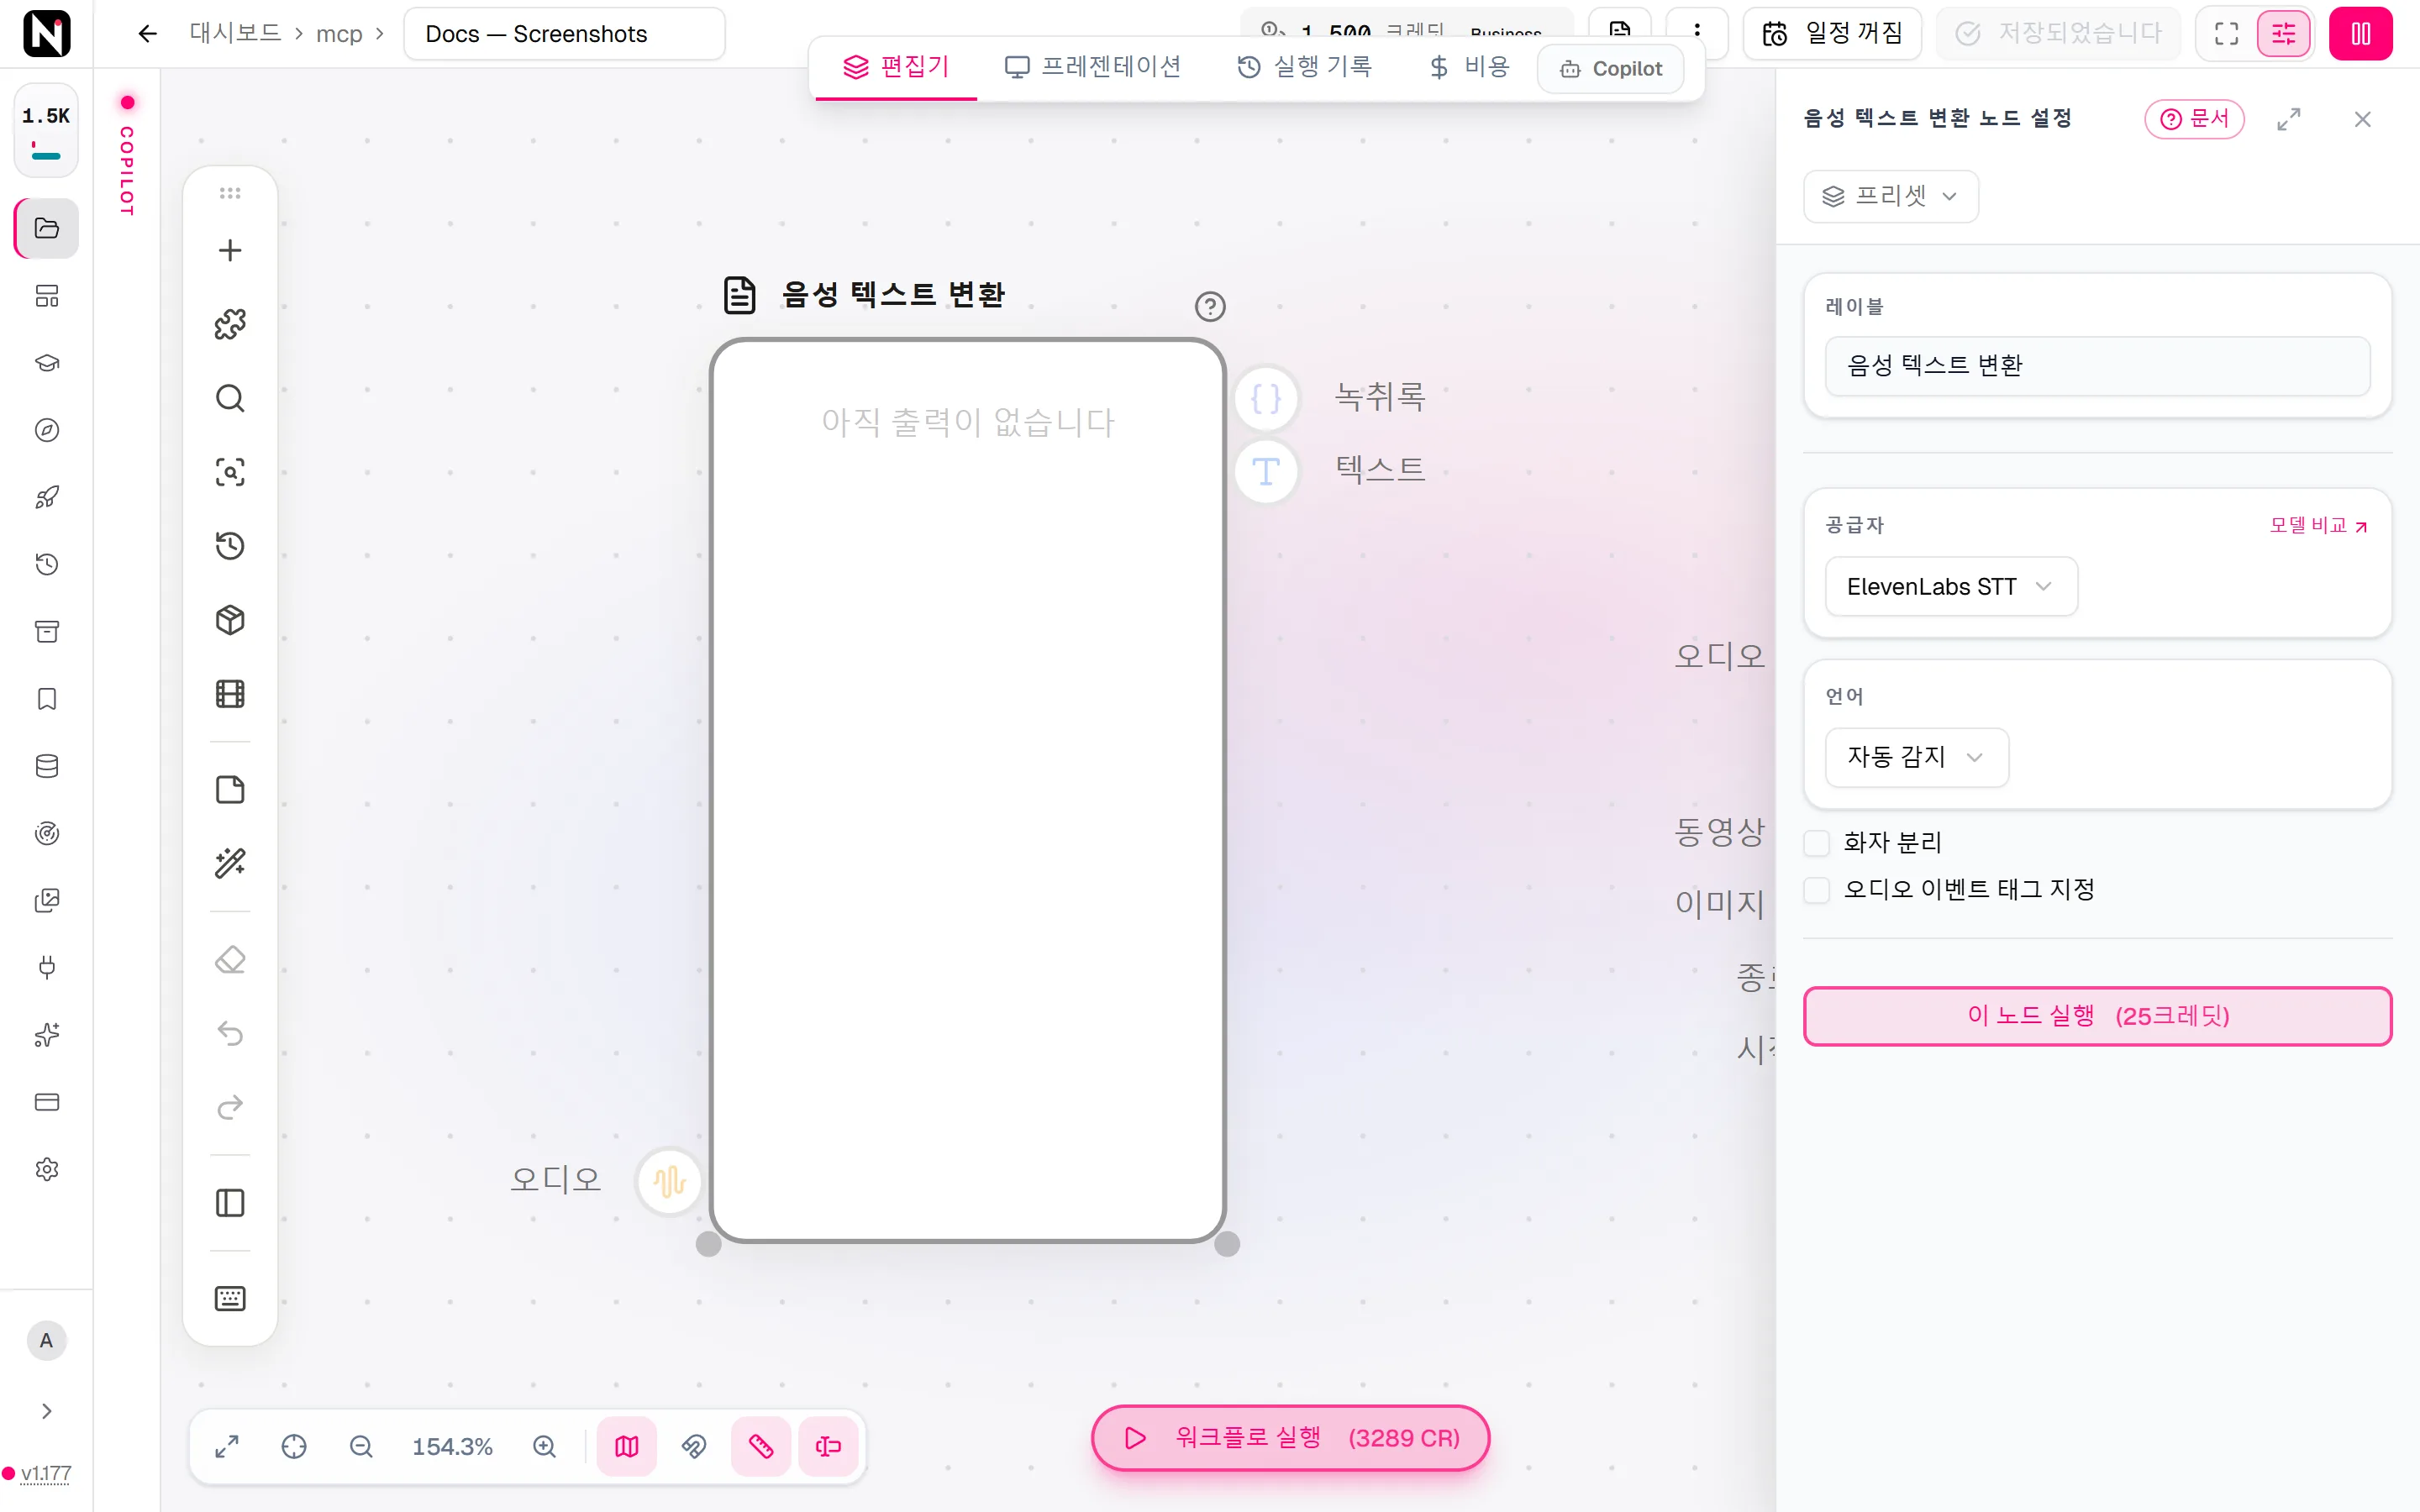
설정 패널을 여세요. 다른 엔진이 필요하지 않다면 공급자는 ElevenLabs STT로 두세요. 언어는 자동 감지로 두거나 언어를 선택하세요.
실행
노드에서 실행을 클릭하세요. 일반 녹취록은 텍스트 출력에, 타이밍이 담긴 녹취록은 녹취록 출력에 나타납니다.
입력과 출력
| 입력 | 받는 노드 | 기능 |
|---|---|---|
| 오디오 | 오디오 노드와 동영상 노드 | 텍스트로 변환할 음성입니다. 동영상이면 노드가 그 오디오 트랙을 사용합니다. |
| 출력 | 전달하는 내용 |
|---|---|
| 텍스트 | 녹취록 전체를 일반 텍스트로 담습니다. 텍스트를 받는 모든 노드에 연결할 수 있습니다. |
| 녹취록 | 단어와 구간의 타이밍이 밀리초 단위로 담긴 구조화된 녹취록입니다. 자막 추가와 편집 노드에 전달됩니다. |
프롬프트에서 {Transcribe}처럼 노드 레이블을 참조하면 일반 텍스트가 들어갑니다.
설정
| 설정 | 기능 |
|---|---|
| 공급자 | 엔진입니다. ElevenLabs STT(기본값), Whisper — 단어 타이밍 없음, Incredibly Fast Whisper 중 하나입니다. |
| 언어 | 자동 감지(기본값) 또는 영어, 스페인어, 히브리어, 일본어, 아랍어 등 20개 언어 중 하나입니다. |
| 화자 분리 | 누가 무엇을 말했는지 레이블을 붙입니다. 기본값은 꺼짐입니다. 공급자가 ElevenLabs STT일 때만 표시됩니다. |
| 오디오 이벤트 태그 지정 | [music], [laughter]처럼 말이 아닌 소리를 녹취록에 표시합니다. 기본값은 꺼짐입니다. 공급자가 ElevenLabs STT일 때만 표시됩니다. |
화자 분리와 오디오 이벤트 태그 지정은 서로 독립적입니다. 하나만 켜거나, 둘 다 켜거나, 둘 다 끌 수 있습니다.
모델
| 모델 | 개발사 | 모드 | 크레딧 | 세부 정보 |
|---|---|---|---|---|
| ElevenLabs STT | ElevenLabs | 음성 텍스트 변환 | 25 | 단어 단위 타임스탬프(항상 켜짐), 화자 분리, 오디오 이벤트 태그를 포함해 음성을 텍스트로 변환합니다. 녹취록을 자막에 쓸 때 사용할 엔진입니다. |
| Incredibly Fast Whisper | OpenAI | 음성 텍스트 변환 | 44 | 빠른 Whisper 음성 텍스트 변환입니다. 요청하면 단어 단위 타임스탬프를 반환하므로 녹취록을 자막에 쓸 수 있습니다. |
| Whisper | OpenAI | 음성 텍스트 변환 | 44 | Whisper 음성 텍스트 변환입니다. 구문 단위 세그먼트만 반환하며 단어 타임스탬프는 없습니다. 녹취록이나 고정 자막에는 충분하지만, 단어마다 타이밍을 맞추는(키네틱) 자막에는 맞지 않습니다. |
단어 타이밍: 반환하는 엔진
| 엔진 | 단어 타이밍 | 참고 |
|---|---|---|
| ElevenLabs STT(기본값) | 항상 | 설계상 단어 단위입니다. 자막, 화자 레이블, 오디오 이벤트에 쓰는 엔진입니다. |
| Incredibly Fast Whisper | 필요할 때 | 녹취록 출력이 연결되어 있으면 노드가 자동으로 단어 타이밍을 요청합니다. |
| Whisper | 반환하지 않음 | 구문 단위 구간만 반환합니다. 일반 녹취록이나 고정 자막에는 충분합니다. |
음성이 분명히 들어 있는 오디오인데 ElevenLabs STT나 Incredibly Fast Whisper가 단어 타이밍을 반환하지 않으면, 실행이 실패하고 크레딧이 환불됩니다. 음성이 전혀 없는 오디오는 단어 없이 성공합니다. 예를 들어 [music]으로만 변환되는 클립이 그렇습니다.
구조화된 녹취록
녹취록 출력은 다음과 같은 형태입니다.
{
  "version": 1,
  "language": "en",
  "words": [
    { "text": "Welcome", "startMs": 0, "endMs": 420 },
    { "text": "back", "startMs": 460, "endMs": 700 }
  ],
  "segments": [
    { "startMs": 0, "endMs": 700, "text": "Welcome back" }
  ]
}- 모든 시간은 밀리초 단위의 정수입니다.
words에는 모든 단어가 시작과 끝 시간과 함께 들어갑니다. 엔진이 단어 타이밍을 반환하면 항상 채워집니다.segments에는 더 큰 단위의 문장이나 구문이 들어갑니다. 엔진이 제공할 때만 채워집니다.- 화자 분리를 켠 실행에서는 각 단어와 구간에
speaker도 붙습니다. 단어에는confidence가 붙을 수도 있습니다.
텍스트 출력에서는 화자 분리가 각 구간 앞에 Speaker 1: 같은 레이블을 붙이고, 오디오 이벤트 태그 지정이 [music], [laughter] 같은 태그를 해당 위치에 넣습니다.
녹취록으로 자막 만들기
녹취록 출력을 자막 추가의 녹취록 입력에 연결하세요. 그러면 자막 추가가 단어마다 타이밍을 맞춰 자막을 그립니다. 이때는 ElevenLabs STT나 Incredibly Fast Whisper를 사용하세요.
Whisper 녹취록으로는 자막을 만들 수 없습니다. Whisper를 쓰는 음성 텍스트 변환 노드가 자막 추가에 연결되어 있으면, 무엇이든 실행되거나 요금이 청구되기 전에 다음 메시지와 함께 실행이 거부됩니다.
Captions need word timings, but the "whisper" engine does not return word timings — pick incredibly-fast-whisper or elevenlabs-stt.- 이 검사는 EDL 적용을 거치는 연결과, 깊이에 상관없이 하위 워크플로 안의 연결도 확인합니다.
- 연결이 생기는 즉시 설정 패널의 공급자 옆에도 같은 경고가 표시되므로, 실행하기 전에 고칠 수 있습니다.
- 음성 텍스트 변환 노드만 단독으로 실행하는 것은 절대 막히지 않습니다. Whisper 녹취록을 다른 곳으로 보내는 것도 괜찮습니다.
- 미리 확인할 수 없는 경우가 하나 있습니다. 음성 텍스트 변환과 자막 추가가 하위 워크플로 경계를 사이에 두고 서로 다른 쪽에 있는 연결입니다. 이 경우 음성 텍스트 변환이 실행되고 요금이 청구된 뒤에 자막 추가에서 실행이 실패합니다.
크레딧
음성 텍스트 변환은 오디오 길이와 상관없이 실행당 고정 가격입니다.
| 엔진 | 실행당 크레딧 |
|---|---|
| ElevenLabs STT | 25 |
| Incredibly Fast Whisper | 44 |
| Whisper | 44 |
자막 추가에 연결된 Whisper 녹취록처럼 시작 전에 거부된 요청에는 요금이 청구되지 않습니다.
셀프 호스팅 설치에서
각 엔진은 내 공급자 키로 실행됩니다. 선택한 엔진의 키가 없고 설치에 Nodaro Cloud 연결이 있으면, 텍스트 변환은 그 연결을 통해 실행됩니다. 둘 다 없으면 노드가 실패하고, 추가해야 할 키를 알려 주는 메시지가 표시됩니다. 공급자 키를 참조하세요.
팁
- 언어는 자동 감지로 두세요. 언어를 알고 있을 때만 선택하세요. 예를 들어 비슷하게 들리는 두 언어가 있을 때입니다.
- 대화에는 화자 레이블을 붙이세요. 인터뷰, 회의, 팟캐스트에는 화자 분리를 켜세요.
- 필요할 때 이벤트 태그를 붙이세요. 배경 소리가 녹음을 이해하는 데 도움이 될 때는 오디오 이벤트 태그 지정을 켜세요.
- 잡음이 많은 오디오는 먼저 정리하세요. 음성 텍스트 변환 전에 녹음을 음성 추출에 통과시키세요.
- 아주 긴 오디오는 나누세요. 짧은 구간일수록 더 안정적으로 텍스트로 변환됩니다. 구간 분할은 긴 파일을 최소 길이와 최대 길이 사이의 구간으로 나누며, 텍스트 변환은 구간마다 한 번씩 실행됩니다.
- 대신 내 스크립트를 맞추세요. 정확한 스크립트가 이미 있다면, 강제 정렬이 스크립트의 각 단어를 오디오에 맞춰 타이밍을 정합니다.
API에서 사용
POST /v1/transcribe는 audioUrl과 선택 항목인 provider(elevenlabs-stt, incredibly-fast-whisper, whisper), language, diarize, tagAudioEvents, wordTimestamps를 받습니다.
- 엔진을 지정하세요.
provider가 없는 요청은 Whisper로 실행되므로, 기존 호출자는 쓰던 엔진을 그대로 씁니다. 단어 타이밍,diarize,tagAudioEvents가 필요하면 반드시provider를 설정하세요. - 단어 타이밍.
incredibly-fast-whisper는wordTimestamps: true일 때만 단어를 반환합니다.whisper에wordTimestamps: true를 보내면 작업이 만들어지기 전에400 validation_error로 거부되므로 요금이 청구되지 않습니다. 엔진이 몰래 바뀌는 일은 없습니다. - 자막. 완료된 작업의
output_data.words는 이미 자막 형태(text,startMs,endMs)입니다. 이것을captions로POST /v1/add-captions에 넘기면 자막 추가가 다시 텍스트로 변환하지 않습니다. - 가격.
GET /v1/credits/model-cost?model=<engine>은 내 계정의 정확한 가격을 반환합니다.
SDK 메서드는 client.audio.transcribe이고, CLI 명령은 nodaro audio transcribe --provider <engine>입니다. MCP 도구 transcribe는 항상 ElevenLabs STT로 실행되므로 결과에 언제나 단어 타이밍이 들어 있습니다. 보이스 및 미디어를 참조하세요.
자주 묻는 질문
어떤 음성 인식 엔진을 골라야 하나요?
기본값인 ElevenLabs STT를 그대로 쓰세요. 항상 단어 타이밍을 반환하고, 화자 레이블과 오디오 이벤트 태그를 붙일 수 있으며, 가장 저렴합니다. Incredibly Fast Whisper도 노드가 필요로 할 때 단어 타이밍을 반환합니다. Whisper는 구문 단위만 반환하지만, 일반 녹취록에는 그것으로 충분합니다.
음성 텍스트 변환과 자막 추가를 쓰는 워크플로가 거부된 이유는 무엇인가요?
음성 텍스트 변환 노드가 Whisper를 쓰고 있기 때문입니다. Whisper는 단어 타이밍을 반환하지 않는데, 자막에는 단어 타이밍이 필요합니다. 공급자를 ElevenLabs STT나 Incredibly Fast Whisper로 바꾸고 다시 실행하세요. 실행은 시작되기 전에 거부되므로 요금이 청구되지 않습니다.
음성 텍스트 변환에는 크레딧이 얼마나 드나요?
오디오 길이와 상관없이 실행당 고정 가격입니다. ElevenLabs STT는 25크레딧, Incredibly Fast Whisper는 44크레딧, Whisper는 44크레딧입니다.
음성 텍스트 변환으로 화자를 구분할 수 있나요?
네, ElevenLabs STT라면 가능합니다. 화자 분리를 켜면 텍스트의 각 구간 앞에 “Speaker 1:”(화자 1) 같은 화자 레이블이 붙습니다. 구조화된 녹취록에서도 단어마다 화자가 함께 기록됩니다.
동영상도 텍스트로 변환할 수 있나요?
네. 동영상을 오디오 입력에 연결하면 노드가 그 동영상의 오디오 트랙을 텍스트로 변환합니다.
관련 문서
자막 추가
강제 정렬
편집 계획
음성 추출
ElevenLabs STT
최종 업데이트