
 Nodaro 문서
텍스트 음성 변환
ElevenLabs v4, v4 Turbo, v3, Turbo v2.5, Multilingual v2로 텍스트를 자연스러운 음성으로 바꿉니다. 보이스를 고르고, 오디오 태그로 감정을 더하고, 46개 언어로 읽으세요.
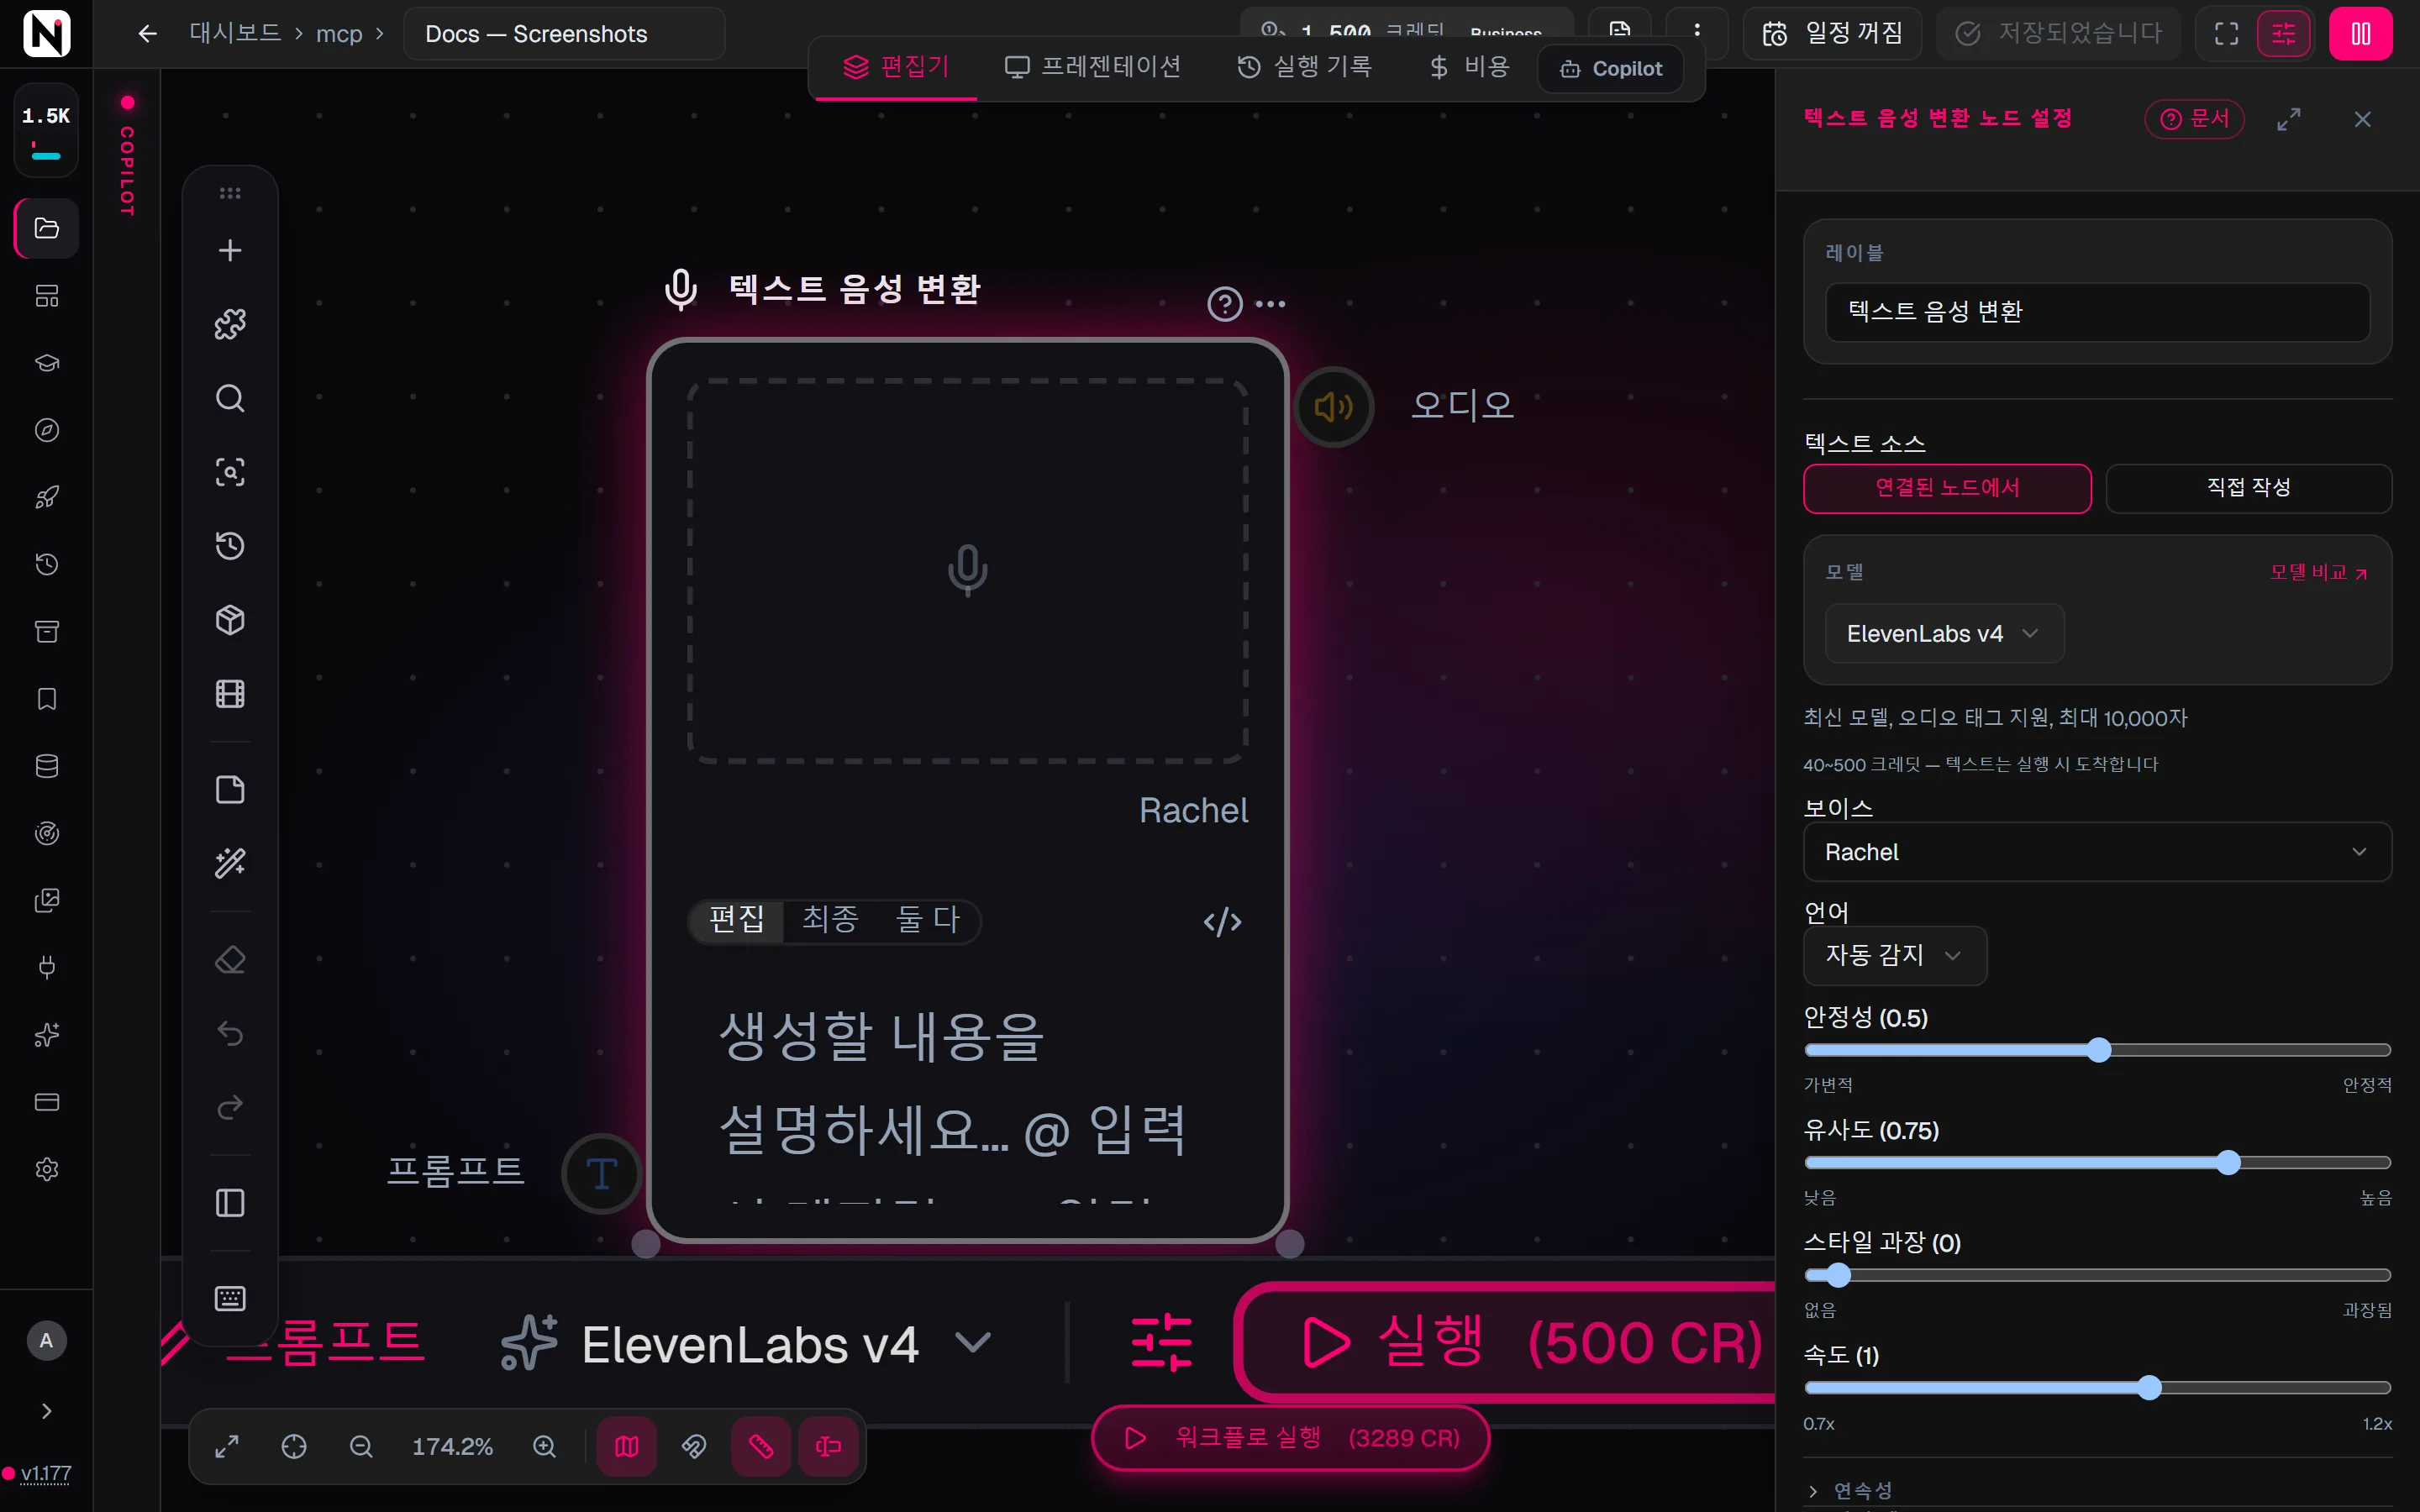
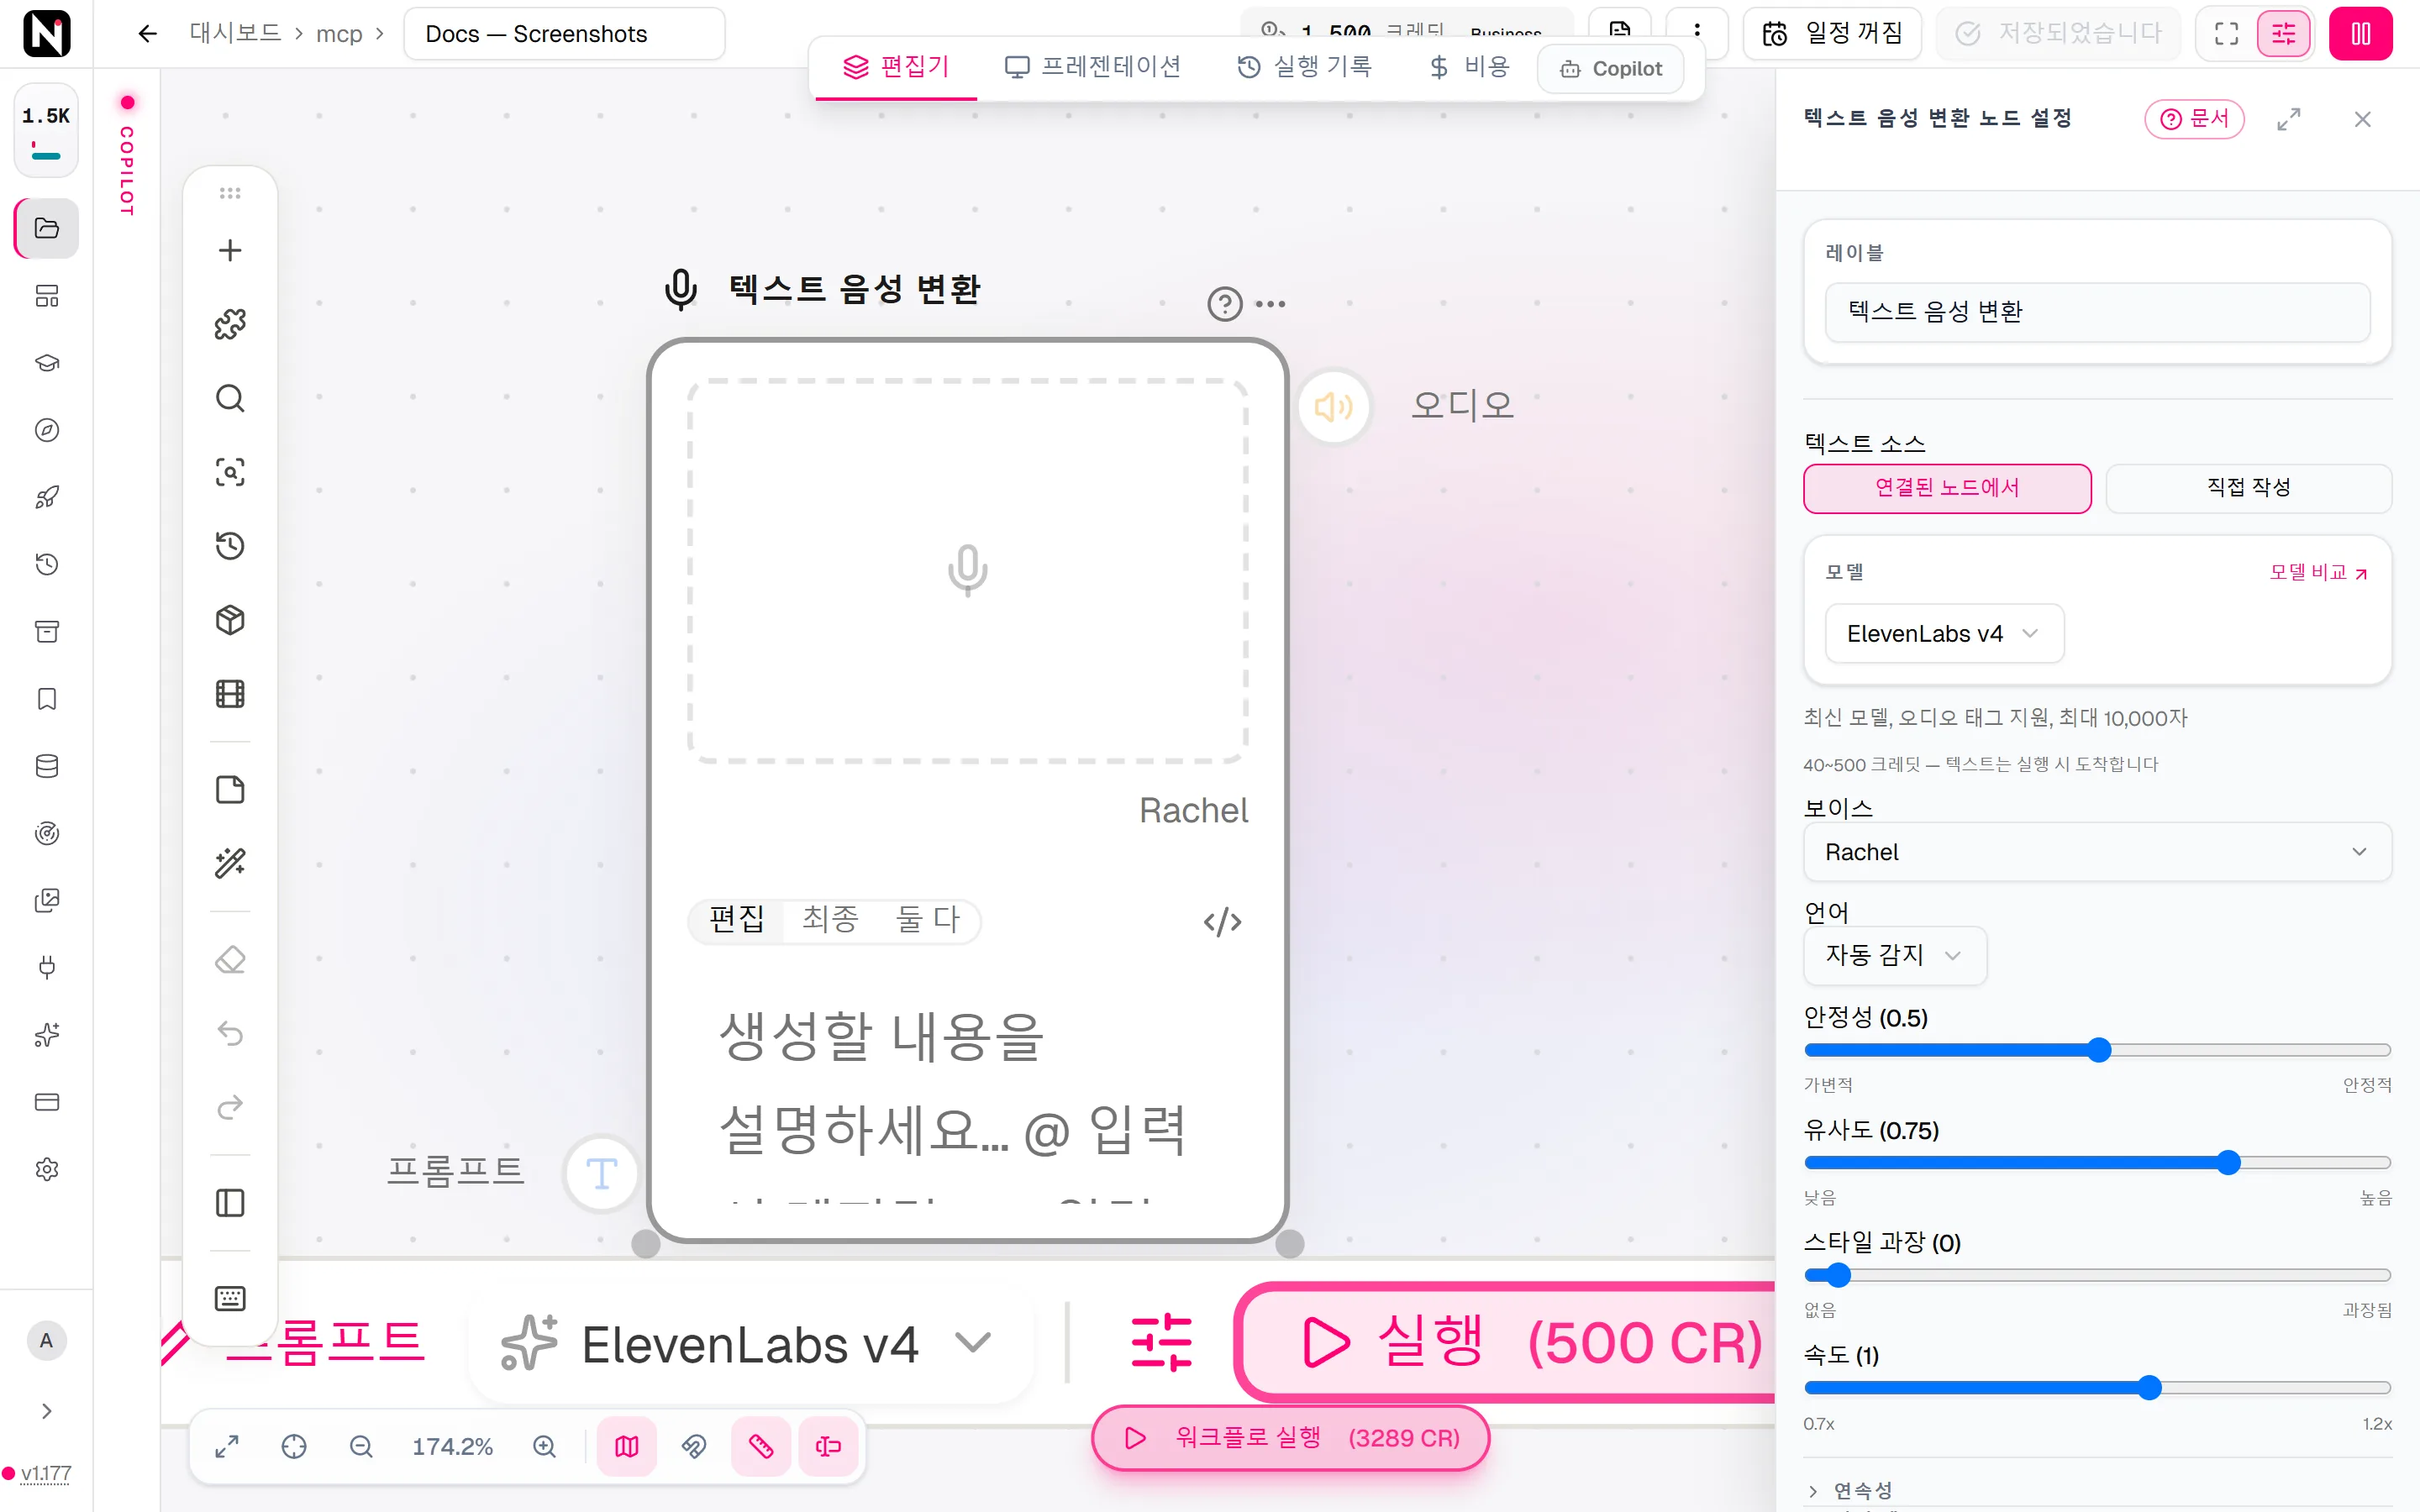
텍스트 음성 변환 노드는 ElevenLabs 보이스 모델로 텍스트를 음성 오디오로 바꿉니다. 텍스트를 쓰거나 연결하고, 보이스와 모델을 고르세요. 노드가 돌려주는 오디오 파일은 동영상 아래에 깔거나, 얼굴에 립싱크하거나, 음악과 믹스할 수 있습니다. 기본 모델인 ElevenLabs v4는 46개 언어를 말하고 [laughs], [whispers] 같은 오디오 태그를 이해합니다.
사용 시기
- 동영상, 설명 영상, 광고에 내레이션이 필요할 때.
- 캐릭터가 대사를 말하게 하고 싶을 때. 예를 들어 립싱크로 포트레이트를 움직이기 전에.
- 작성한 대본으로 팟캐스트 스타일 오디오를 만들고 싶을 때.
- 같은 대본을 여러 언어로 만들고 싶을 때.
- 감정, 반응, 쉼을 텍스트에 바로 써서 표현력 있게 읽히고 싶을 때.
여러 보이스가 나누는 대화를 파일 하나로 만들려면 대신 텍스트로 대화 만들기를 사용하세요.
빠른 시작
노드 추가
캔버스에서 Tab 키를 누르고 오디오 › 음성 및 내레이션 › 텍스트 음성 변환을 선택하세요.
텍스트 주기
텍스트, 텍스트 생성 - 모든 LLM, 대본 생성 노드를 프롬프트 입력에 연결하세요. 대신 노드에 텍스트를 직접 입력하려면 설정 패널을 열고 텍스트 소스를 직접 작성으로 설정하세요.
보이스와 모델 선택
보이스에서 보이스 브라우저를 열고, 미리 듣기를 몇 개 들어 본 다음 하나를 고르세요. 모델은 더 긴 텍스트나 더 낮은 가격이 필요하지 않으면 ElevenLabs v4로 두세요.
실행
노드에서 실행을 클릭하세요. 음성이 플레이어와 함께 노드에 나타나며, 이전 결과는 모두 결과 스트립에 남습니다.
입력
| 입력 | 받는 것 | 하는 일 |
|---|---|---|
| 프롬프트 | 텍스트, 텍스트 생성 - 모든 LLM, 대본 생성, 텍스트 합치기 같은 텍스트 노드 | 텍스트 소스가 연결된 노드에서일 때 읽을 텍스트입니다. |
이전 텍스트와 다음 텍스트에는 필드 매핑으로 다른 노드의 텍스트를 받을 수도 있습니다. 클립 간 연속성을 참고하세요.
출력인 오디오는 음성 오디오의 URL입니다. 여러 노드에 동시에 보낼 수 있습니다.
설정
| 설정 | 하는 일 |
|---|---|
| 텍스트 소스 | 연결된 노드에서(기본값)는 프롬프트에 연결된 텍스트를 읽습니다. 직접 작성은 텍스트에 입력한 텍스트를 읽습니다. |
| 텍스트 | 텍스트 소스가 직접 작성일 때 읽을 텍스트입니다. [ 또는 /를 입력하면 오디오 태그를 넣을 수 있습니다. {Script}처럼 다른 노드의 라벨을 중괄호로 감싸 쓰면 그 노드의 값을 넣을 수 있습니다. |
| 모델 | ElevenLabs v4(기본값), ElevenLabs v4 Turbo, ElevenLabs v3, ElevenLabs Turbo v2.5, ElevenLabs Multilingual v2 중에서 고르세요. |
| 보이스 | 말하는 보이스입니다. 보이스 브라우저가 열립니다. 기본값은 Rachel입니다. |
| 언어 | 자동 감지(기본값) 또는 모델 목록의 언어 하나를 고르세요. |
| 안정성 | 0~1입니다. 값이 낮을수록 더 표현력 있고 다채롭게, 높을수록 더 고르게 들립니다. |
| 유사도 | 0~1입니다. 결과가 보이스의 음색과 얼마나 가까운지 정합니다. ElevenLabs v4, v4 Turbo, Turbo v2.5, Multilingual v2 전용입니다. |
| 스타일 과장 | 0~1입니다. 원래 보이스의 스타일을 더 강하게 합니다. Turbo v2.5와 Multilingual v2 전용입니다. |
| 속도 | 0.7x~1.2x입니다. Turbo v2.5와 Multilingual v2 전용입니다. |
| 이전 텍스트 | 연속성 아래에 있습니다. 이 클립 바로 앞에 말하는 대사입니다. 모델은 이를 맥락으로 읽지만 말하지는 않습니다. 최대 1,000자입니다. |
| 다음 텍스트 | 연속성 아래에 있습니다. 이 클립 바로 뒤에 말하는 대사입니다. 최대 1,000자입니다. |
| 앞뒤 텍스트 | 읽을 텍스트 앞뒤에 항상 붙는 텍스트입니다. 내 워크플로를 앱으로 쓰는 사람에게는 보이지 않습니다. 프롬프트 앞뒤 텍스트를 참고하세요. |
패널에는 고른 모델이 쓰는 설정만 표시됩니다. ElevenLabs v3에는 안정성만 있습니다. ElevenLabs v4와 v4 Turbo에는 안정성과 유사도가 있습니다. v2 모델에는 슬라이더 네 개가 모두 있습니다. 다른 모델을 고르면 새 모델이 쓰지 않는 설정은 지워지고, 새 모델이 지원하지 않는 언어는 자동 감지로 돌아갑니다.
보이스 설정은 보이스의 미리 듣기를 따릅니다. 슬라이더를 건드리지 않으면 노드는 보이스에 저장된 자체 설정, 즉 미리 듣기를 만들 때 쓴 설정을 사용합니다. 그래서 결과가 내가 들은 미리 듣기처럼 들립니다. 슬라이더를 움직이면 그 값만 바뀌고, 보이스의 나머지 저장된 설정은 그대로 유지됩니다.
게시한 앱에서는 안정성과 유사도를 슬라이더로 공개할 수 있습니다. 슬라이더는 노드 자체의 값에서 시작하고, 노드에 값이 없으면 0.5와 0.75에서 시작합니다. ElevenLabs v3는 유사도를 무시합니다.
모델
텍스트 음성 변환은 아래의 ElevenLabs 음성 모델 다섯 가지를 실행할 수 있습니다. 모델을 클릭하면 크레딧 가격을 볼 수 있습니다.
| 모델 | 개발사 | 모드 | 크레딧 | 세부 정보 |
|---|---|---|---|---|
| ElevenLabs v4 | ElevenLabs | 텍스트 음성 변환 | 5부터 | 가장 최신의 ElevenLabs 텍스트 음성 변환 모델입니다. [오디오 태그], 안정성과 유사도 조절을 지원하며 요청당 최대 10,000자를 처리합니다. ElevenLabs API를 직접 사용합니다. |
| ElevenLabs v4 Turbo | ElevenLabs | 텍스트 음성 변환 | 3부터 | 충실도는 낮지만 더 빠르고 저렴한 ElevenLabs v4입니다. [오디오 태그], 안정성과 유사도 조절을 Turbo의 크레딧 가격으로 쓸 수 있습니다. 품질이 중요하면 v4를 쓰세요. ElevenLabs API를 직접 사용합니다. |
| ElevenLabs v3 | ElevenLabs | 텍스트 음성 변환 | 5부터 | 표현력이 풍부한 ElevenLabs 텍스트 음성 변환 모델입니다. 감정과 속도를 조절하는 [오디오 태그]를 지원합니다. ElevenLabs API를 직접 사용합니다. |
| ElevenLabs Turbo v2.5 | ElevenLabs | 텍스트 음성 변환 | 3부터 | ElevenLabs API를 직접 사용하는 빠르고 저렴한 ElevenLabs 텍스트 음성 변환 모델입니다. 내레이션에 적합합니다. |
| ElevenLabs Multilingual v2 | ElevenLabs | 텍스트 음성 변환 | 5부터 | ElevenLabs API를 직접 사용하는 다국어 ElevenLabs 텍스트 음성 변환 모델입니다. |
| 모델 | 언어 | 오디오 태그 | 연속성 | 실행당 글자 수 |
|---|---|---|---|---|
| ElevenLabs v4(기본값) | 46 | 예 | 예 | 10,000 |
| ElevenLabs v4 Turbo | 46 | 예 | 예 | 10,000 |
| ElevenLabs v3 | 46 | 예 | 아니요 | 5,000 |
| ElevenLabs Turbo v2.5 | 32 | 아니요, 읽기 전에 지워짐 | 예 | 40,000 |
| ElevenLabs Multilingual v2 | 29 | 아니요, 읽기 전에 지워짐 | 예 | 10,000 |
어떤 모델을 선택할까
- ElevenLabs v4: 기본값입니다. 표현력 있는 음성, 오디오 태그, 가장 폭넓은 언어 지원, 실행당 최대 10,000자가 필요할 때 고르세요. 속도와 스타일 과장 설정은 없습니다.
- ElevenLabs v4 Turbo: v4와 같은 오디오 태그와 설정을 쓰며, 더 빠르고 저렴하지만 충실도는 낮습니다. 태그를 쓴 내레이션을 저렴하게 만들 때 고르고, 품질이 중요하면 v4를 고르세요.
- ElevenLabs v3: 이전 모델입니다. 오디오 태그와 언어는 같고, 실행당 최대 5,000자입니다. v3로 저장한 노드는 계속 v3로 실행됩니다.
- ElevenLabs Turbo v2.5: 더 저렴하고 빠릅니다. 일반 내레이션과 긴 텍스트에 고르세요. 실행 한 번에 최대 40,000자까지 됩니다.
- ElevenLabs Multilingual v2: 29개 언어로 자연스럽게 읽으며, 실행 한 번에 최대 10,000자까지 됩니다.
같은 보이스라도 v4에서는 v3와 꽤 다르게 들릴 수 있고, 소리가 더 작게 나오는 경우가 많습니다. 완성된 프로젝트를 바꾸기 전에 내 보이스로 두 모델을 비교해 보세요.
Nodaro의 모든 오디오 모델은 모델 선택을 참고하세요.
보이스 선택
보이스 브라우저에는 탭이 세 개 있습니다.
- 기본 제공: ElevenLabs의 표준 보이스.
- 내 보이스: 이미 가지고 있는 사용자 지정 보이스. 설명으로 새 보이스를 만들려면 보이스 디자인을 사용하세요.
- 보이스 라이브러리: 공유 ElevenLabs 라이브러리로, 억양, 나이, 언어, 용도, 톤으로 검색하고 필터링할 수 있습니다.
모든 보이스에는 고르기 전에 재생해 볼 수 있는 미리 듣기가 있습니다.
보이스 라이브러리의 보이스는 만든 사람이 특정 모델용으로 검증합니다. 노드가 Turbo v2.5나 Multilingual v2를 실행하는데, 그 모델용으로 검증되지 않은 라이브러리 보이스를 골랐다고 해 봅시다. 그러면 노드가 모델을 그 보이스가 검증된 모델로 바꿉니다. 순서는 ElevenLabs v4, v3, v4 Turbo, 가장 저렴한 v2 모델입니다. ElevenLabs v4, v4 Turbo, v3 노드는 보이스를 골라도 바뀌지 않습니다.
오디오 태그로 감정 더하기
ElevenLabs v4, v4 Turbo, v3는 오디오 태그를 읽습니다. 오디오 태그는 대괄호로 감싼 짧은 지시로, 텍스트에서 효과가 들어갈 위치에 넣습니다. 예: I can't believe it [laughs] that's amazing(믿을 수가 없어요 [laughs] 정말 놀라워요).
| 종류 | 예 |
|---|---|
| 감정 | [excited], [sad], [angry] |
| 반응 | [laughs], [sighs], [gasps] |
| 전달 방식 | [whispers], [shouting] |
| 속도와 쉼 | [pause], [long pause] |
| 톤 | [cheerfully], [deadpan] |
| 효과음 | [applause], [thunder] |
v2 모델은 읽기 전에 오디오 태그를 지우므로, 남은 텍스트가 어색하게 읽힐 수 있습니다. v2 모델에서 쉼을 넣으려면 대신 <break time="1.0s" /> 같은 break 태그를 쓰세요.
차이 들어 보기
아래 두 결과는 모두 ElevenLabs v3와 기본 제공 보이스 Rachel을 사용했습니다. 첫 번째는 오디오 태그 두 개가 들어간 텍스트를 읽고, 두 번째는 같은 문장을 태그 없이 읽습니다.
번역된 프롬프트입니다. 모델에는 아래에 있는 영어 원문을 보냈습니다.
영어 원문 프롬프트
언어
대부분의 텍스트에는 자동 감지가 잘 작동합니다. 영어가 아닌 텍스트는 언어를 직접 고르면 발음이 좋아질 수 있습니다.
- Multilingual v2(29개 언어): 영어, 일본어, 중국어, 독일어, 힌디어, 프랑스어, 한국어, 포르투갈어, 이탈리아어, 스페인어, 인도네시아어, 네덜란드어, 튀르키예어, 필리핀어, 폴란드어. 이 밖에 스웨덴어, 불가리아어, 루마니아어, 아랍어, 체코어, 그리스어, 핀란드어, 크로아티아어, 말레이어, 슬로바키아어, 덴마크어, 타밀어, 우크라이나어, 러시아어도 지원합니다.
- Turbo v2.5(32개 언어): Multilingual v2의 모든 언어와 헝가리어, 노르웨이어, 베트남어.
- v3, v4, v4 Turbo(46개 언어): Turbo v2.5의 모든 언어와 히브리어, 태국어, 벵골어, 우르두어, 페르시아어, 세르비아어, 리투아니아어, 라트비아어, 에스토니아어, 조지아어, 아이슬란드어, 카탈루냐어, 아프리칸스어, 스와힐리어.
클립 간 연속성
내레이션을 클립 하나씩 만들면(예: 샷마다 클립 하나) 컷마다 억양이 처음부터 다시 시작됩니다. 이전 텍스트와 다음 텍스트로 이를 해결할 수 있습니다. 이전 텍스트에는 이 클립 바로 앞에 말하는 대사를, 다음 텍스트에는 바로 뒤에 말하는 대사를 넣으세요. 그러면 클립이 앞 클립에서 이어지고 다음 클립으로 자연스럽게 넘어갑니다. 모델은 이 맥락을 읽지만 말하지는 않으며, 클립 길이도 바뀌지 않습니다.
연속성 섹션은 맥락을 쓰는 모델에서만 접힌 상태로 나타납니다. ElevenLabs v4, v4 Turbo, Turbo v2.5, Multilingual v2가 해당합니다. ElevenLabs v3는 맥락을 쓰지 않으며, 노드를 v3로 바꾸면 두 필드가 모두 지워집니다. 각 필드는 최대 1,000자입니다. 더 긴 이전 텍스트는 끝부분이, 더 긴 다음 텍스트는 앞부분이 남습니다.
두 필드 모두 필드 매핑으로 다른 노드의 텍스트를 받을 수 있습니다. 예를 들어 앞 샷의 대사를 담은 텍스트 노드입니다. 두 필드 모두 게시한 앱의 텍스트 입력으로 공개할 수도 있습니다. 맥락을 넣어도 가격은 바뀌지 않습니다.
크레딧
가격은 텍스트 길이에 따라 정해집니다. 실행 한 번은 보내는 텍스트의 시작된 100자마다 청구되며, 최소 8단위가 청구됩니다.
| 모델 | 시작된 100자당 크레딧 |
|---|---|
| ElevenLabs v4 | 5 |
| ElevenLabs v4 Turbo | 3 |
| ElevenLabs v3 | 5 |
| ElevenLabs Turbo v2.5 | 3 |
| ElevenLabs Multilingual v2 | 5 |
세는 글자는 앞뒤 텍스트를 포함해 실제로 보내는 텍스트입니다. 모델 한도를 넘는 부분은 세지 않으며, Turbo v2.5와 Multilingual v2는 지우는 오디오 태그도 세지 않습니다. 정확한 가격은 실행 전에 노드의 실행 버튼에 표시됩니다. 텍스트가 다른 노드에서 오면 버튼에 최소 가격부터 모델의 글자 수 한도까지의 범위가 표시됩니다.
게시한 앱에서는 노드 자체의 텍스트를 입력으로 공개할 수 있습니다. 앱의 입력 목록에서 노드를 펼치고 텍스트를 체크한 다음, 한도가 필요하면 최대 글자 수를 채우세요. 그러면 앱은 더 긴 텍스트를 실행 전에 거부하고, 앱에 표시되는 가격은 그 글자 수의 가격이 됩니다. 한도가 없으면 앱 가격은 모델의 글자 수 한도로 계산됩니다. 텍스트 소스가 연결된 노드에서이면, 앱의 텍스트는 연결된 텍스트가 비어 있을 때만 쓰입니다.
팁
- 안정성은 0.5 근처로 두세요. 표현력과 일관성의 균형이 맞습니다. 고르게 들려야 하는 내레이션이면 1 쪽으로 옮기세요.
- 효과가 들어갈 위치에 태그를 넣으세요. 문장 중간에 넣은 태그는 바로 그 지점에서 전달 방식을 바꿉니다.
- 긴 대본은 나누세요. ElevenLabs v3는 실행당 5,000자, v4는 10,000자까지 받습니다. 더 긴 대본은 여러 노드로 나누고 이전 텍스트와 다음 텍스트로 전달을 이어지게 하거나, Turbo v2.5로 바꾸세요.
- 목소리를 장면 안에 두세요. 동영상 위의 건조한 목소리는 다른 곳에서 녹음한 것처럼 들릴 수 있습니다. 방(실내) 같은 잔향을 넣어 오디오 효과를 거치게 하세요.
- 여러 클립의 레벨을 맞추세요. 클립을 정규화를 켠 볼륨 조절에 거치게 해 같은 크기로 재생되게 하세요.
문제 해결
보이스 오류로 실행이 실패합니다. 보이스가 더 이상 존재하지 않습니다. 예를 들어 보이스 라이브러리에서 삭제되었을 수 있습니다. 다른 보이스를 골라 노드를 다시 실행하세요.
길이 때문에 실행이 거부되거나 텍스트의 끝부분이 빠졌습니다. 텍스트가 모델의 한도보다 깁니다. 워크플로 실행은 이런 텍스트를 크레딧이 청구되기 전에 거부하고, 메시지에 글자 수와 한도를 보여 줍니다. API 요청은 대신 텍스트를 한도에서 자릅니다. 텍스트를 나누거나 ElevenLabs Turbo v2.5로 바꾸세요.
대괄호 속 단어가 빠지거나 텍스트가 이상하게 읽힙니다. v2 모델에서 오디오 태그를 썼는데, v2 모델은 태그를 지웁니다. 모델을 ElevenLabs v4, v4 Turbo, v3 중 하나로 바꾸거나 태그를 지우세요.
API에서 사용
POST /v1/text-to-speech로 코드에서 같은 노드를 실행할 수 있습니다. 요청에 provider가 없으면 Nodaro가 길이에 따라 고릅니다. 10,000자 이내의 텍스트는 ElevenLabs v4로, 더 긴 텍스트는 Turbo v2.5로 실행하므로, 긴 텍스트가 v4의 한도에서 잘리는 일은 없습니다. 요청은 실제로 실행된 모델로 청구됩니다. 내가 설정한 provider는 항상 그대로 사용됩니다. v3 보이스를 계속 쓰려면 elevenlabs-v3를 지정하세요.
요청은 연속성을 위한 previousText와 nextText를 받습니다. withTimestamps: true를 보내면 완료된 작업의 output_data.transcript에 모든 단어의 타이밍(startMs와 endMs가 있는 words[])도 담기며, 추가 크레딧은 들지 않습니다. 범위를 벗어난 보이스 설정이나 텍스트로 보낸 숫자는 400으로 거부됩니다.
MCP 도구 generate_speech는 모델을 지정하지 않으면 ElevenLabs v4로 실행합니다. 최대 10,000자를 받으며, 고른 모델의 한도보다 긴 텍스트는 자르지 않고 거부합니다. 알 수 없는 기본 제공 보이스 ID는 Rachel로 대체되므로 어시스턴트가 오디오를 받을 수 있습니다. 존재하지 않는 library 또는 custom 보이스는 실패합니다. 보이스 및 미디어와 MCP 도구를 참고하세요.
자주 묻는 질문
텍스트 음성 변환에서 어떤 모델을 골라야 하나요?
기본값인 ElevenLabs v4로 시작하세요. 46개 언어를 말하고, 감정과 속도를 조절하는 오디오 태그를 이해하며, 실행 한 번에 최대 10,000자까지 받습니다. 태그를 쓴 내레이션을 더 저렴하게 만들려면 ElevenLabs v4 Turbo를, 아주 긴 텍스트에는 Turbo v2.5를 사용하세요. Turbo v2.5는 실행 한 번에 최대 40,000자까지 받습니다.
텍스트는 얼마나 길게 쓸 수 있나요?
실행 한 번에 ElevenLabs v4, v4 Turbo, Multilingual v2는 최대 10,000자, v3는 최대 5,000자, Turbo v2.5는 최대 40,000자를 읽습니다. 워크플로 실행은 더 긴 텍스트를 크레딧이 청구되기 전에 거부하며, 그 전에 설정 패널이 경고를 보여 줍니다. API에서는 더 긴 텍스트가 한도에서 잘립니다.
보이스가 웃거나, 속삭이거나, 쉬게 하려면 어떻게 하나요?
ElevenLabs v4, v4 Turbo, v3에서 효과가 들어갈 위치에 대괄호로 오디오 태그를 쓰세요. 예를 들어 “믿을 수가 없어요 [laughs] 정말 놀라워요”처럼 씁니다. v2 모델은 읽기 전에 오디오 태그를 지웁니다.
텍스트 음성 변환의 가격은 얼마인가요?
가격은 텍스트 길이에 따라 정해집니다. 시작된 100자마다 정해진 크레딧이 들고, 실행 한 번의 최소 가격은 8단위입니다. ElevenLabs v4 Turbo와 Turbo v2.5는 v4, v3, Multilingual v2보다 단위당 가격이 낮으며, 정확한 가격은 실행 전에 노드에 표시됩니다.
내 목소리를 쓸 수 있나요?
이미 가지고 있는 사용자 지정 보이스는 보이스 브라우저의 내 보이스에 나타납니다. 글로 쓴 설명으로 새 사용자 지정 보이스를 만들려면 보이스 디자인 노드를 사용하세요.
내가 고른 보이스가 삭제되었으면 어떻게 되나요?
실행이 명확한 오류와 함께 실패합니다. Nodaro는 알리지 않고 다른 보이스로 바꾸지 않으므로, 다른 보이스를 골라 노드를 다시 실행하세요.
관련 문서
텍스트로 대화 만들기
보이스 디자인
립싱크
오디오 효과
ElevenLabs v4
최종 업데이트