
 Docs do Nodaro
Camera Motion Lab: como 147 vídeos nos ensinaram a mover uma câmera
Testamos 64 movimentos de câmera em 147 vídeos de IA: os termos de cinema não são a linguagem que um modelo de vídeo entende melhor. Veja o que funciona.
Testamos 64 movimentos de câmera e descobrimos que a terminologia do cinema não é, necessariamente, a linguagem que um modelo de vídeo entende melhor.
- Duração do estudo
- 25 dias
- Vídeos
- 147
- Imagens-base
- 13
- Opções aprovadas
- 64 de 64
- Créditos
- 72.118
- Modelo principal
- Seedance 2.5
No começo, o problema parecia simples.
Temos um seletor Movimento de câmera (Camera Motion). O usuário escolhe um movimento, como Órbita, Travelling, Dolly In ou Whip pan, e nós acrescentamos ao prompt do vídeo uma descrição curta desse movimento.
Começamos com a instrução profissional mais simples:
Qualquer diretor de fotografia ou diretor de cinema entenderia essa instrução na hora. O modelo mal se moveu.
Tentamos a Órbita:
De novo, o resultado não foi confiável. A direção só saiu certa em cerca de metade das vezes.
Tentamos explicar mais. Testamos outras formas de indicar a direção, graus, frases mais enfáticas, exclusões e durações de clipe diferentes. Às vezes, o resultado melhorava. Às vezes, piorava. E às vezes o modelo fazia algo completamente diferente.
Então paramos de dizer ao modelo o nome do movimento. Em vez disso, começamos a explicar o que a câmera faz fisicamente. Isso mudou quase tudo.
As duas descobertas que mudaram o estudo
Ao fim do experimento, tínhamos chegado a duas conclusões centrais.
O movimento de câmera é mais bem descrito como geometria do que só com terminologia.
O que se move, o que permanece constante, como os elementos próximos e distantes se movem uns em relação aos outros e onde a câmera deve terminar.
Na geração de imagem para vídeo, o quadro inicial faz parte da instrução.
Um prompt de movimento razoável ainda pode produzir o movimento errado quando a imagem de origem já está puxando o modelo para outra direção.
O que de fato testamos
O estudo durou 25 dias. Geramos 147 vídeos e 13 imagens-base, usando um total de 72.118 créditos, cerca de US$ 200–220 pelos preços públicos de recarga disponíveis durante o estudo.
98 vídeos foram gerados com o Seedance 2.5 em 480p, outros 47 com o Seedance 2 Fast e dois com o VEO 3.1, durante uma comparação inicial de provedores.
Ao final, todas as 64 opções do Movimento de câmera incluídas no escopo tinham sido aprovadas: 61 no Seedance 2.5 e três no Seedance 2 Fast.
Escopo: um estudo de engenharia de produto, não um benchmark estatístico
Não executamos cada prompt centenas de vezes para estimar uma probabilidade universal de sucesso. O objetivo era encontrar, para cada opção do seletor, uma instrução genérica e confiável o bastante para ser usada em produção. Os testes foram feitos principalmente com o Seedance 2.5 e o Seedance 2 Fast, usando imagem para vídeo (image-to-video), resolução de 480p e prompts em inglês. Quando este artigo diz que algo “funcionou” ou “falhou”, isso se refere ao que aconteceu nesta série de experimentos. Não significa que todo modelo de vídeo vai sempre se comportar da mesma forma.
Essa distinção ficou especialmente importante quando quase atribuímos ao modelo um viés que, no fim, não existia.
O “viés para a esquerda” que não existia
No início do estudo, testamos o mesmo movimento em direções opostas. A mesma imagem. A mesma estrutura de prompt. A mesma duração.
Para a esquerda, deu certo três vezes em três. Para a direita, deu certo uma vez em três. O padrão se manteve em 12 tentativas para a direita, com quatro formulações diferentes.
A conclusão parecia óbvia: o modelo tinha um viés para a esquerda. Chegamos a incluir 240 créditos extras no orçamento por causa disso. Estávamos errados.
O problema era a forma como descrevíamos a direção. Quando passamos a expressar a direção como o sentido em que a câmera se desloca, e não como um lado em relação ao sujeito, o padrão desapareceu. A partir daí, os movimentos para a direita testados com essa formulação passaram no primeiro take.
Essa se tornou uma das lições mais importantes do projeto:
LiçãoUm padrão de falha consistente não revela necessariamente algo sobre o modelo. Às vezes, revela algo sobre a sua redação.
A virada: movimento é geometria
O ponto de virada veio com o Arco para a direita. Em vez de dar ao modelo só o nome do movimento, descrevemos cinco coisas:
- O que a câmera faz fisicamente.
- O que permanece constante.
- Como os elementos próximos e distantes devem se mover uns em relação aos outros.
- Como o ponto de vista final deve ficar.
- Quais movimentos indesejados não devem acontecer.
O prompt aprovado ficou assim, com uma frase para cada um dos cinco itens:
| Parte | Frase do prompt aprovado de Arco para a direita |
|---|---|
| 1. Movimento | The camera slowly moves sideways to the right while curving around the subject, continuously turning toward the subject to keep the same centered framing. |
| 2. Constante | The camera maintains constant distance from the subject. |
| 3. Profundidade | As the viewpoint changes, strong natural parallax is visible: nearby environmental elements shift right noticeably while distant background elements shift right more slowly. |
| 4. Estado final | The shot ends from a slightly different three-quarter viewing angle. |
| 5. Proteção | No zoom, no push-in, no pull-out. |
A palavra parallax continua ali porque este é o prompt real que foi testado. A ideia é simples: quando a câmera se desloca fisicamente pelo espaço, objetos próximos e distantes não atravessam o quadro na mesma velocidade.
A diferença importante neste prompt não é o tamanho. Ele não depende mais de o modelo entender o que queremos dizer com Arc. Ele descreve o próprio movimento. A câmera se desloca para o lado enquanto faz uma curva em volta do sujeito e continua virando para ele para manter o enquadramento. Ela mantém a distância, vê os elementos próximos se deslocarem mais do que os distantes e termina de um ponto de vista um pouco diferente.
Antes dessa mudança, gastamos 12 takes no Arco para a direita e ainda assim tivemos um resultado fraco. Com a descrição geométrica, deu certo três vezes em três.
ReprovadoRedação no estilo de rótulo, take 1 de 12. Pedimos um arco para a direita, e ele foi para a esquerda.
AprovadoRedação geométrica, primeiro take.
Como saber se a câmera realmente se moveu?
A diferença entre o movimento dos objetos próximos e o dos distantes se tornou uma das nossas ferramentas de diagnóstico mais úteis.
Quando uma câmera se desloca fisicamente pelo espaço, a relação entre as camadas de profundidade muda. Um objeto perto da câmera costuma atravessar o quadro mais rápido do que um objeto distante. Se a câmera só gira no lugar, o quadro ainda se move, mas essa mudança de profundidade não acontece da mesma forma. E se o efeito for um zoom puro, a câmera não se move, e a perspectiva fica quase igual.
Isso nos deu uma classificação útil:
| Movimento | O que a câmera faz | O que você deve ver |
|---|---|---|
| Órbita, Dolly, Travelling, Pedestal, Grua | Se desloca pelo espaço | Uma mudança clara na relação entre os elementos próximos e os distantes |
| Pan, Tilt, Rotação | Gira no lugar | O quadro se move, mas sem a mesma mudança de profundidade |
| Zoom | Não se move | A perspectiva fica fixa, como se a mesma imagem fosse ampliada ou reduzida |
| Dolly Zoom | Se move enquanto a distância focal muda ao mesmo tempo | Um teste diferente, difícil de falsificar, mostrado abaixo |
Para o Dolly Zoom, o teste que escrevemos no prompt foi:
As maiúsculas estão como foram escritas no prompt aprovado.
O 360 que falhou cinco vezes
Uma volta completa em torno do sujeito foi um dos casos mais difíceis no início do estudo. A redação original nem chegou perto.
Tentamos 180 degrees e conseguimos algo mais próximo de uma volta completa, só que na direção errada. Tentamos:
Foi ainda pior: a câmera se afastou um pouco do ponto de partida e depois voltou. A certa altura, já tínhamos escrito nas nossas anotações que um 360 confiável talvez não fosse possível sem um vídeo de referência. Estávamos errados de novo.
A solução foi parar de pedir “360” e, em vez disso, descrever o trajeto como uma sequência de estados: um lado do sujeito, atrás do sujeito, o lado oposto e, depois, de volta ao ponto de partida. Também acrescentamos um teste difícil de falsificar:
Se a câmera não estiver de fato circulando o sujeito, é difícil cumprir essa condição de forma convincente. Por fim, acrescentamos:
A nova redação passou logo no primeiro take.
ReprovadoRedação original do catálogo. Longe de uma volta completa.
AprovadoTrajeto como uma sequência de estados, mais o teste difícil de falsificar. Primeiro take.
Às vezes, pedir “mais” dá menos
Em outro momento, tentamos estender o trajeto com a expressão:
O resultado foi o oposto do que esperávamos. A câmera começou na posição das 6 horas de um relógio imaginário em volta do sujeito. Com a expressão, ela só chegou a cerca de 5 horas; sem ela, foi até cerca de 4 horas.
Em outras palavras, pedir um trajeto mais longo encurtou o movimento.
Os números também não nos deram a precisão que esperávamos. 180 degrees, por exemplo, não produziu de forma confiável um movimento de 180 graus. Nossa conclusão não foi que números estão sempre errados. Foi que um ângulo ou uma magnitude de movimento em números, dentro do prompt, não era confiável o bastante para esse fim. Outro número, porém, acabou fazendo muita diferença: a duração do clipe.
A duração do clipe faz parte do movimento
O mesmo prompt percorreu cerca de um sexto de um círculo em cinco segundos e cerca de 150 graus em 15 segundos. Mas havia um limite. Em uma tentativa de 15 segundos, a câmera chegou ao ponto final e depois inverteu a direção para preencher o tempo restante.
Se o movimento correto termina e depois começa a voltar, confira primeiro se o clipe deveria ser mais curto. Não reescreva o prompt imediatamente.
Há uma exceção importante: Câmera que respira e Push-pull. Nesses dois movimentos, o vaivém repetido para dentro e para fora é o próprio movimento. Neles, estendemos o clipe para 10 segundos, para dar tempo de a repetição ser bem percebida.
Peça a aparência da velocidade
Palavras como “fast” ou “slow”, sozinhas, também não nos deram controle suficiente. O que funcionou melhor foi descrever a consequência visível da velocidade. Para o Whip pan, por exemplo, usamos:
Para a Aproximação imperceptível, fizemos quase o contrário:
Combinada com uma duração adequada, a diferença ficou muito mais clara. Dentro da família Dolly, isso criou, na prática, uma escada:
A maior parte da geometria de base pode ficar quase idêntica. Então, em vez de só dizer ao modelo a que velocidade se mover, pode ser mais eficaz descrever como essa velocidade deve aparecer na tela.
Instruções negativas são uma proteção, não o motor
No começo, achávamos que instruções negativas simplesmente não funcionavam. Essa conclusão era forte demais.
Executamos três takes com:
A câmera continuou avançando. O que funcionou melhor foi primeiro definir o comportamento desejado de forma positiva:
E só depois acrescentar:
Nunca fizemos uma comparação controlada de um prompt aprovado com e sem a linha de exclusão, então não conseguimos medir quanto do sucesso veio especificamente dessa linha. A conclusão mais cuidadosa é que a instrução positiva é o motor principal, e as exclusões servem como uma proteção adicional no nosso processo. O Toque na tela e a Troca de câmera reforçam o mesmo padrão: as correções bem-sucedidas combinaram uma descrição positiva do que deveria acontecer com exclusões explícitas do que não deveria aparecer.
Palavras podem vazar para o vídeo
Na segunda metade do estudo, descobrimos que às vezes o problema não era a física. Era uma única palavra. Um modelo de vídeo pode pegar uma palavra escolhida só para descrever uma sensação e transformá-la em uma ação visual literal.
- Pedestal para cima. Escrevemos
rock strata ... descend into view. O modelo não mudou apenas o ponto de vista: ele fez as próprias rochas caírem e se amontoarem no fim do clipe. A frase nomeava um objeto específico da cena e ligava a ação para baixo ao objeto, e não à câmera. - Dolly Zoom. Usamos palavras como
bendedizzying. Em vez de esticar a profundidade, o quadro girou cerca de 90 graus. Palavras escolhidas para descrever uma sensação foram lidas como um pedido de rotação. - Toque na tela. A expressão
finger tapfez o modelo desenhar um dedo de verdade na cena, com direito a som de clique. - Troca de câmera. A palavra
rotatesvirou um giro suave e contínuo, como o de um carrossel, em vez de uma única virada rápida.
Use só vocabulário que pertence ao movimento que você realmente quer e proteja explicitamente os eixos que devem permanecer inalterados.
Para o Dolly Zoom, por exemplo:
ReprovadoTake 1, com “bend” e “dizzying”. O quadro girou cerca de 90 graus.
AprovadoTake 2. Redação só sobre a profundidade, com o quadro mantido nivelado.
Descreva o quadro, não o mundo dentro dele
A instrução do Movimento de câmera precisa funcionar com qualquer coisa que um usuário possa animar: um navio, um carro, um interior, uma rua, uma pessoa ou uma cena debaixo d'água. Por isso, ela não pode depender de a cena ter um céu, um piso, uma montanha, uma parede ou uma luminária específica.
No início do estudo, rejeitamos uma redação que mencionava the turquoise lamp post. Descrições específicas da cena podem de fato ajudar na imagem de teste, e é por isso que é fácil cair nessa armadilha. Mas, se o prompt só funciona porque a imagem tem um poste de luz turquesa, não construímos um movimento de câmera genérico. Construímos um prompt para uma única imagem.
Ao mesmo tempo, abstração demais também pode atrapalhar. No Travelling, tentamos trocar new elements keep entering from the left edge por uma formulação mais abstrata. Ela falhou. A palavra elements não se refere a nenhum conteúdo específico da cena, então restauramos a redação original.
Você pode descrever o comportamento dos elementos e das camadas de profundidade. Não nomeie objetos que talvez não existam na próxima cena.
Até o equipamento de câmera pode entrar na tomada
Às vezes, o equipamento de câmera nos ajudou a descrever uma restrição física. Um tripé permite rotação, mas impede o deslocamento da câmera. Um suporte vertical pode descrever uma subida sem rotação. Um jib pode descrever uma combinação de movimento vertical e mudança de ângulo.
Mas isso trouxe outra armadilha. Escrevemos:
O modelo simplesmente renderizou o trilho dentro da tomada.
ReprovadoEquipamento nomeado no prompt. O trilho foi desenhado na tomada.
AprovadoDolly In, sem nenhum equipamento nomeado.
Se o equipamento for usado como âncora física no prompt, cite um equipamento que naturalmente fica atrás da câmera e que não deve aparecer dentro do quadro.
A segunda descoberta: o quadro inicial também é um prompt
Na segunda metade do estudo, um novo padrão começou a surgir. A redação parecia correta. Nós a corrigimos. Depois, corrigimos de novo. A mesma falha continuava. Nesses casos, estávamos corrigindo a coisa errada. O problema era a imagem inicial.
Na geração de imagem para vídeo, o primeiro quadro não é só material de origem. Ele já diz ao modelo onde a câmera está, para onde ela aponta e que tipo de continuação é visualmente plausível. Às vezes, essa instrução é mais forte do que o texto.
Um POV que não conseguia virar POV
Testamos a Caminhada em POV em uma imagem que mostrava uma pessoa caminhando por uma floresta e pedimos que a câmera passasse a ser o ponto de vista dessa pessoa. A pessoa continuou no quadro.
Olhando para trás, isso faz sentido. A primeira imagem já estabelece que a câmera está fora da pessoa, olhando para ela. O modelo precisa continuar a partir desse quadro, e não apagar de repente o sujeito principal e reconstruir o ponto de vista de dentro dos olhos dele. Criamos uma nova imagem-base, um túnel de gelo sem nenhuma pessoa e sem nenhuma parte do corpo visível, e a mesma instrução básica passou imediatamente.
O Snorricam nos ensinou a lição oposta. Nele, precisamos justamente de um sujeito visível que fica fixo em relação à câmera enquanto o mundo se move em volta dele. Em uma imagem-base com uma pessoa caminhando, ele passou no primeiro take. A mesma característica de uma imagem inicial pode ser um defeito para um movimento e um requisito para outro.
O Sobrevoo estava decidido a descer
O Sobrevoo foi testado primeiro em uma imagem aérea de uma cidade em que a câmera já olhava para fora e para baixo. Pedimos um movimento para a frente em altitude constante. A câmera desceu. Reforçamos a redação. Ela desceu de novo. Ao mesmo tempo, as três tentativas da Aérea nessa mesma base se inclinaram para baixo em vez de produzir uma descida vertical limpa da câmera.
Em vez de acrescentar mais instruções, criamos uma nova base em altitude de cruzeiro: uma vista nivelada, voltada para a frente, com bastante céu e picos de montanha mais ou menos na altura da câmera. O Sobrevoo passou nessa base no primeiro take.
ReprovadoBase da cidade olhando para fora e para baixo, com a redação reforçada. Ainda assim, a câmera desceu.
AprovadoBase nivelada em altitude de cruzeiro. Primeiro take.
Se a mesma falha resistir a duas revisões do prompt, examine o que a imagem inicial está convidando o modelo a fazer antes de reescrever de novo.
As imagens-base viraram instrumentos de medição
No total, criamos 13 imagens-base. Elas não foram escolhidas principalmente para ficarem bonitas. Elas foram projetadas para revelar se o movimento da câmera estava correto.
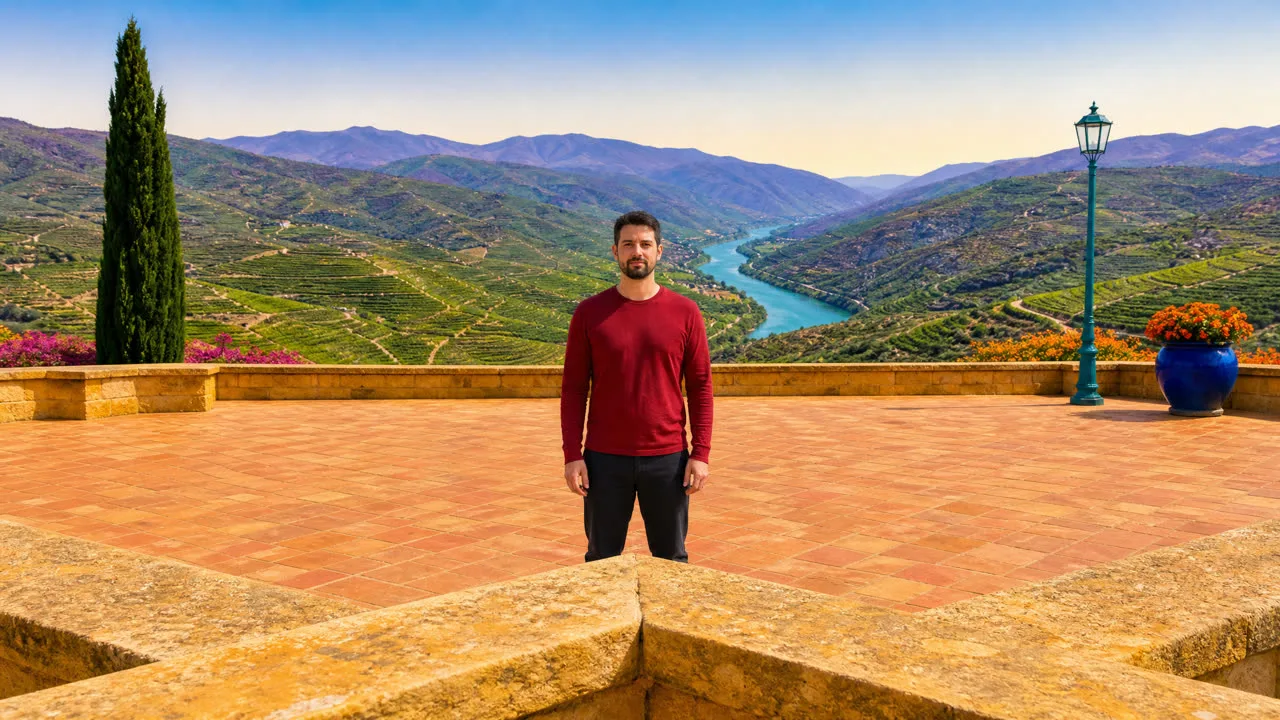
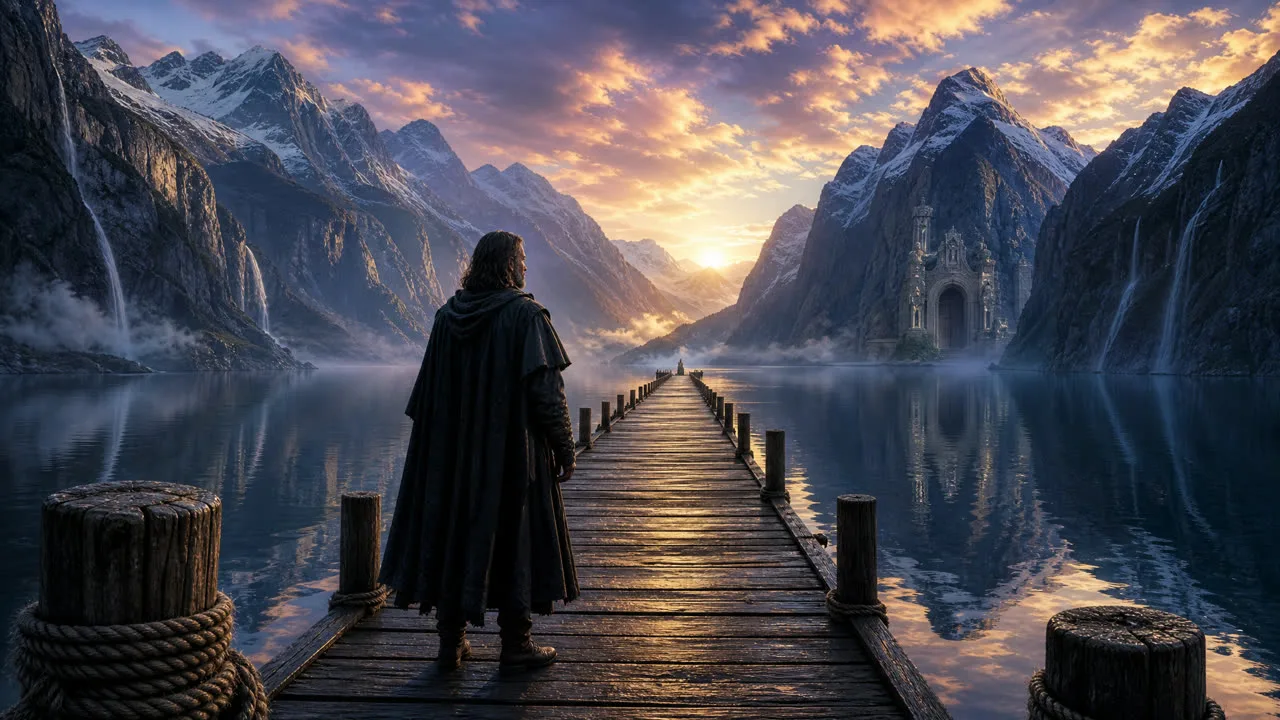
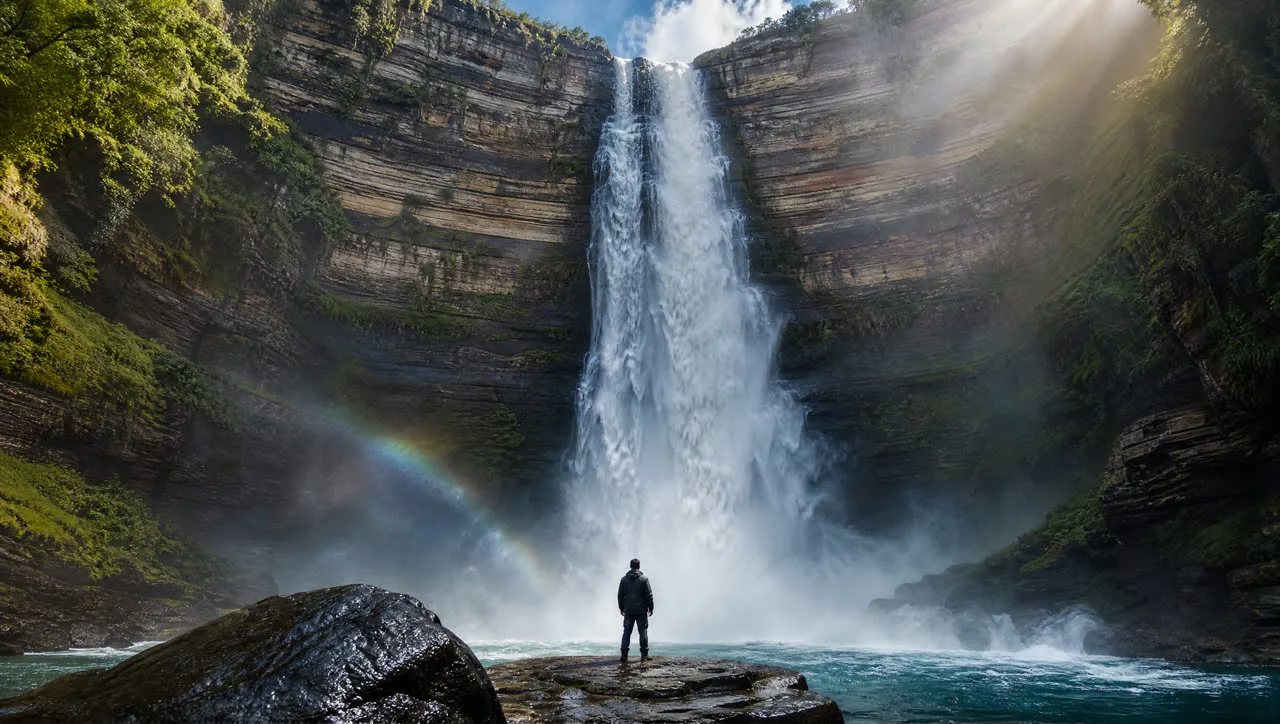
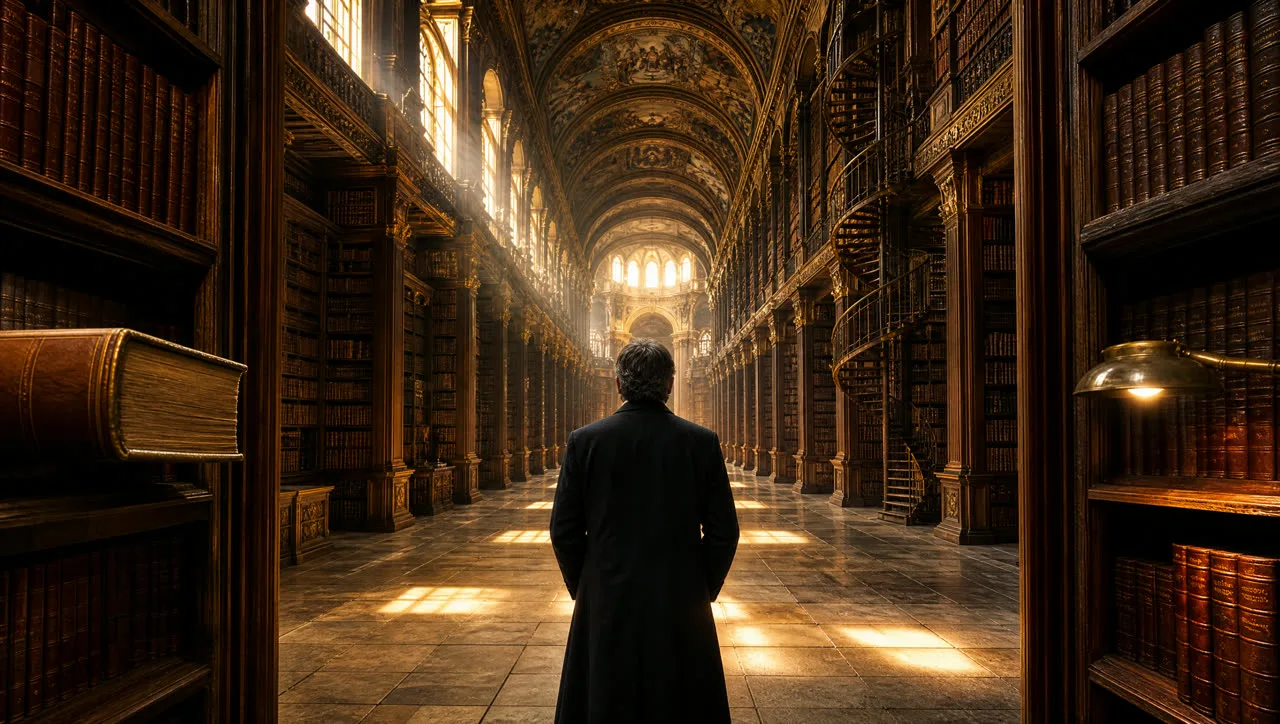
Uma boa imagem-base não apenas torna visível um movimento correto. Ela é projetada para que um movimento incorreto não tenha onde se esconder.
Por cima do ombro: três falhas em um take
A última opção que fechou o catálogo é um bom exemplo de por que um clipe não deve ser aprovado só porque impressiona à primeira vista. O primeiro take de Por cima do ombro teve três problemas separados:
- O modelo inventou um diálogo em uma língua estrangeira que ninguém tinha pedido.
- A câmera começou longe demais e fez uma aproximação, em vez de já estar enquadrada corretamente.
- O segundo personagem sorriu para a câmera, em vez de parecer naturalmente envolvido na conversa.
Cada problema foi corrigido separadamente: criamos uma base com uma linguagem corporal de conversa mais convincente, acrescentamos instruções explícitas de enquadramento estático e de não fazer aproximação, e especificamos silêncio, sem diálogo, desligando também o som na própria geração.
Um clipe pode parecer bom e, ainda assim, falhar de várias formas independentes ao mesmo tempo.
Nem toda opção é de fato um movimento de câmera
O estudo também expôs um problema de categoria. Match Cut Zoom, Velocity Edit, Toque na tela e Troca de câmera não são movimentos de câmera tradicionais. Eles estão mais perto de efeitos de edição ou de transição.
No Toque na tela, por exemplo, assim que descrevemos a ação física que dispara o efeito, o modelo renderizou essa ação. A redação bem-sucedida descrevia, em vez disso, o que acontece com o quadro como resultado da transição. Isso sugere que essas quatro opções talvez pertençam às transições, e não aos movimentos de câmera; veja o seletor Transição (Transition).
ReprovadoRedação com “finger tap”. Apareceu um dedo de verdade. Ative o som para ouvir o clique.
AprovadoRedação só sobre o quadro, em uma base sem nenhuma pessoa.
O que mudou depois que encontramos o método
Órbita e Arco foi onde pagamos o preço mais alto do aprendizado. 51 dos 147 vídeos foram gerados para apenas cinco opções dessa família, mais de dez takes por opção em média. Foi ali que aprendemos que os nomes profissionais, sozinhos, não eram confiáveis o bastante, onde quase inventamos um “viés para a esquerda” e onde nasceu o template geométrico.
As outras 59 opções levaram 91 takes no total, cerca de um take e meio por opção. A divisão não é perfeitamente cronológica, porque o Travelling e o Tilt também foram testados relativamente cedo, mas ainda assim mostra o quanto do aprendizado se concentrou na primeira família.
Nem tudo precisou ser reescrito: 14 opções passaram com a redação original do catálogo, sem mudanças. A essa altura, já tínhamos adotado outra regra de processo:
Antes de reescrever qualquer coisa, teste a redação genérica existente, sem mudanças, em uma imagem-base adequada.
A lição não é “prompts mais longos são melhores”. A lição é escrever só o que é necessário para definir o movimento de forma confiável.
As 13 regras que mantivemos
- Não use números para descrever ângulo, magnitude do movimento ou velocidade dentro do prompt de movimento. A duração do clipe é um parâmetro separado.
- Use uma única direção clara de deslocamento da câmera. Você pode descrever vários pontos de passagem ao longo do mesmo trajeto, mas não dê instruções de direção conflitantes.
- O sujeito pode ser uma âncora geométrica. Distância, tamanho do sujeito e enquadramento são referências válidas, mas o prompt de movimento não deve ditar a ação ou o comportamento do sujeito.
- Não nomeie conteúdos específicos da cena. A instrução deve continuar utilizável quando a imagem mudar.
- Use vocabulário que pertence ao movimento pretendido e proteja explicitamente os eixos que não devem mudar.
- Primeiro, defina de forma positiva o que a câmera deve fazer. Exclusões negativas são uma proteção adicional, não um substituto para a descrição do movimento desejado.
- Não descreva uma camada de profundidade como quase parada. Para comunicar profundidade, descreva uma diferença gradual de movimento entre os elementos próximos e os distantes.
- Câmera na mão, Steadicam, Vlog e Deriva precisam dizer se a câmera fica no lugar. Caso contrário, o tremor ou a oscilação podem virar um deslocamento indesejado.
- Se o movimento correto termina e depois volta, confira primeiro a duração do clipe. A exceção são movimentos como Câmera que respira e Push-pull, em que a volta faz parte do movimento.
- Quando duas opções compartilham a mesma geometria, diferencie-as pelo caráter ou por um teste visual difícil de falsificar.
- Para efeitos de edição, descreva o que acontece com o quadro, não a ação física que dispara o efeito.
- Sempre teste primeiro a redação existente. Se for necessário reescrever, mantenha a redação genérica, em vez de ajustá-la ao conteúdo da imagem de teste.
- Se a mesma falha resistir a duas revisões do prompt, pare de reescrever e examine o quadro inicial.
O nosso checklist para cada take
Quando revisamos um resultado, não perguntamos só se ele ficou bom. Conferimos cada um destes pontos separadamente:
- A direção está correta?
- A câmera está de fato se deslocando, ou só girando no lugar?
- A distância até o sujeito está mudando do jeito que o movimento exige?
- O modelo inventou um movimento de câmera extra ou renderizou equipamento de câmera dentro da tomada?
- Ele inventou um evento na cena, como algo caindo ou aparecendo de repente?
- O sujeito continua fazendo parte do mundo, ou se move como se estivesse preso à câmera?
- E mais um: o movimento termina cedo e depois começa a voltar quando não deveria?
Manter essas verificações separadas faz diferença. Por cima do ombro mostrou que um take pode falhar de três formas diferentes ao mesmo tempo.
O que isso mudou no produto
Todas as 64 opções testadas do seletor Movimento de câmera agora usam uma redação aprovada no laboratório. Catorze mantiveram a redação original, porque ela já funcionava. Um teste de regressão agora impede que a redação aprovada seja alterada por acidente.
O estudo também deixou algumas perguntas em aberto:
- A Aérea ainda não separa perfeitamente uma descida vertical de uma inclinação da vista para baixo.
- Boom para cima e Boom para baixo se sobrepõem bastante a Pedestal e Grua.
- As quatro opções do tipo edição talvez se encaixem melhor nas transições.
- A duração do clipe se mostrou uma parte importante do movimento, mas o seletor ainda não sugere uma duração para cada tipo.
O que aprendemos
No começo, estávamos tentando fazer o modelo entender melhor a linguagem da cinematografia. No fim, percebemos que o problema não era bem esse.
Termos como Dolly, Órbita ou Grua são atalhos que as pessoas usam para comprimir um conjunto inteiro de regras físicas em uma única palavra. O modelo nem sempre desempacota essa palavra do mesmo jeito que nós. À medida que passamos a depender menos do nome e a descrever a física de forma mais explícita, os resultados ficaram mais previsíveis. Descrevemos o que se move, o que permanece constante, como a profundidade muda, como os elementos próximos e distantes se movem uns em relação aos outros e onde a câmera deve terminar.
Então veio a segunda descoberta. Na geração de imagem para vídeo, o prompt não é a única instrução. O primeiro quadro também é uma instrução e, às vezes, é a mais forte.
Por isso, hoje, quando um movimento de câmera falha, não perguntamos mais só “O que há de errado com as palavras?”. Também perguntamos: “O que a imagem já tinha dito ao modelo antes mesmo de as palavras começarem?”
Em uma linhaQuanto melhor descrevemos a física, menos precisamos descrever o cinema.
Camera Motion Lab, notas de pesquisa, setembro de 2026. Cada clipe desta página é um take real do estudo: imagem para vídeo em 480p, mostrado ao lado do take que o substituiu.
Perguntas frequentes
Páginas relacionadas
Movimento de câmera
Gerar vídeo
Seedance 2.5
Como escolher um modelo
Última atualização