
 תיעוד Nodaro
תמלול
רכיב תמלול הופך דיבור באודיו או בסרטון לטקסט עם ElevenLabs STT או Whisper. מקבלים תזמון מילים לכתוביות, תוויות דוברים ותגים למוזיקה ולצחוק.
רכיב תמלול הופך דיבור לטקסט. מחברים אליו אודיו או סרטון, והרכיב מחזיר את התמלול פעמיים: כטקסט רגיל, וכתמלול בפורמט מובנה עם התזמון של כל מילה. אפשר לבחור בין שלושה מנועים, והם נבדלים בדבר אחד שחשוב לכתוביות: אם הם מחזירים תזמון לכל מילה.
מתי להשתמש
- לתמלל ראיון או פודקאסט כדי ליצור מהם תוכן כתוב.
- ליצור כתוביות מהסאונד של סרטון, בעזרת רכיב הוספת כתוביות.
- להפוך הקלטות קוליות והקלטות של פגישות לטקסט.
- להפוך ספריית אודיו לטקסט שאפשר לחפש בו.
- להזין תמלול לרכיב טקסט כדי לסכם או לנתח אותו.
- לתת לרכיב תוכנית עריכה את התמלול המתוזמן שהוא צריך כדי לתכנן עריכה.
התחלה מהירה
הוספת הרכיב
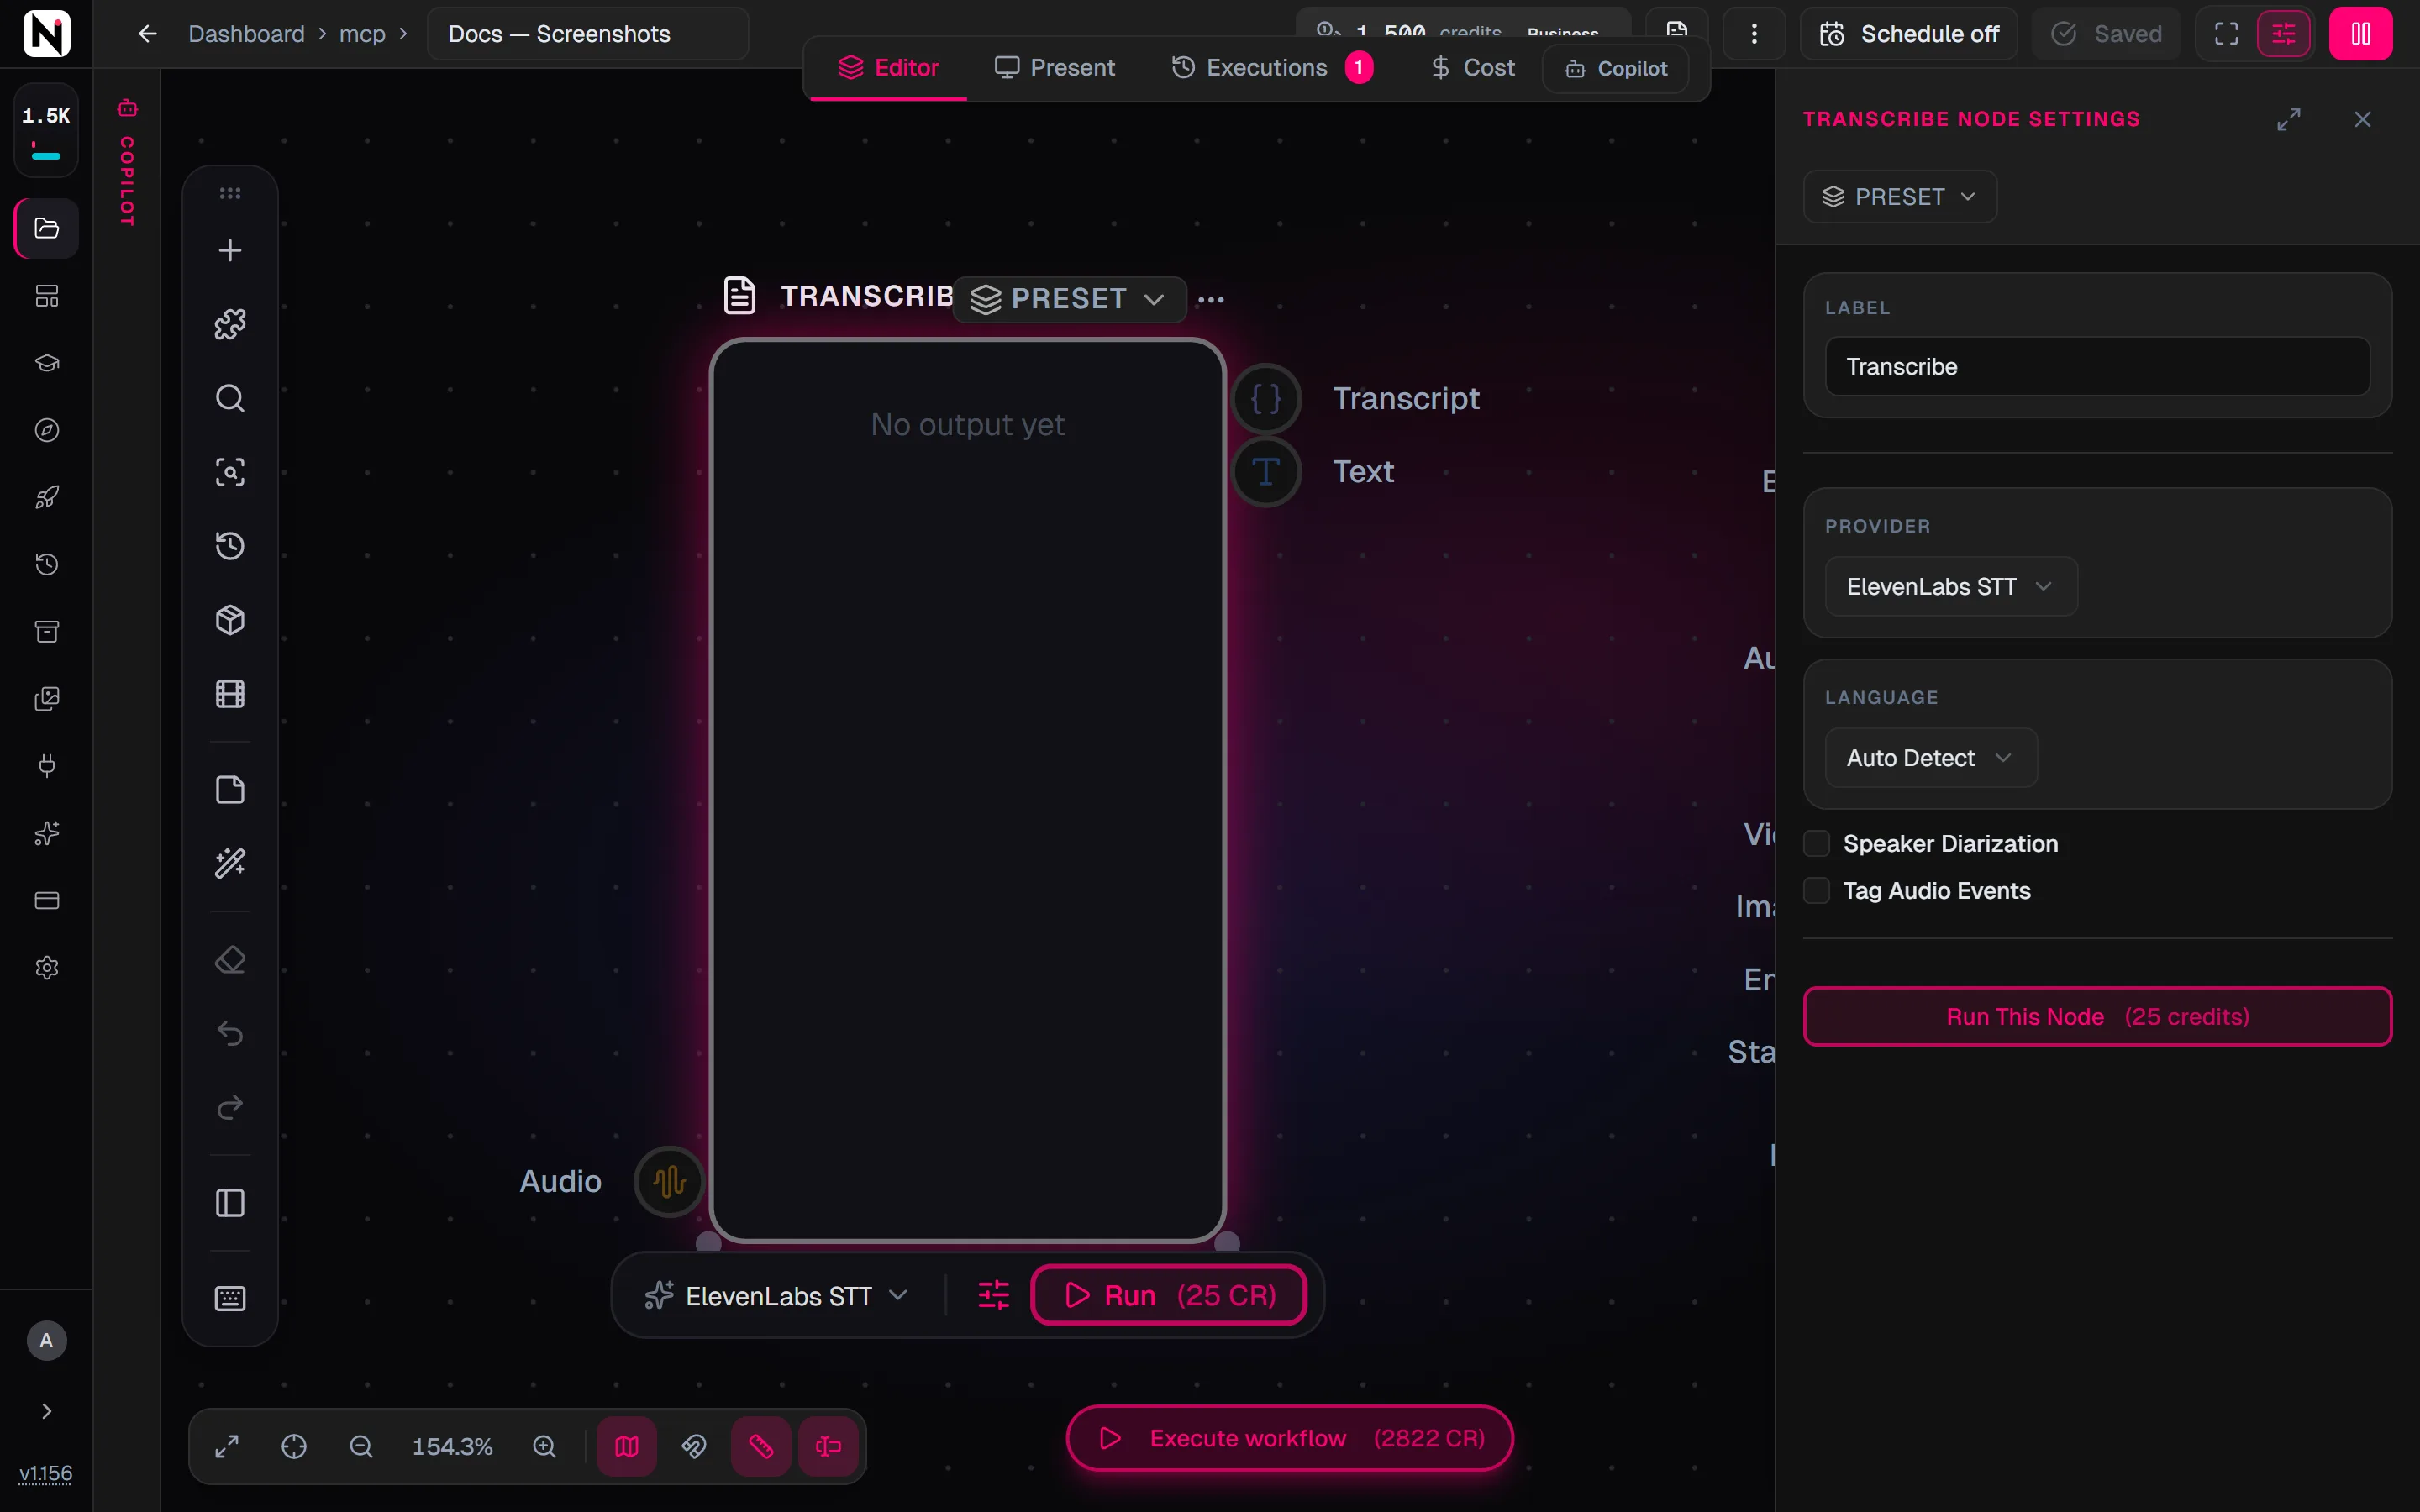
הקישו Tab על הקנבס ובחרו אודיו › תמלול › תמלול.
חיבור ההקלטה
חברו רכיב אודיו או רכיב וידאו לקלט אודיו.
בחירת המנוע והשפה
פתחו את חלונית ההגדרות. השאירו את ההגדרה ספק על ElevenLabs STT, אלא אם אתם צריכים מנוע אחר. השאירו את ההגדרה שפה על זיהוי אוטומטי, או בחרו את השפה.
הרצה
לחצו על הרצה ברכיב. התמלול הרגיל מופיע בפלט טקסט, והתמלול המתוזמן בפלט תמלול.
קלט ופלטים
| קלט | מקבל | מה הוא עושה |
|---|---|---|
| אודיו | רכיבי אודיו ווידאו | הדיבור לתמלול. בסרטון, הרכיב משתמש ברצועת האודיו שלו. |
כדי לתמלל סרטון מקישור לדף שבו הוא נמצא, חברו רכיב כתובת וידאו. רכיב כתובת וידאו מבקש את הצהרת זכויות התוכן ומוריד את רצועת האודיו, ורכיב תמלול מתמלל את הרצועה הזו. קישור לדף של סרטון שמגיע לרכיב תמלול בדרך אחרת עוצר הרצה בעורך, וההודעה מציינת זאת.
| פלט | מה הוא מעביר |
|---|---|
| טקסט | התמלול כולו כטקסט רגיל. אפשר לחבר אותו לכל רכיב שמקבל טקסט. |
| תמלול | התמלול בפורמט מובנה, עם תזמונים של מילים ומקטעים באלפיות שנייה. הפלט הזה מזין את רכיב הוספת כתוביות ואת רכיבי העריכה. |
בפרומפט, כתיבת התווית של הרכיב בסוגריים מסולסלים, כגון {Transcribe}, מכניסה את הטקסט הרגיל.
הגדרות
| הגדרה | מה היא עושה |
|---|---|
| ספק | המנוע: ElevenLabs STT (ברירת המחדל), Whisper — ללא תזמון מילים או Incredibly Fast Whisper. |
| שפה | זיהוי אוטומטי (ברירת המחדל), או אחת מ-20 שפות, כגון אנגלית, ספרדית, עברית, יפנית וערבית. |
| זיהוי דוברים | מציינת מי אמר מה. התיבה לא מסומנת כברירת מחדל. מוצגת רק כשבהגדרה ספק נבחר ElevenLabs STT. |
| תיוג אירועי אודיו | מתייגת בתמלול צלילים שהם לא דיבור, כגון [music] (מוזיקה) או [laughter] (צחוק). התיבה לא מסומנת כברירת מחדל. מוצגת רק כשבהגדרה ספק נבחר ElevenLabs STT. |
תיבות הסימון זיהוי דוברים ותיוג אירועי אודיו לא תלויות זו בזו: אפשר לסמן אחת מהן, את שתיהן או אף אחת.
מודלים
| מודל | יצרן | מצבים | קרדיטים | פרטים |
|---|---|---|---|---|
| ElevenLabs STT | ElevenLabs | דיבור לטקסט | 25 | דיבור לטקסט עם חותמות זמן ברמת המילה (מופעלות תמיד), זיהוי דוברים ותגיות לאירועי אודיו. המנוע שכדאי להשתמש בו כשהתמלול מזין כתוביות. |
| Incredibly Fast Whisper | OpenAI | דיבור לטקסט | 44 | דיבור לטקסט מהיר עם Whisper. מחזיר חותמות זמן ברמת המילה כשמבקשים, ולכן התמלול שלו יכול להזין כתוביות. |
| Whisper | OpenAI | דיבור לטקסט | 44 | דיבור לטקסט עם Whisper — מקטעים ברמת המשפט בלבד, בלי חותמות זמן למילים. מתאים לתמלול או לכתובית סטטית; לא לכתוביות קינטיות שמתוזמנות מילה־מילה. |
תזמון מילים: איזה מנוע מחזיר אותו
| מנוע | תזמון מילים | הערות |
|---|---|---|
| ElevenLabs STT (ברירת המחדל) | תמיד | עובד ברמת המילה מעצם התכנון. המנוע המתאים לכתוביות, לתוויות דוברים ולאירועי אודיו. |
| Incredibly Fast Whisper | כשצריך | הרכיב מבקש תזמון לכל מילה באופן אוטומטי כשהפלט תמלול מחובר. |
| Whisper | אף פעם | מקטעים ברמת המשפט בלבד. מספיק לתמלול פשוט או לכתובית סטטית. |
אם ElevenLabs STT או Incredibly Fast Whisper לא מחזירים תזמון לכל מילה לאודיו שברור שיש בו דיבור, ההרצה נכשלת והקרדיטים מוחזרים. הרצה על אודיו שאין בו דיבור בכלל מצליחה בכל זאת, בלי מילים, למשל קליפ שהתמלול שלו הוא [music] (מוזיקה).
התמלול בפורמט המובנה
הפלט תמלול נראה כך:
{
  "version": 1,
  "language": "en",
  "words": [
    { "text": "Welcome", "startMs": 0, "endMs": 420 },
    { "text": "back", "startMs": 460, "endMs": 700 }
  ],
  "segments": [
    { "startMs": 0, "endMs": 700, "text": "Welcome back" }
  ]
}- כל הזמנים הם מספרים שלמים של אלפיות שנייה.
- השדה
wordsכולל כל מילה עם ההתחלה והסוף שלה. השדה מתמלא בכל פעם שהמנוע מחזיר תזמון לכל מילה. - השדה
segmentsכולל יחידות גדולות יותר, משפטים או חלקי משפטים, כשהמנוע מספק אותן. - בהרצה עם זיהוי דוברים, לכל מילה ולכל מקטע יש גם
speaker. למילה יכול להיות גםconfidence.
בפלט טקסט, התיבה זיהוי דוברים מוסיפה תוויות כגון Speaker 1: (דובר 1:) לפני כל מקטע, והתיבה תיוג אירועי אודיו מוסיפה תגים כגון [music] (מוזיקה) ו-[laughter] (צחוק) במקום שבו הצלילים נשמעים.
יצירת כתוביות מתמלול
חברו את הפלט תמלול לקלט התמלול של רכיב הוספת כתוביות. רכיב הוספת כתוביות יוצר אז כתוביות שמתוזמנות לכל מילה. לשם כך, השתמשו ב-ElevenLabs STT או ב-Incredibly Fast Whisper.
תמלול של Whisper לא יכול לשמש לכתוביות. כשרכיב תמלול שעובד עם Whisper מזין רכיב הוספת כתוביות, ההרצה נדחית עוד לפני שמשהו רץ ולפני כל חיוב, עם ההודעה הזו:
Captions need word timings, but the "whisper" engine does not return word timings — pick incredibly-fast-whisper or elevenlabs-stt.- הבדיקה מכסה גם שרשרת שעוברת דרך רכיב החלת רשימת עריכה, ושרשראות בתוך תת־תהליך בכל עומק.
- חלונית ההגדרות מציגה את אותה אזהרה ליד ההגדרה ספק ברגע שהחיבור קיים, כך שאפשר לתקן את הבעיה לפני ההרצה.
- הרצה של רכיב תמלול לבדו אף פעם לא נחסמת. אין שום בעיה עם תמלול של Whisper שמגיע לכל מקום אחר.
- מקרה אחד אי אפשר לבדוק מראש: שרשרת שבה רכיב תמלול ורכיב הוספת כתוביות נמצאים משני צדי הגבול של תת־תהליך. הרצה כזו נכשלת ברכיב הוספת כתוביות, אחרי שהתמלול כבר רץ והקרדיטים עליו נגבו.
קרדיטים
רכיב תמלול גובה מחיר קבוע לכל הרצה, בלי קשר לאורך האודיו:
| מנוע | קרדיטים להרצה |
|---|---|
| ElevenLabs STT | 25 |
| Incredibly Fast Whisper | 44 |
| Whisper | 44 |
על בקשה שנדחית לפני שהיא מתחילה, כגון תמלול של Whisper שמחובר לרכיב הוספת כתוביות, אין חיוב.
בהתקנה באירוח עצמי
כל מנוע רץ עם מפתח הספק שלכם. כשאין מפתח למנוע שנבחר ולהתקנה יש חיבור ל-Nodaro Cloud, התמלול רץ דרך החיבור. כשאין אף אחד מהם, הרכיב נכשל עם הודעה שמציינת איזה מפתח להוסיף. ראו את הדף מפתחות ספק.
טיפים
- השאירו את השפה על זיהוי אוטומטי. בחרו שפה רק כשאתם יודעים מהי, למשל כששתי שפות נשמעות דומות.
- סמנו דוברים בשיחות. בראיונות, בפגישות ובפודקאסטים, סמנו את התיבה זיהוי דוברים.
- תייגו אירועים כשהם חשובים. סמנו את התיבה תיוג אירועי אודיו כשצלילי הרקע עוזרים להבין את ההקלטה.
- נקו קודם אודיו רועש. העבירו את ההקלטה דרך רכיב מחלץ קול לפני רכיב תמלול.
- פצלו אודיו ארוך מאוד. קטעים קצרים יותר מתומללים באמינות רבה יותר. רכיב פיצול למקטעים חותך קובץ ארוך לחלקים שהאורך שלהם בין מינימום למקסימום, ורכיב תמלול רץ פעם אחת על כל חלק.
- יישרו במקום זאת תסריט משלכם. כשהתסריט המדויק כבר בידיכם, רכיב יישור מאולץ מתזמן כל מילה שלו לפי האודיו.
דרך ה-API
הנתיב POST /v1/transcribe מקבל את audioUrl, ואת הפרמטרים האופציונליים provider (elevenlabs-stt, incredibly-fast-whisper או whisper), language, diarize, tagAudioEvents ו-wordTimestamps.
-
קישור לדף של סרטון. ערך של
audioUrlשמקשר לדף של סרטון ברשת חברתית הוא ייבוא של הקישור הזה: Nodaro מוריד קודם את הסאונד שלו. שלחו את ה-confirmationIdשקיבלתם מ-POST /v1/content-rights/confirmלקישור הזה. בלי מזהה כזה, פריסה שדורשת אישור דוחה את הבקשה עם403עוד לפני שהמשימה נוצרת. מפתח או סוכן שלחשבון שלהם יש הרשאה קבועה לא צריכים מזהה כזה, וגם קישור ישיר לקובץ לא צריך. ראו את דף ה-API זכויות תוכן. -
ציינו את המנוע. בקשה בלי
providerרצה על Whisper, כך שמי שכבר קורא לנתיב ממשיך לקבל את אותו מנוע. הגדירו אתproviderבכל פעם שאתם צריכים תזמון לכל מילה,diarizeאוtagAudioEvents. -
תזמון מילים. המנוע
incredibly-fast-whisperמחזיר מילים רק עםwordTimestamps: true. בקשה עםwordTimestamps: trueעלwhisperנדחית עם400 validation_errorלפני שהמשימה נוצרת, ולכן אין חיוב. המנוע אף פעם לא מוחלף בשקט. -
כתוביות. השדה
output_data.wordsשל המשימה שהסתיימה כבר בנוי במבנה של כתוביות (text,startMs,endMs). העבירו אותו ל-POST /v1/add-captionsבתורcaptions, ורכיב הוספת כתוביות לא יתמלל שוב. -
מחיר. הנתיב
GET /v1/credits/model-cost?model=<engine>מחזיר את המחיר המדויק לחשבון שלכם.
המתודה ב-SDK היא client.audio.transcribe, והפקודה ב-CLI היא nodaro audio transcribe --provider <engine>. כלי ה-MCP transcribe תמיד מריץ את ElevenLabs STT, ולכן בתוצאה שלו תמיד יש תזמון לכל מילה. ראו את דף ה-API קול ומדיה.
שאלות נפוצות
איזה מנוע תמלול לבחור?
ברכיב תמלול, השאירו את ElevenLabs STT, ברירת המחדל. המנוע הזה תמיד מחזיר תזמון לכל מילה, יכול לסמן דוברים ולתייג אירועי אודיו, והוא הזול ביותר. גם Incredibly Fast Whisper מחזיר תזמון לכל מילה כשרכיב אחר צריך אותו. Whisper מחזיר משפטים בלבד, וזה מספיק לתמלול פשוט.
למה התהליך שלי עם רכיב תמלול ורכיב הוספת כתוביות נדחה?
רכיב תמלול שבתהליך משתמש ב-Whisper, שלא מחזיר תזמון לכל מילה, וכתוביות צריכות אותו. בחרו בהגדרה ספק את ElevenLabs STT או את Incredibly Fast Whisper, והריצו את התהליך שוב. ההרצה נדחית לפני שהיא מתחילה, ולכן אין שום חיוב.
כמה קרדיטים עולה רכיב תמלול?
רכיב תמלול גובה מחיר קבוע לכל הרצה, בלי קשר לאורך האודיו. ElevenLabs STT עולה 25 קרדיטים, Incredibly Fast Whisper עולה 44 קרדיטים ו-Whisper עולה 44 קרדיטים.
האם רכיב תמלול יודע להבחין בין דוברים?
כן, עם ElevenLabs STT. כשמסמנים את התיבה זיהוי דוברים, בפלט הטקסט מופיעה לפני כל מקטע תווית עם הדובר שלו, כגון "Speaker 1:" (דובר 1:). גם כל מילה בתמלול בפורמט המובנה כוללת את הדובר שלה.
האם אפשר לתמלל סרטון?
כן. כשמחברים את הסרטון לקלט אודיו של רכיב תמלול, הרכיב מתמלל את רצועת האודיו שלו.
דפים קשורים
הוספת כתוביות
יישור מאולץ
תוכנית עריכה
מחלץ קול
ElevenLabs STT
עודכן לאחרונה