
 תיעוד Nodaro
טקסט לדיבור
הפכו טקסט לדיבור טבעי עם ElevenLabs v4, v4 Turbo, v3, Turbo v2.5 או Multilingual v2. בחרו קול והוסיפו רגש עם תגי אודיו, ב-46 שפות.
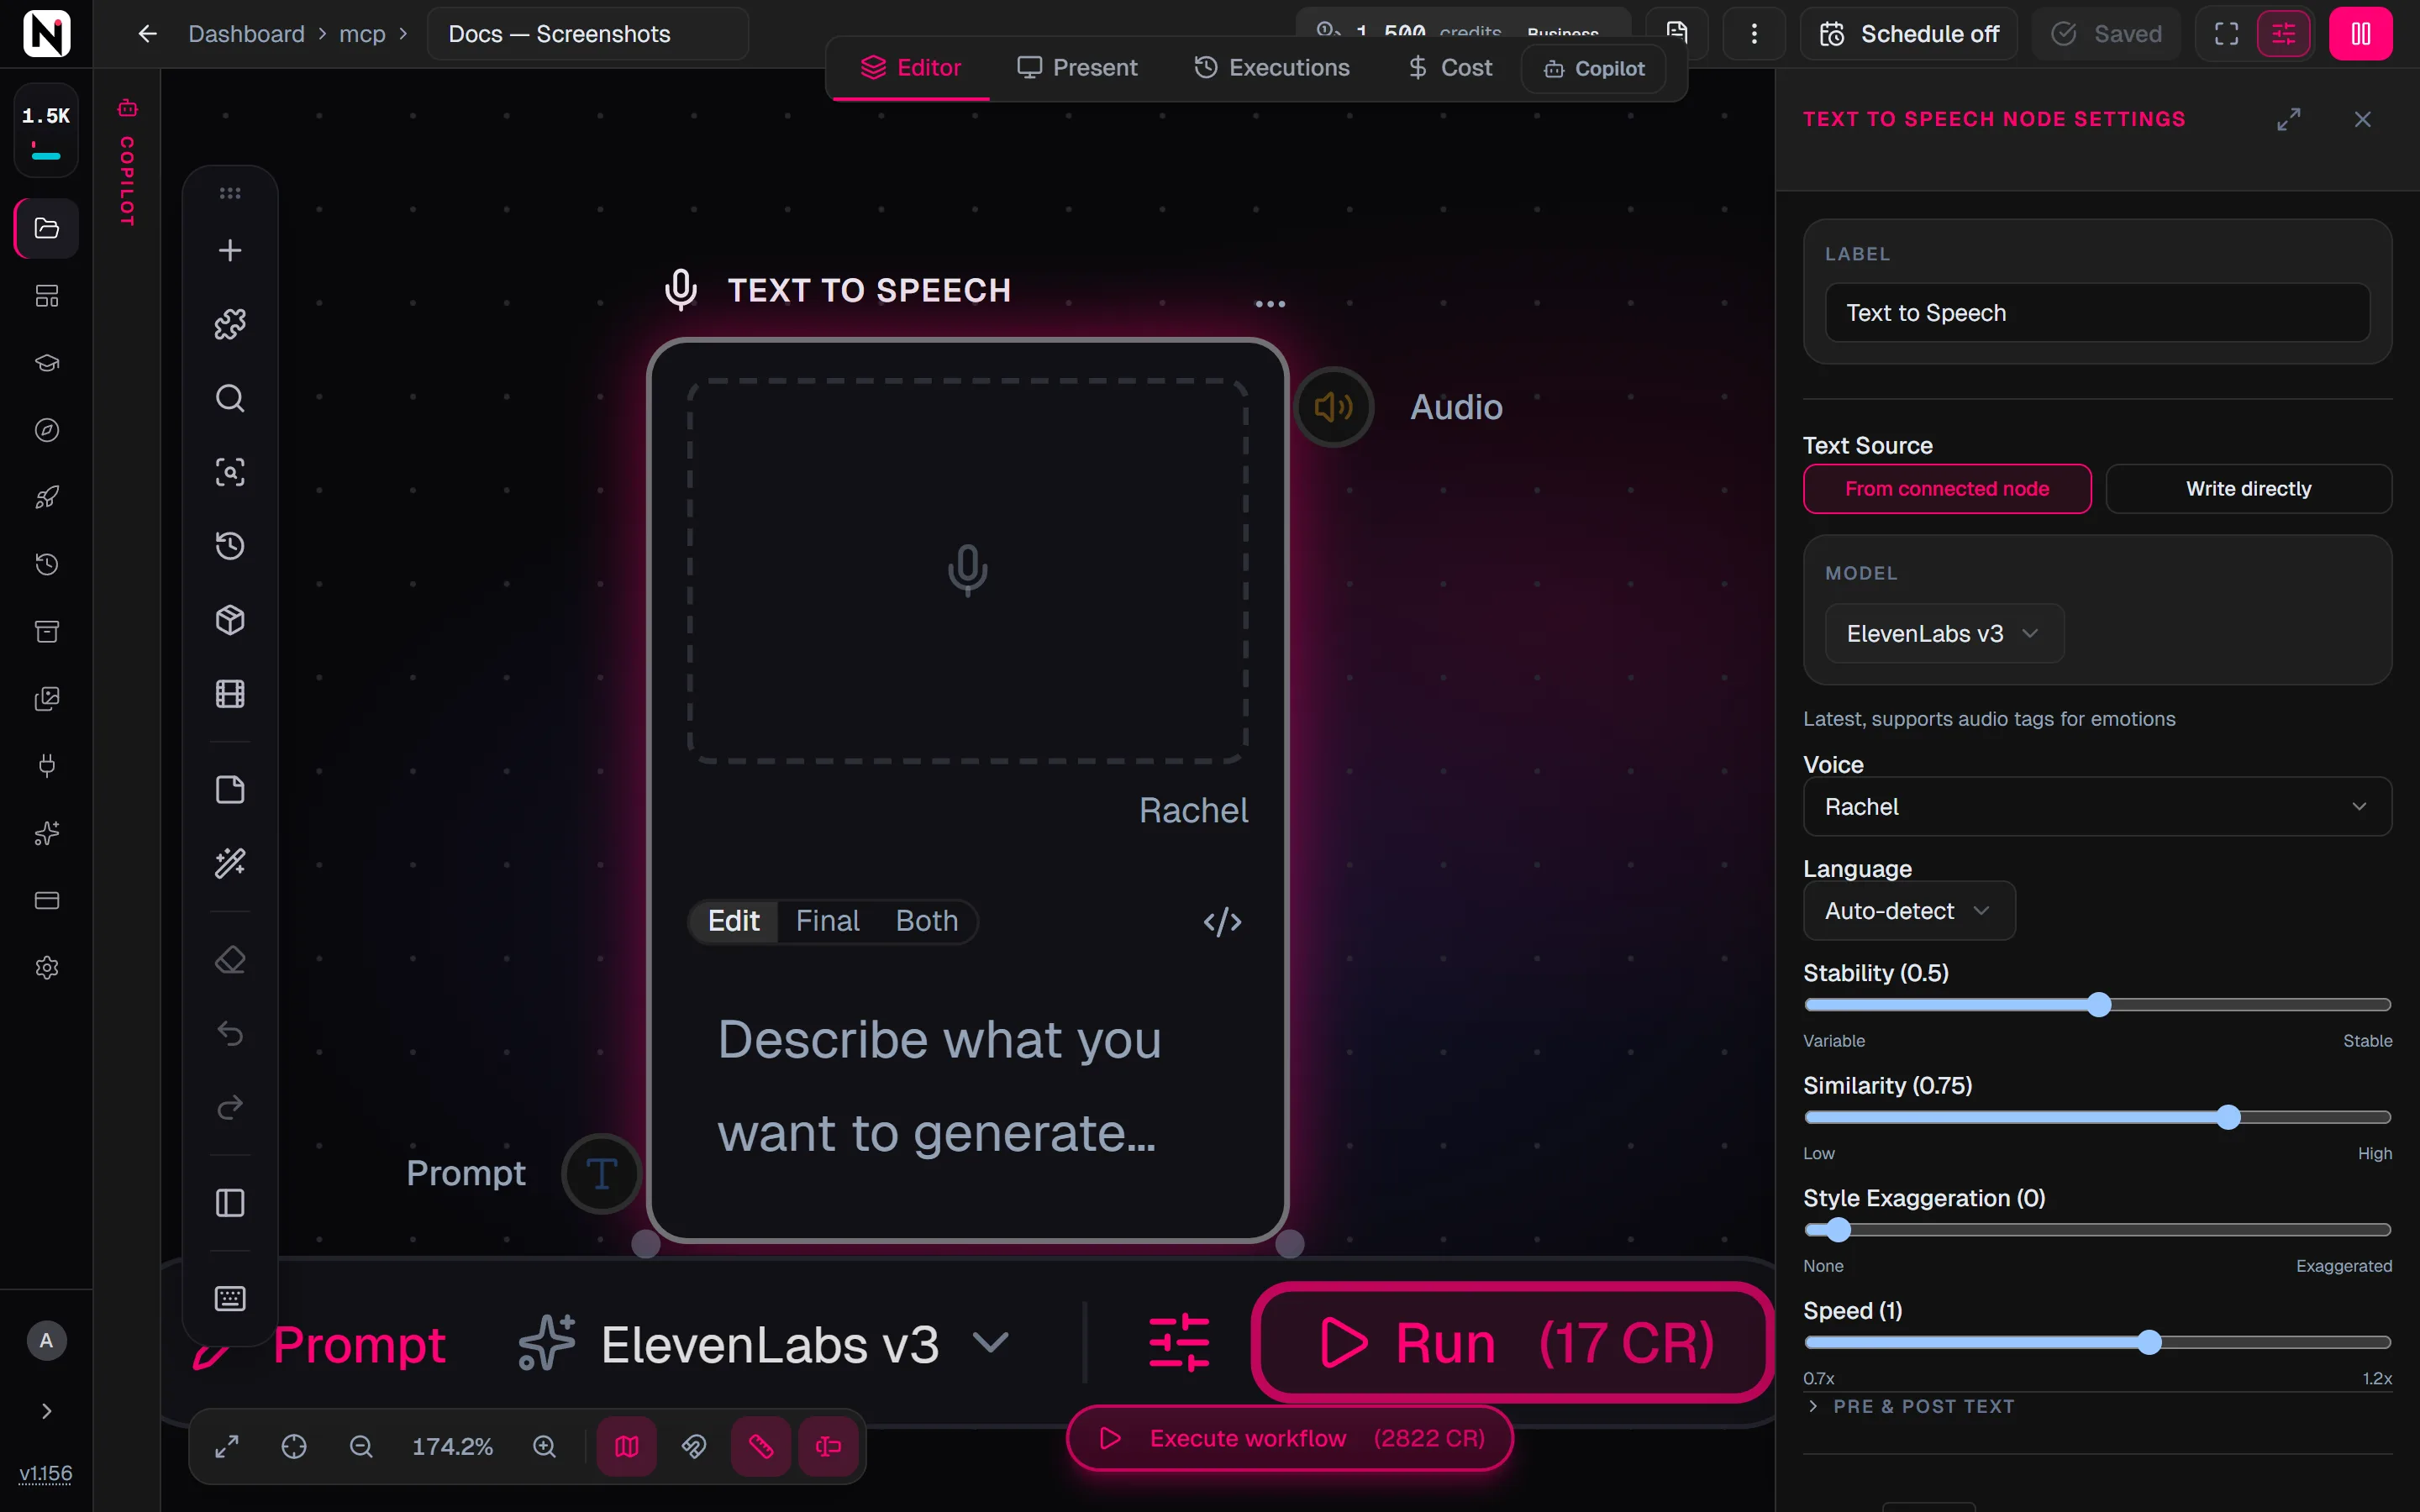
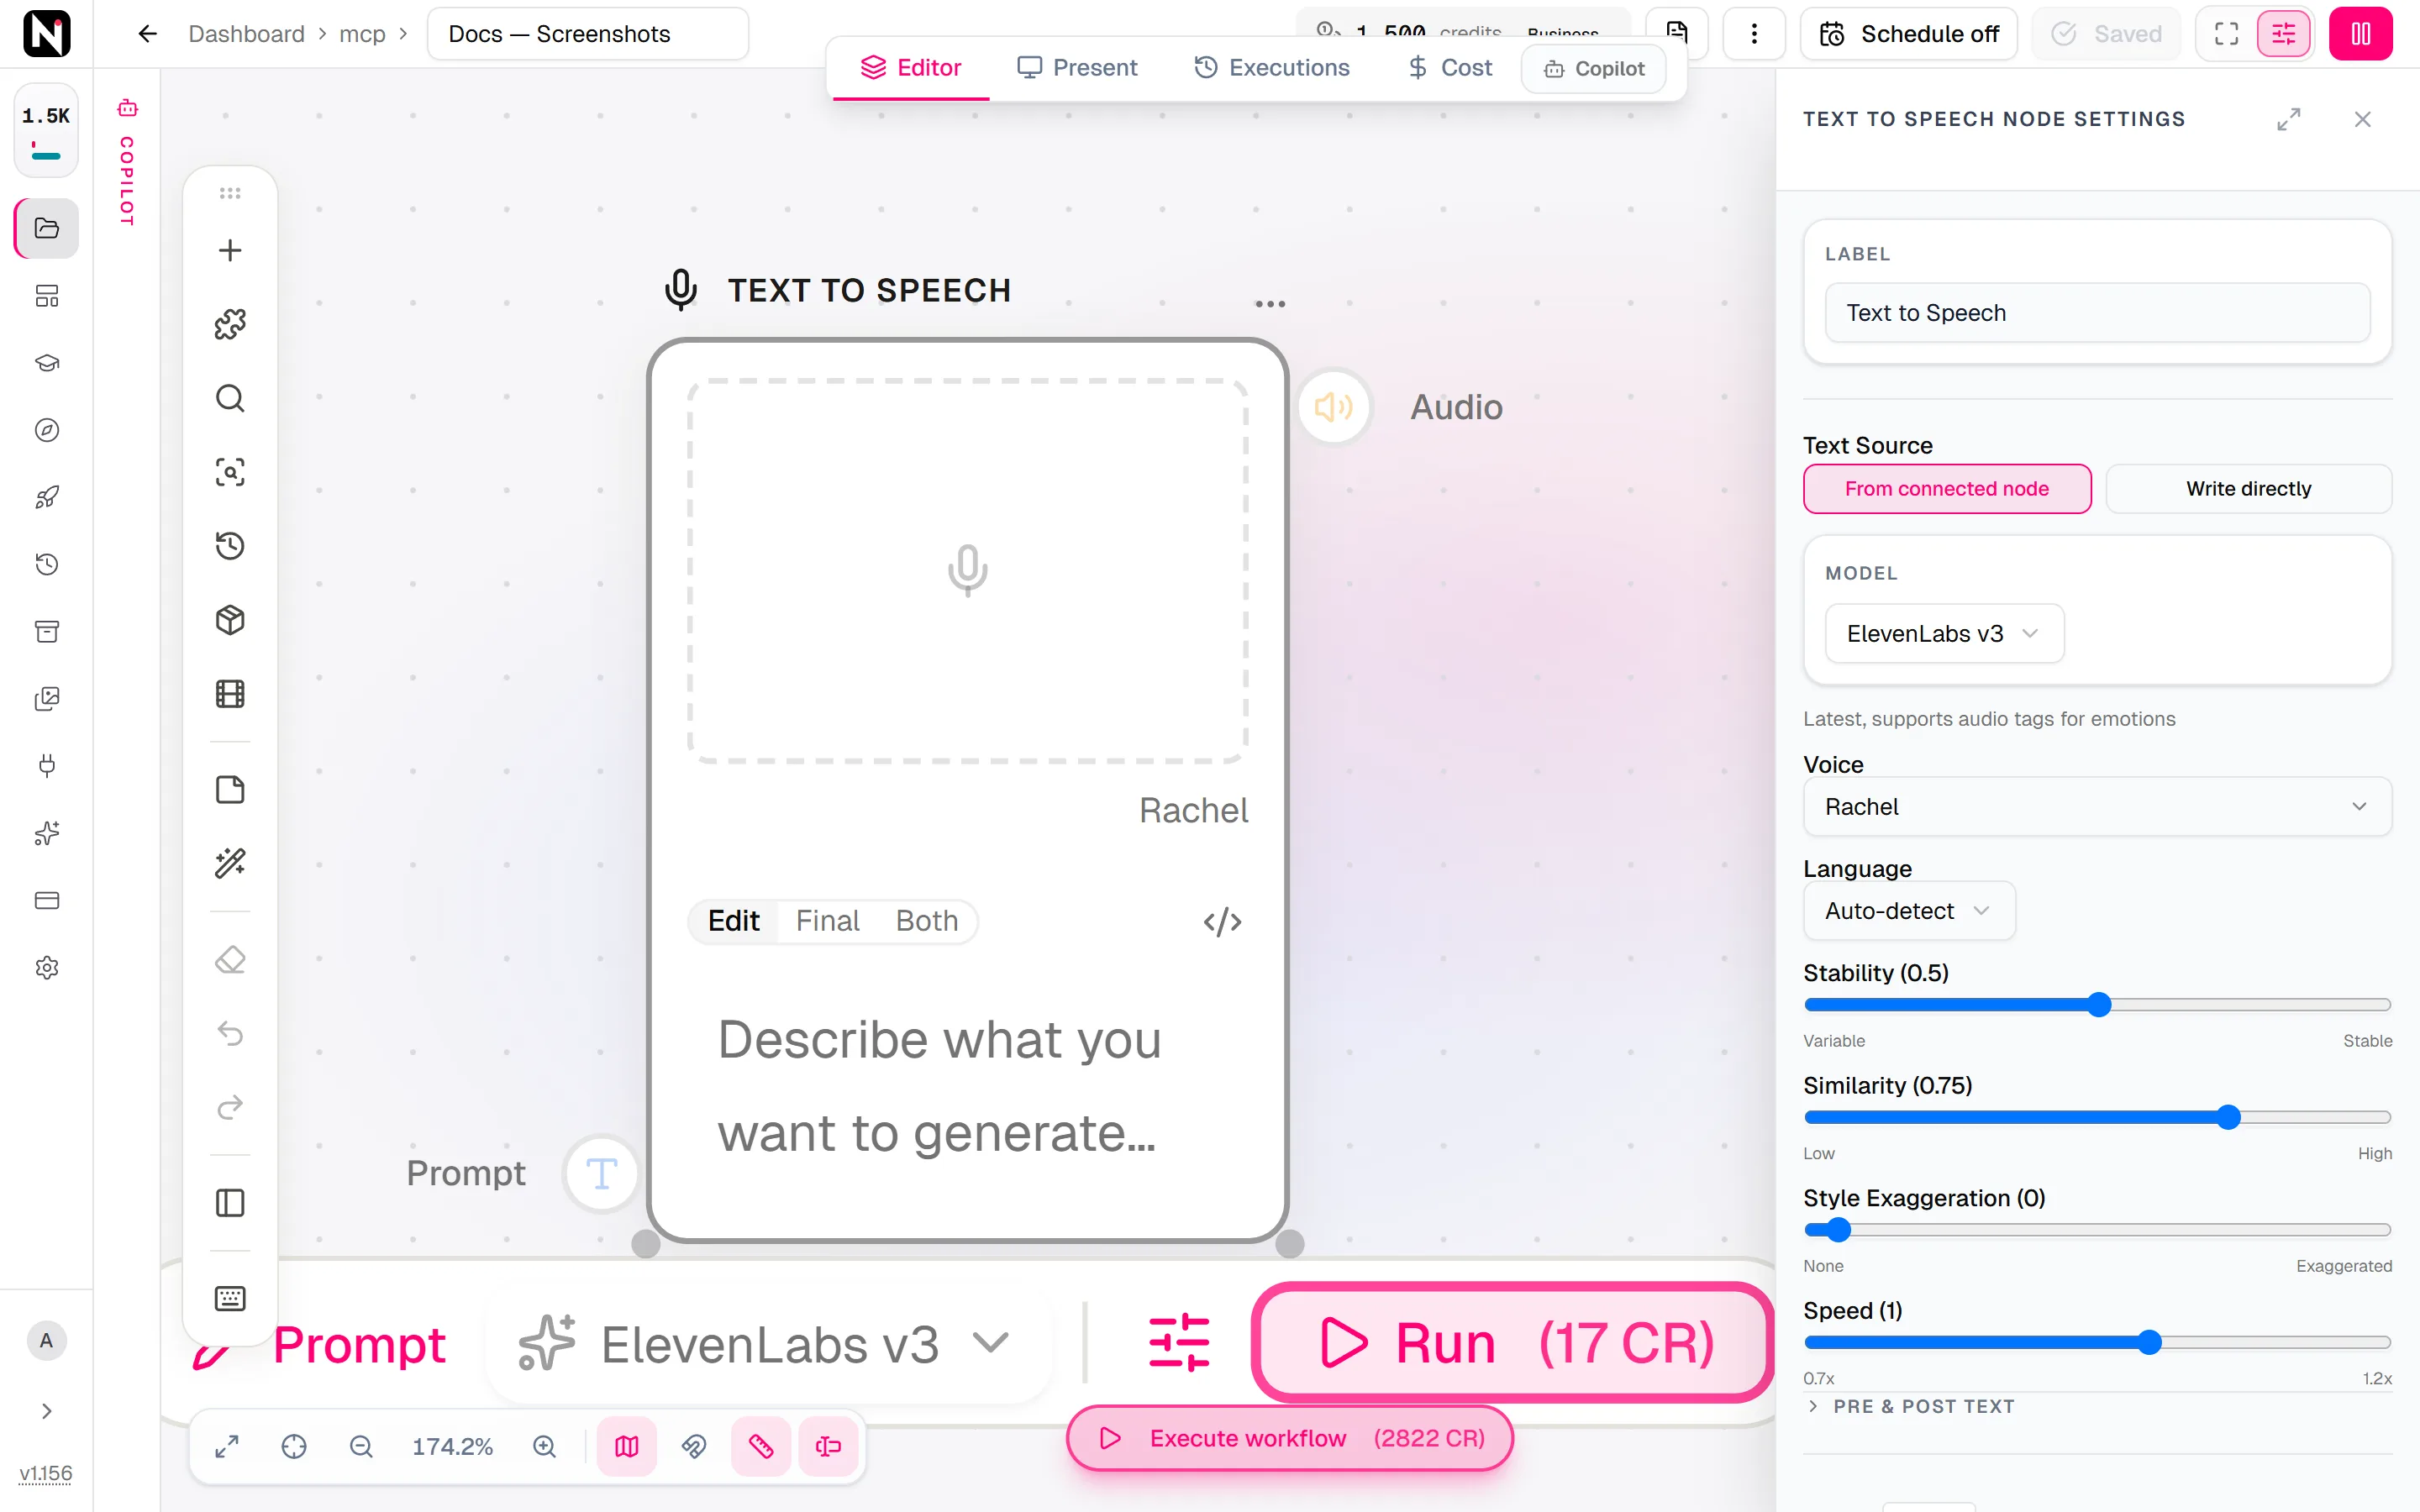
רכיב טקסט לדיבור הופך טקסט לאודיו מדובר בעזרת מודלי הקול של ElevenLabs. כותבים את הטקסט או מחברים אותו, ובוחרים קול ומודל. הרכיב מחזיר קובץ אודיו שאפשר להוסיף לסרטון, להשתמש בו לסנכרון שפתיים של דמות או לשלב במיקס עם מוזיקה. מודל ברירת המחדל, ElevenLabs v4, מדבר 46 שפות ומבין תגי אודיו כגון [laughs] (צוחק) ו-[whispers] (לוחש).
מתי להשתמש
- אתם צריכים קריינות לסרטון, לסרטון הסבר או לפרסומת.
- אתם רוצים שדמות תגיד שורה, למשל לפני שרכיב סנכרון שפתיים מנפיש פורטרט.
- אתם רוצים אודיו בסגנון פודקאסט מתסריט כתוב.
- אתם רוצים את אותו תסריט בכמה שפות.
- אתם רוצים הגשה אקספרסיבית עם רגשות, תגובות והפסקות, שכתובים ישירות בתוך הטקסט.
לשיחה בין כמה קולות בקובץ אחד, השתמשו במקום זאת ברכיב טקסט לדיאלוג.
התחלה מהירה
הוספת הרכיב
הקישו Tab על הקנבס ובחרו אודיו › דיבור וקריינות › טקסט לדיבור.
הזנת הטקסט
חברו רכיב טקסט, רכיב יצירת טקסט - כל LLM או רכיב יצירת תסריט לקלט פרומפט. כדי להקליד את הטקסט ברכיב עצמו, פתחו את חלונית ההגדרות ובחרו בהגדרה מקור הטקסט את האפשרות כתיבה ישירה.
בחירת הקול והמודל
תחת קול, פתחו את חלון בחירת הקולות, האזינו לכמה דוגמאות ובחרו קול. תחת מודל, השאירו את ElevenLabs v4, אלא אם אתם צריכים טקסט ארוך יותר או מחיר נמוך יותר.
הרצה
לחצו על הרצה ברכיב. הדיבור מופיע על הרכיב עם נגן, וכל התוצאות הקודמות נשארות ברצועת התוצאות שלו.
קלטים
| קלט | מקבל | מה הוא עושה |
|---|---|---|
| פרומפט | רכיבי טקסט, כגון הרכיבים טקסט, יצירת טקסט - כל LLM, יצירת תסריט ושילוב טקסט | הטקסט להקראה, כשבהגדרה מקור הטקסט נבחרה האפשרות מרכיב מחובר. |
גם השדות טקסט קודם וטקסט הבא יכולים לקבל טקסט מרכיב אחר, דרך מיפוי שדות. ראו את הסעיף רציפות בין קליפים.
הפלט, אודיו, הוא כתובת ה-URL של האודיו המדובר. הפלט יכול להזין מספר בלתי מוגבל של רכיבים בבת אחת.
הגדרות
| הגדרה | מה היא עושה |
|---|---|
| מקור הטקסט | באפשרות מרכיב מחובר (ברירת המחדל), הרכיב מקריא את הטקסט שמחובר לקלט פרומפט. באפשרות כתיבה ישירה, הוא מקריא את הטקסט שאתם מקלידים בשדה טקסט. |
| טקסט | הטקסט להקראה, כשבהגדרה מקור הטקסט נבחרה האפשרות כתיבה ישירה. כדי להוסיף תג אודיו, הקלידו [ או /. אפשר להכניס את הערך של רכיב אחר אם כותבים את התווית שלו בסוגריים מסולסלים, כגון {Script}. |
| מודל | ElevenLabs v4 (ברירת המחדל), ElevenLabs v4 Turbo, ElevenLabs v3, ElevenLabs Turbo v2.5 או ElevenLabs Multilingual v2. |
| קול | הקול שמדבר. ההגדרה פותחת את חלון בחירת הקולות. ברירת המחדל היא Rachel. |
| שפה | זיהוי אוטומטי (ברירת המחדל), או שפה אחת מהרשימה של המודל. |
| יציבות | מ-0 עד 1. ערכים נמוכים נותנים הקראה אקספרסיבית ומגוונת יותר; ערכים גבוהים נותנים הקראה אחידה יותר. |
| דמיון | מ-0 עד 1. עד כמה התוצאה תואמת לגוון של הקול. ב-ElevenLabs v4, ב-v4 Turbo, ב-Turbo v2.5 וב-Multilingual v2 בלבד. |
| הדגשת סגנון | מ-0 עד 1. מחזקת את הסגנון של הקול המקורי. ב-Turbo v2.5 וב-Multilingual v2 בלבד. |
| מהירות | מ-0.7x עד 1.2x. ב-Turbo v2.5 וב-Multilingual v2 בלבד. |
| טקסט קודם | תחת רציפות. השורה שנאמרת ממש לפני הקליפ הזה. המודל מתייחס אליה כהקשר ולא מקריא אותה. עד 1,000 תווים. |
| טקסט הבא | תחת רציפות. השורה שנאמרת מיד אחרי הקליפ הזה. עד 1,000 תווים. |
| טקסט לפני ואחרי | טקסט שמתווסף תמיד לפני הטקסט להקראה ואחריו. הטקסט הזה מוסתר מאנשים שמשתמשים בתהליך שלכם כאפליקציה. ראו את הדף טקסט לפני ואחרי הפרומפט. |
החלונית מציגה רק את ההגדרות שהמודל שנבחר משתמש בהן. ב-ElevenLabs v3 מופיעה רק ההגדרה יציבות. ב-ElevenLabs v4 וב-v4 Turbo מופיעות ההגדרות יציבות ודמיון. במודלי v2 מופיעים כל ארבעת המחוונים. כשבוחרים מודל אחר, ההגדרות שהמודל החדש לא משתמש בהן מתאפסות, ושפה שהוא לא מציע חוזרת לאפשרות זיהוי אוטומטי.
הגדרות הקול תואמות לדוגמה של הקול. כשלא נוגעים במחוונים, הרכיב משתמש בהגדרות השמורות של הקול עצמו, אותן הגדרות שבהן נוצרה הדוגמה שלו. כך התוצאה נשמעת כמו הדוגמה ששמעתם. כשמזיזים מחוון, רק הערך הזה משתנה, ושאר ההגדרות השמורות של הקול נשארות כמו שהן.
באפליקציה שפורסמה אפשר לחשוף את ההגדרות יציבות ודמיון כמחוונים. המחוונים מתחילים בערך של הרכיב עצמו, או ב-0.5 וב-0.75 כשאין לרכיב ערך. ElevenLabs v3 מתעלם מההגדרה דמיון.
מודלים
רכיב טקסט לדיבור יכול להריץ את חמשת מודלי הדיבור של ElevenLabs שבטבלה. לחצו על מודל כדי לראות את המחיר שלו בקרדיטים.
| מודל | יצרן | מצבים | קרדיטים | פרטים |
|---|---|---|---|---|
| ElevenLabs v4 | ElevenLabs | טקסט לדיבור | החל מ-5 | מודל הטקסט לדיבור החדש ביותר של ElevenLabs — תגיות אודיו בסוגריים מרובעים, שליטה ביציבות ובדמיון, עד 10,000 תווים לבקשה. API ישיר. |
| ElevenLabs v4 Turbo | ElevenLabs | טקסט לדיבור | החל מ-3 | ElevenLabs v4 מהיר וזול יותר, בנאמנות נמוכה יותר — תגיות אודיו בסוגריים מרובעים ושליטה ביציבות ובדמיון, במחיר הקרדיטים של Turbo. כשהאיכות חשובה, עדיף v4. API ישיר. |
| ElevenLabs v3 | ElevenLabs | טקסט לדיבור | החל מ-5 | טקסט לדיבור אקספרסיבי של ElevenLabs — תומך בתגיות אודיו בסוגריים מרובעים לרגש ולקצב. API ישיר. |
| ElevenLabs Turbo v2.5 | ElevenLabs | טקסט לדיבור | החל מ-3 | טקסט לדיבור מהיר וזול של ElevenLabs דרך ה-API הישיר של ElevenLabs. טוב לקריינות. |
| ElevenLabs Multilingual v2 | ElevenLabs | טקסט לדיבור | החל מ-5 | טקסט לדיבור רב־לשוני של ElevenLabs דרך ה-API הישיר של ElevenLabs. |
| מודל | שפות | תגי אודיו | רציפות | תווים בכל הרצה |
|---|---|---|---|---|
| ElevenLabs v4 (ברירת המחדל) | 46 | כן | כן | 10,000 |
| ElevenLabs v4 Turbo | 46 | כן | כן | 10,000 |
| ElevenLabs v3 | 46 | כן | לא | 5,000 |
| ElevenLabs Turbo v2.5 | 32 | לא, התגים מוסרים לפני ההקראה | כן | 40,000 |
| ElevenLabs Multilingual v2 | 29 | לא, התגים מוסרים לפני ההקראה | כן | 10,000 |
איזה מודל לבחור
- ElevenLabs v4 — ברירת המחדל. בחרו בו לדיבור אקספרסיבי, לתגי אודיו, לתמיכה הרחבה ביותר בשפות ולטקסטים של עד 10,000 תווים בכל הרצה. ההגדרות מהירות והדגשת סגנון לא זמינות בו.
- ElevenLabs v4 Turbo — מודל v4 עם אותם תגי אודיו ואותן הגדרות, מהיר וזול יותר, בנאמנות נמוכה יותר. בחרו בו לקריינות עם תגים בתקציב מוגבל, וב-v4 כשהאיכות חשובה.
- ElevenLabs v3 — המודל הקודם, עם אותם תגי אודיו ואותן שפות, עד 5,000 תווים בכל הרצה. רכיב שנשמר עם v3 ממשיך לרוץ על v3.
- ElevenLabs Turbo v2.5 — זול ומהיר יותר. בחרו בו לקריינות פשוטה ולטקסטים ארוכים, עד 40,000 תווים בכל הרצה.
- ElevenLabs Multilingual v2 — הגשה טבעית ב-29 שפות, עם עד 10,000 תווים בכל הרצה.
קול יכול להישמע שונה באופן מורגש ב-v4 לעומת v3, ולעיתים קרובות הוא יוצא שקט יותר. השוו בין שני המודלים עם הקול שלכם לפני שאתם מעבירים פרויקט גמור למודל החדש.
לסקירה של כל מודלי האודיו ב-Nodaro, ראו את המדריך בחירת מודל.
בחירת קול
בחלון בחירת הקולות יש שלוש לשוניות:
- מוכנים מראש — הקולות הסטנדרטיים של ElevenLabs.
- הקולות שלי — קולות מותאמים אישית שכבר יש לכם. כדי ליצור קול חדש מתיאור, השתמשו ברכיב עיצוב קול.
- ספריית הקולות — הספרייה המשותפת של ElevenLabs, עם חיפוש ומסננים לפי מבטא, גיל, שפה, תרחיש שימוש וטון.
לכל קול יש דוגמה שאפשר להשמיע לפני שבוחרים בו.
יוצרי הקולות בספריית הקולות מאמתים כל קול למודלים מסוימים. נניח שהרכיב מריץ את Turbo v2.5 או את Multilingual v2, ואתם בוחרים קול מהספרייה שלא אומת למודל הזה. הרכיב מחליף אז את ההגדרה מודל למודל שהקול אומת עבורו: קודם ElevenLabs v4, אחר כך v3, אחר כך v4 Turbo, ולבסוף מודל v2 הזול ביותר. ברכיב שמריץ את ElevenLabs v4, את v4 Turbo או את v3, בחירת קול אף פעם לא מחליפה את המודל.
הוספת רגש עם תגי אודיו
ElevenLabs v4, v4 Turbo ו-v3 מבינים תגי אודיו: הוראות קצרות בסוגריים מרובעים, שממוקמות בטקסט במקום שבו האפקט צריך לקרות. למשל: I can't believe it [laughs] that's amazing (אני לא מאמין [צוחק], זה מדהים).
| סוג | דוגמאות |
|---|---|
| רגשות | [excited] (נרגש), [sad] (עצוב), [angry] (כועס) |
| תגובות | [laughs] (צוחק), [sighs] (נאנח), [gasps] (מתנשף) |
| הגשה | [whispers] (לוחש), [shouting] (צועק) |
| קצב | [pause] (הפסקה), [long pause] (הפסקה ארוכה) |
| טון | [cheerfully] (בעליזות), [deadpan] (ביובש) |
| אפקטי קול | [applause] (מחיאות כפיים), [thunder] (רעם) |
מודלי v2 מסירים תגי אודיו לפני ההקראה, והטקסט שנשאר עלול להישמע לא טבעי. כדי להוסיף הפסקה במודל v2, השתמשו במקום זאת בתג break, כגון <break time="1.0s" />.
שמיעת ההבדל
שני הטייקים שלמטה נוצרו עם ElevenLabs v3 ועם הקול המוכן מראש Rachel. הראשון מקריא את הטקסט עם שני תגי אודיו; השני מקריא את אותן מילים בלעדיהם.
פרומפט מתורגם. המודל קיבל את המקור באנגלית, שמוצג למטה.
הפרומפט המקורי באנגלית
שפות
האפשרות זיהוי אוטומטי מתאימה לרוב הטקסטים. בטקסט שלא באנגלית, בחירה מפורשת של השפה יכולה לשפר את ההגייה.
- Multilingual v2 (29 שפות): אנגלית, יפנית, סינית, גרמנית, הינדית, צרפתית, קוריאנית, פורטוגזית, איטלקית, ספרדית, אינדונזית, הולנדית, טורקית, פיליפינית, פולנית, שוודית, בולגרית, רומנית, ערבית, צ׳כית, יוונית, פינית, קרואטית, מלאית, סלובקית, דנית, טמילית, אוקראינית ורוסית.
- Turbo v2.5 (32 שפות): כל השפות של Multilingual v2, ובנוסף הונגרית, נורווגית ווייטנאמית.
- v3, v4 ו-v4 Turbo (46 שפות): כל השפות של Turbo v2.5, ובנוסף עברית, תאית, בנגלית, אורדו, פרסית, סרבית, ליטאית, לטבית, אסטונית, גאורגית, איסלנדית, קטלאנית, אפריקאנס וסווהילית.
רציפות בין קליפים
קריינות שנוצרת קליפ אחר קליפ, למשל קליפ לכל שוט, מתחילה את האינטונציה מחדש בכל חיתוך. השדות טקסט קודם וטקסט הבא פותרים את הבעיה. בשדה טקסט קודם, הזינו את השורה שנאמרת ממש לפני הקליפ הזה, ובשדה טקסט הבא את השורה שנאמרת מיד אחריו. כך הקליפ ממשיך את הקליפ הקודם ומוביל אל הבא. המודל קורא את ההקשר הזה אבל לא מקריא אותו, ואורך הקליפ לא משתנה.
החלק רציפות מופיע, מכווץ, רק במודלים שמשתמשים בהקשר: ElevenLabs v4, v4 Turbo, Turbo v2.5 ו-Multilingual v2. ElevenLabs v3 לא משתמש בו, ומעבר של הרכיב ל-v3 מנקה את שני השדות. כל שדה מקבל עד 1,000 תווים. כשהטקסט הקודם ארוך מזה, נשמר הסוף שלו, וכשהטקסט הבא ארוך מזה, נשמרת ההתחלה שלו.
שני השדות יכולים לקבל טקסט מרכיב אחר דרך מיפוי שדות, למשל מרכיב טקסט שבו כתובה השורה של השוט הקודם. אפשר גם לחשוף את שניהם כקלטי טקסט של אפליקציה שפורסמה. ההקשר לא משנה את המחיר.
קרדיטים
המחיר נקבע לפי אורך הטקסט. הרצה מחויבת לפי כל 100 תווים, או חלק מהם, של הטקסט שהיא שולחת, עם מינימום של 8 יחידות בכל הרצה.
| מודל | קרדיטים לכל 100 תווים, או חלק מהם |
|---|---|
| ElevenLabs v4 | 5 |
| ElevenLabs v4 Turbo | 3 |
| ElevenLabs v3 | 5 |
| ElevenLabs Turbo v2.5 | 3 |
| ElevenLabs Multilingual v2 | 5 |
התווים שנספרים הם הטקסט שנשלח בפועל, כולל טקסט לפני ואחרי. טקסט שחורג מהמגבלה של המודל לא נספר, ו-Turbo v2.5 ו-Multilingual v2 לא סופרים את תגי האודיו שהם מסירים. הרכיב מציג את המחיר המדויק על הכפתור הרצה שלו לפני ההרצה. כשהטקסט מגיע מרכיב אחר, הכפתור מציג טווח, מהמינימום ועד מגבלת התווים של המודל.
באפליקציה שפורסמה אפשר לחשוף את השדה טקסט של הרכיב כקלט. ברשימת הקלטים של האפליקציה, הרחיבו את הרכיב, סמנו את התיבה טקסט, ואם אתם רוצים מגבלה, מלאו את השדה מספר תווים מרבי. האפליקציה דוחה אז טקסט ארוך יותר עוד לפני שמשהו רץ, והמחיר שהאפליקציה מציגה הוא המחיר של מספר התווים הזה. בלי מגבלה, המחיר של האפליקציה נקבע לפי מגבלת התווים של המודל. כשבהגדרה מקור הטקסט נבחרה האפשרות מרכיב מחובר, האפליקציה משתמשת בשדה טקסט שלה רק כשהטקסט המחובר ריק.
טיפים
- השאירו את היציבות סביב 0.5. הערך הזה מאזן בין הבעה לעקביות. לקריינות שצריכה להישמע אחידה, הזיזו אותו לכיוון 1.
- מקמו תגים במקום שבו האפקט קורה. תג באמצע משפט משנה את ההגשה בנקודה הזו.
- פצלו תסריטים ארוכים. ElevenLabs v3 מקבל 5,000 תווים בכל הרצה, ו-v4 מקבל 10,000. פצלו תסריט ארוך יותר בין כמה רכיבים ושמרו על הגשה רציפה בעזרת השדות טקסט קודם וטקסט הבא, או עברו ל-Turbo v2.5.
- מקמו את הקול בסצנה. קול יבש מעל סרטון יכול להישמע כאילו הוקלט במקום אחר. העבירו את הקול דרך רכיב אפקטי אודיו עם ריוורב כגון חדר (מקורה).
- אזנו את העוצמה של כמה קליפים. העבירו את הקליפים דרך רכיב כוונון עוצמה כשהתיבה נרמול מסומנת, כדי שכולם יתנגנו באותה עוצמה.
פתרון בעיות
ההרצה נכשלת עם שגיאת קול. הקול כבר לא קיים, למשל כי הוסר מספריית הקולות. בחרו קול אחר והריצו את הרכיב שוב.
ההרצה נדחית בגלל האורך, או שסוף הטקסט חסר. הטקסט ארוך מהמגבלה של המודל. הרצת תהליך דוחה טקסט כזה עוד לפני שנגבים קרדיטים, וההודעה מציינת את מספר התווים ואת המגבלה. בקשה ל-API, לעומת זאת, חותכת את הטקסט כשהוא מגיע למגבלה. פצלו את הטקסט, או עברו ל-ElevenLabs Turbo v2.5.
מילים בסוגריים חסרות, או שהטקסט נשמע מוזר. השתמשתם בתגי אודיו עם מודל v2, שמסיר אותם. בהגדרה מודל, עברו ל-ElevenLabs v4, ל-v4 Turbo או ל-v3, או הסירו את התגים.
דרך ה-API
הנתיב POST /v1/text-to-speech מריץ את אותו רכיב דרך קוד. כשבקשה לא כוללת provider, Nodaro בוחר מודל לפי האורך. טקסט של עד 10,000 תווים רץ על ElevenLabs v4, וטקסט ארוך יותר רץ על Turbo v2.5, כך שטקסט ארוך אף פעם לא מקוצר למגבלה של v4. הבקשה מחויבת לפי המודל שהיא רצה עליו. Nodaro תמיד משתמש בערך provider שאתם קובעים כמו שהוא: ציינו elevenlabs-v3 כדי לשמור על הקול של v3.
הבקשה מקבלת את previousText ואת nextText לרציפות. עם withTimestamps: true, ב-output_data.transcript של המשימה שהסתיימה נמצא גם התזמון של כל מילה (words[] עם startMs ו-endMs), בלי קרדיטים נוספים. הגדרת קול שחורגת מהטווח, או מספר שנשלח כטקסט, נדחים עם 400.
כלי ה-MCP generate_speech רץ על ElevenLabs v4 כשלא מצוין מודל. הכלי מקבל עד 10,000 תווים, ודוחה טקסט שארוך מהמגבלה של המודל שנבחר במקום לחתוך אותו. מזהה קול לא מוכר בפורמט של ElevenLabs (20 אותיות וספרות) מוחלף ב-Rachel, כדי שהעוזר יקבל אודיו בכל זאת. בקשה עם שם קול לא מוכר נכשלת, וכך גם בקשה עם קול library או custom שלא קיים. ב-REST API אין החלפה כזו: בקשה לנתיב POST /v1/text-to-speech עם קול לא מוכר נכשלת. ראו את דף ה-API קול ומדיה ואת מדריך כלי ה-MCP.
שאלות נפוצות
איזה מודל לבחור ברכיב טקסט לדיבור?
התחילו מ-ElevenLabs v4, ברירת המחדל של רכיב טקסט לדיבור. המודל מדבר 46 שפות, מבין תגי אודיו לרגש ולקצב, ומקבל עד 10,000 תווים בכל הרצה. השתמשו ב-ElevenLabs v4 Turbo לקריינות עם תגים במחיר נמוך יותר, וב-Turbo v2.5 לטקסטים ארוכים מאוד, כי הוא מקבל עד 40,000 תווים בכל הרצה.
מה האורך המרבי של הטקסט?
ברכיב טקסט לדיבור, ElevenLabs v4, v4 Turbo ו-Multilingual v2 מקריאים עד 10,000 תווים בכל הרצה, v3 עד 5,000 ו-Turbo v2.5 עד 40,000. הרצת תהליך דוחה טקסט ארוך יותר עוד לפני שנגבים קרדיטים, וחלונית ההגדרות מזהירה אתכם קודם. דרך ה-API, טקסט ארוך יותר נחתך כשהוא מגיע למגבלה.
איך גורמים לקול לצחוק, ללחוש או לעשות הפסקה?
ברכיב טקסט לדיבור עם ElevenLabs v4, v4 Turbo או v3, כתבו תג אודיו בסוגריים מרובעים במקום שבו האפקט צריך לקרות, למשל "I can't believe it [laughs] that's amazing" (אני לא מאמין [צוחק], זה מדהים). מודלי v2 מסירים תגי אודיו לפני ההקראה.
כמה קרדיטים עולה רכיב טקסט לדיבור?
המחיר של רכיב טקסט לדיבור נקבע לפי אורך הטקסט. כל 100 תווים, או חלק מהם, עולים מספר קבוע של קרדיטים, עם מינימום של 8 יחידות בכל הרצה. ElevenLabs v4 Turbo ו-Turbo v2.5 זולים יותר ליחידה מ-v4, מ-v3 ומ-Multilingual v2, והרכיב מציג את המחיר המדויק לפני שהוא רץ.
האם אפשר להשתמש בקול שלי?
קולות מותאמים אישית שכבר יש לכם מופיעים בלשונית הקולות שלי, בחלון בחירת הקולות של רכיב טקסט לדיבור. כדי ליצור קול מותאם אישית חדש מתיאור כתוב, השתמשו ברכיב עיצוב קול.
מה קורה אם הקול שבחרתי נמחק?
ההרצה של רכיב טקסט לדיבור נכשלת עם שגיאה ברורה. Nodaro אף פעם לא מחליף את הקול בקול אחר בלי להודיע לכם, ולכן בחרו קול אחר והריצו את הרכיב שוב.
דפים קשורים
טקסט לדיאלוג
עיצוב קול
סנכרון שפתיים
אפקטי אודיו
ElevenLabs v4
עודכן לאחרונה